Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月16日(水)のニュース一覧へ引用元:NVIDIA公式ブログ

NVIDIA、次世代Vera Rubinの電力最適化技術発表
NVIDIA
インフラ
ハードウェア
半導体
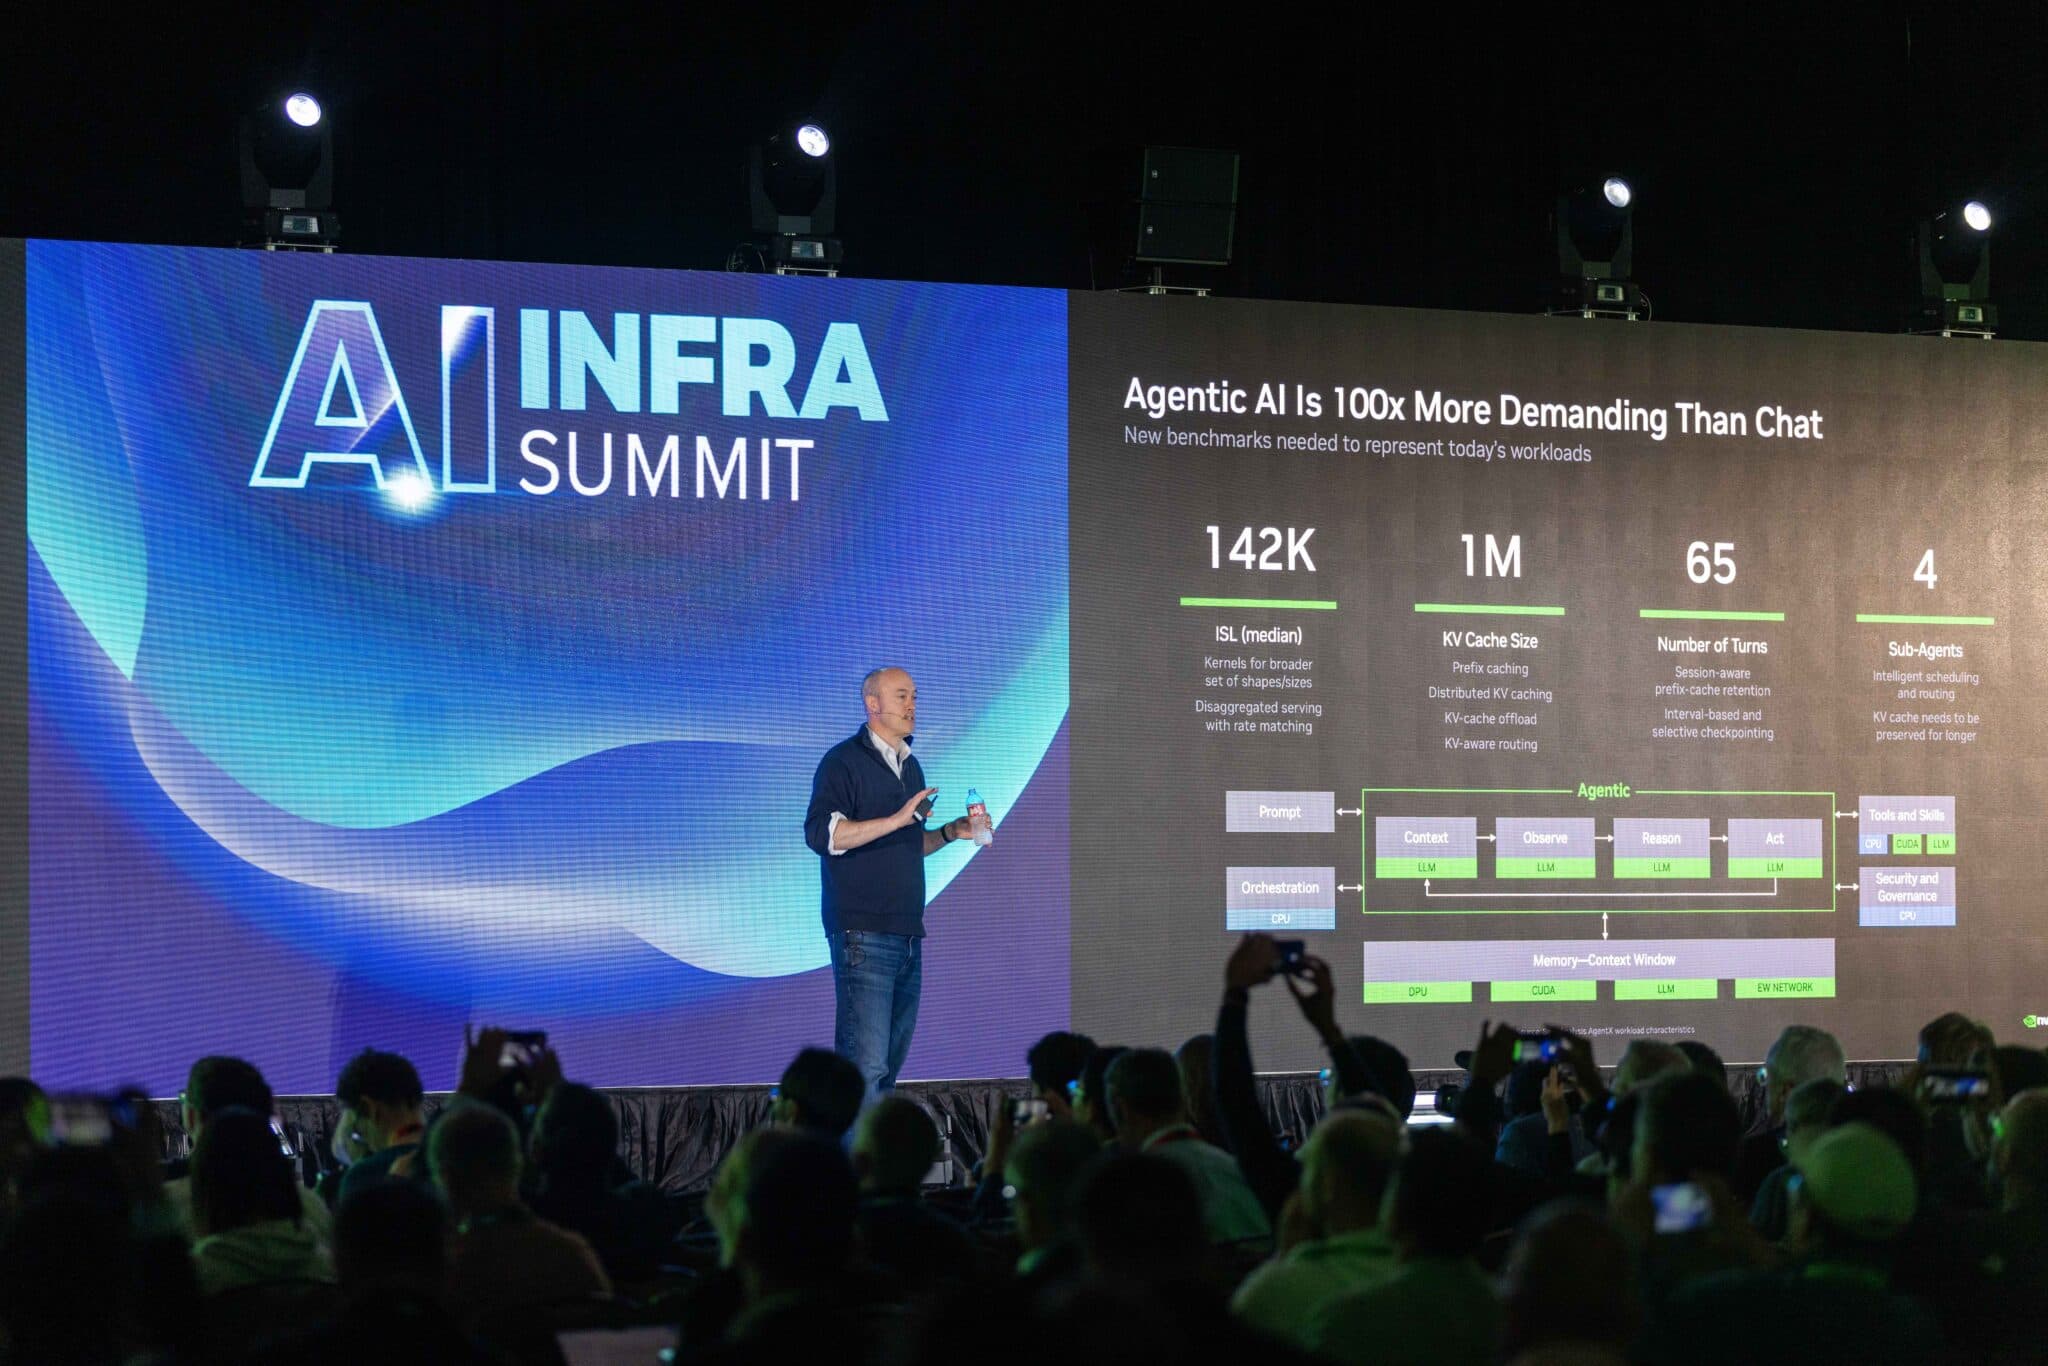
米NVIDIAは米サンタクララで開催された「AI Infra Summit」において、次世代AIファクトリー向けアーキテクチャ「Vera Rubin NVL72(NVIDIAの次世代ハイパースケールAI計算ラック基盤)」および電力最適化ソフトウェア「NVIDIA DSX Platform」の最新成果を発表しました。データセンターの供給電力が逼迫する中、指標を単なるピーク性能から「1ワットあたりの生成トークン数(Tokens Per Watt)」へ転換し、電力網から半導体までの包括的な最適化を提案しています。
DSX MaxLPSによる動的電力配分と実証データ
NVIDIAが発表した「DSX MaxLPS」は、GPUやラック間の電力消費をリアルタイムで監視し、学習や推論など負荷プロファイルの異なるワークロード間で電力を動的に融通するソフトウェアです。従来の静的プロビジョニングで放置されていた余剰マージンを有効活用します。
AIクラウド大手のLambda社による検証結果では、通常16ノード分の電力枠内で19ノードを安定稼働させることに成功。クラスタ全体のトークンスループットを24%(秒間約400万トークンから500万トークンへ)向上させ、電力あたり性能を23%改善しました。
次世代のVera Rubin NVL72環境において、DSX MaxLPSを導入することで同一メガワット枠内に最大40%多くのGPUを収容可能となり、新たな送電網増設なしに最大35%高いトークン生産量を達成できるとしています。
| 導入基盤・構成 | 比較対象 | 達成された効率・性能向上 |
|---|---|---|
| Lambda実証(Blackwell) | 静的電力配分(16ノード枠) | ノード数+19%、トークンスループット+24%、電力あたり性能+23% |
| Vera Rubin NVL72 + Groq 3 LPX | GB200 NVL72(2兆パラメータ・100K長文脈) | メガワットあたりトークンスループットが最大35倍 |
| SemiAnalysis AgentX検証 | GB300 NVL72(DeepSeek V4 Pro実エージェント) | メガワットあたりスループットが最大30倍 |
また、超低遅延推論チップ「Groq 3 LPX」とVera Rubinの統合により、10万トークンの長文脈処理(Qwen 3.8 27B)においてユーザーあたり秒間2,529出力トークンを記録しました。
AIファクトリーと電力網の協調および未確認事項
サミットでは、電力会社Silicon Valley Powerおよびパートナー企業Emerald AIとの共同実証も公開されました。電力網からのデマンドレスポンス(需要調整)信号を受け取り、優先度の低いAIバッチ処理を自律的に一時絞り込む「DSX Flex」の稼働が実証されています。
日本の電力事情においても、データセンターの新設に伴う受電容量不足が大きなボトルネックとなっていますが、受電設備を増設せずにトークン出力を2割以上引き上げるソフトウェア最適化は、国内インフラ運用者にとっても極めて現実的な解決策となり得ます。
未確認事項として、Vera Rubin NVL72およびGroq 3 LPXコンポーネントの一般出荷開始時期やラック単位の導入価格、既存の空冷データセンターでの改修要件については今後の詳細発表が待たれます。
計算インフラの主戦場は「電力効率」へ
AIモデルがエージェント化し多段階推論を繰り返すようになったことで、推論にかかる消費電力は爆発的に増加しています。NVIDIAが半導体単体にとどまらず、ラック内バッファリングや送電網連携まで垂直統合したシステムを提供する背景には、電力供給上限がそのままAI産業の成長上限になるという強い危機感があるとみられます。
引用元:NVIDIA Blog | NVIDIA Blog | Wccftech
参考ソース
NVIDIA Blog
AI Infra Summit: NVIDIA Vera Rubin and DSX Platform Advancements Showcase Energy Efficiencies of Optimizing Tokens Per Watt for AI Factories
Ian Buck, vice president of hyperscale and high-performance computing at NVIDIA, Tuesday spoke on AI factory efficiency at the AI Infra Summit, the Santa Clara Convention Center event that has morphed into a Coachella of infrastructure tech. Before a packed audience — with more than 8,000 attendees this year, up from 3,500 last year — […]
https://blogs.nvidia.com/blog/ai-infra-summit-vera-rubin-dsx-energy-efficiencies-tokens-per-watt-ai-factories
NVIDIA Blog
From Megawatts to Tokens: How NVIDIA Maximizes AI Factory Production
On a sweltering August evening in Silicon Valley, as the sun dropped and air conditioning loads spiked, Silicon Valley Power sent a signal to an AI factory to adjust its power consumption. Varun Sivaram was watching on Zoom with about forty others — his team at Emerald AI in their San Francisco conference room, engineers […]
https://blogs.nvidia.com/blog/from-megawatts-to-tokens-how-nvidia-maximizes-ai-factory-production
Wccftech
NVIDIA's DSX Architecture Targets High-Efficiency AI Deployments With MAXLPS
NVIDIA showcased its energy efficiency optimizations that have been featured on Vera Rubin platforms for increased token throughput.
https://wccftech.com/nvidia-dsx-maxlps-drives-more-token-throughput-per-megawatt


