Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月23日(金)のニュース一覧へ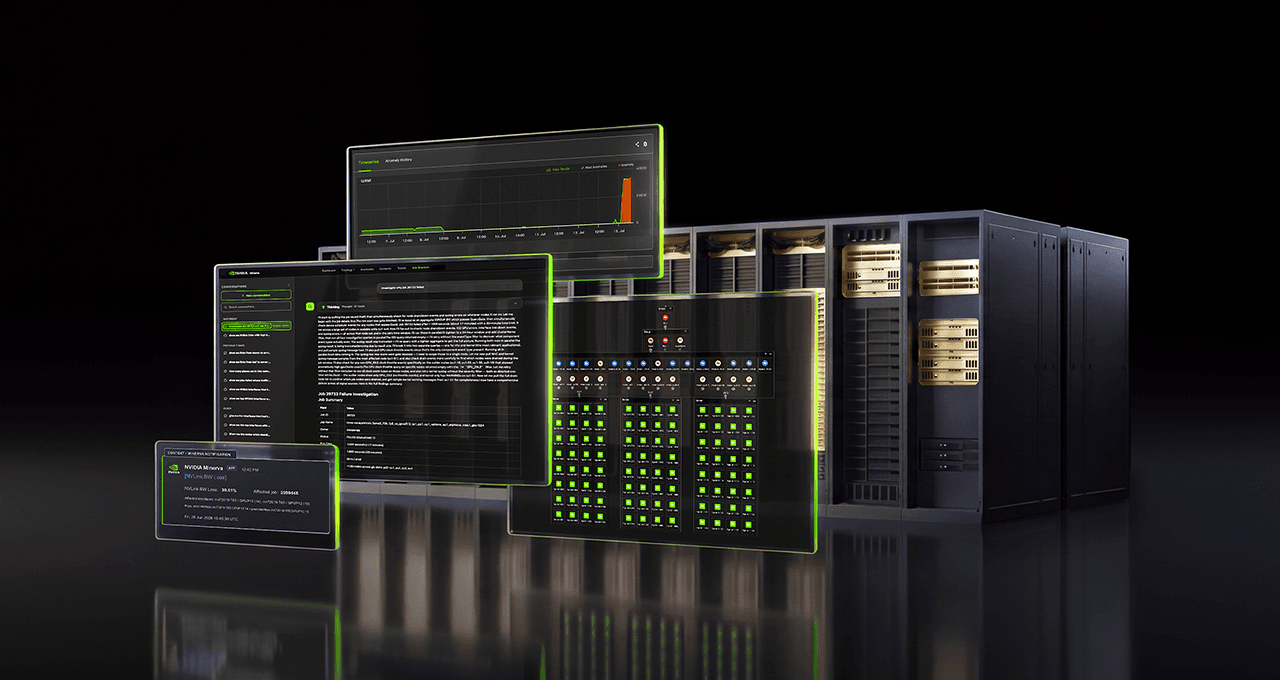
NVIDIA、AI工場向けAIOps基盤「Minerva」発表
NVIDIA
インフラ
エンタープライズ
クラウドコンピューティング
AIエージェント
NVIDIAは、大規模なGPUクラスタを備えたAI工場(AIデータセンター)の運用において、インフラとAIワークロードの双方から得られるテレメトリ(稼働データの遠隔収集)を統合監視するAIOps(AIを活用してIT運用の監視や障害検知を自動化・効率化する技術)プラットフォーム「NVIDIA Minerva(GPUやネットワーク、ストレージのテレメトリを統合しAIで障害予測を行う監視基盤)」を発表した。
数十万基規模のGPUが稼働するAIインフラでは、1基のコンポーネントの性能低下がトレーニングジョブ全体の遅延を引き起こす。Minervaは専用のAIモデルと動的ナレッジグラフを活用し、障害の早期特定や予兆検知を実現することで、クラスタの稼働率(アップタイム)と歩留まり(イールド)を最大化する。
インフラとワークロードをつなぐ動的ナレッジグラフ
従来のデータセンター監視ツールは、ネットワーク、コンピュート(計算資源)、SRE(サイト信頼性エンジニアリング)、機械学習エンジニアリングなど、チームごとに独立した断片的なダッシュボードに依存していた。
Minervaは、NVIDIA GPU、SuperNIC、ネットワークスイッチ、光ケーブルなどの物理インフラと、その上で実行されているAIワークロードの信号を網羅的に接続する。
- 動的トポロジーマッピング: クラスタ全体のハードウェア構成と実行中ジョブの依存関係を論理マップ化した動的ナレッジグラフを自動構築する。
- 毎時数十億データポイントのML分析: 教師あり・教師なし機械学習アルゴリズムを併用し、正常時のベースライン挙動を学習。未知の異常や将来的な障害予兆を事前に検知する。
- アラートストームの集約: 障害発生時に大量発生する警告通知(アラートストーム)をトポロジーに基づいて相関分析し、根本原因と推定される単一のインシデントに集約して提示する。
- 自律エージェントと自然言語対話: 自然言語でクラスタの健全性を調査し、推奨される修復アクションを対話形式で提案するネイティブAIアシスタントを搭載。外部のエージェント型AIツールともAPI連携が可能である。
クラウド事業者からサーバーOEMまで広範なエコシステムが採用
本プラットフォームは、GPUの生産性向上に直結する指標(障害間平均時間の延伸、平均復旧時間の短縮、アラート精度の向上)を提供するため、世界中の大規模AIインフラ事業者が導入を表明している。
エネルギー効率の高いデータセンターを運用するIRENの最高技術責任者(CTO)Denis Skrinnikoff氏は、「GPU生産性の最大化はお客様に最適なサービスを提供する鍵となる。Minervaにより、ネットワーク、GPU、実行ジョブを一元的に把握でき、障害対応から予防的メンテナンスへ移行できる」と評価している。
IRENのほか、Tesla、IBM、Lambda、Bitdeer AI、Jio、Quake AI、AolaniがMinervaの配備を計画している。またハードウェアOEMでは、Dell Technologiesに加え、LenovoおよびSupermicroが自社のAI工場運用ポートフォリオにMinervaを組み込んで提供する。
日本の事業者への影響と未確認事項
日本国内においても、さくらインターネットやソフトバンクなどによる数千〜数万基規模のGPUクラスタ構築が急速に進んでいる。超大規模クラスタでは、ハードウェア故障や通信劣化によるジョブ停止(チェックポイントからのやり直し)が莫大な経済的損失につながるため、テレメトリ統合監視基盤の需要は極めて高い。
ただし、Minervaの導入形態(オンプレミス配備可能なソフトウェアライセンスなのか、特定クラウド経由の提供なのか)やライセンス価格体系、既存世代(Hopper世代等)のクラスタに対する適用可否についての詳細な提供条件は今回の発表では未公表である。導入を検討する国内事業者にとっては、既存の監視エコシステム(PrometheusやDatadog等)との併用要件を含めた詳細情報の開示が待たれる。
ハードウェアから運用自律化へ広がるフルスタック戦略
NVIDIAはGPUやネットワークといった物理ハードウェアの供給にとどまらず、CUDAなどの開発環境、さらにはデータセンター全体の運用・保守を自律化するソフトウェア層へと影響力を拡大している。AIインフラが巨大化し人間による手動監視の限界を迎えるなか、AIOpsをプラットフォーム標準として提供することで、AIデータセンターの運用基盤における競争優位をさらに確固たるものにするとみられる。
参考ソース
NVIDIA Blog
NVIDIA Unveils Minerva to Bring End-to-End Observability for AI Factories
New AIOps platform connects infrastructure and workload telemetry to help operators increase uptime and maximize AI factory yield.
https://blogs.nvidia.com/blog/minerva-platform-infrastructure
NVIDIA Technical Blog
How NVIDIA Minerva Turns Telemetry Chaos Into Peak GPU Yield
AI Factories are some of the most technologically complex operational environments ever created. Hundreds of thousands of GPUs, NVIDIA Spectrum-X Ethernet scale-out, scale-across and scale-in fabrics…
https://developer.nvidia.com/blog/how-nvidia-minerva-turns-telemetry-chaos-into-peak-gpu-yield


