Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月1日(木)のニュース一覧へ
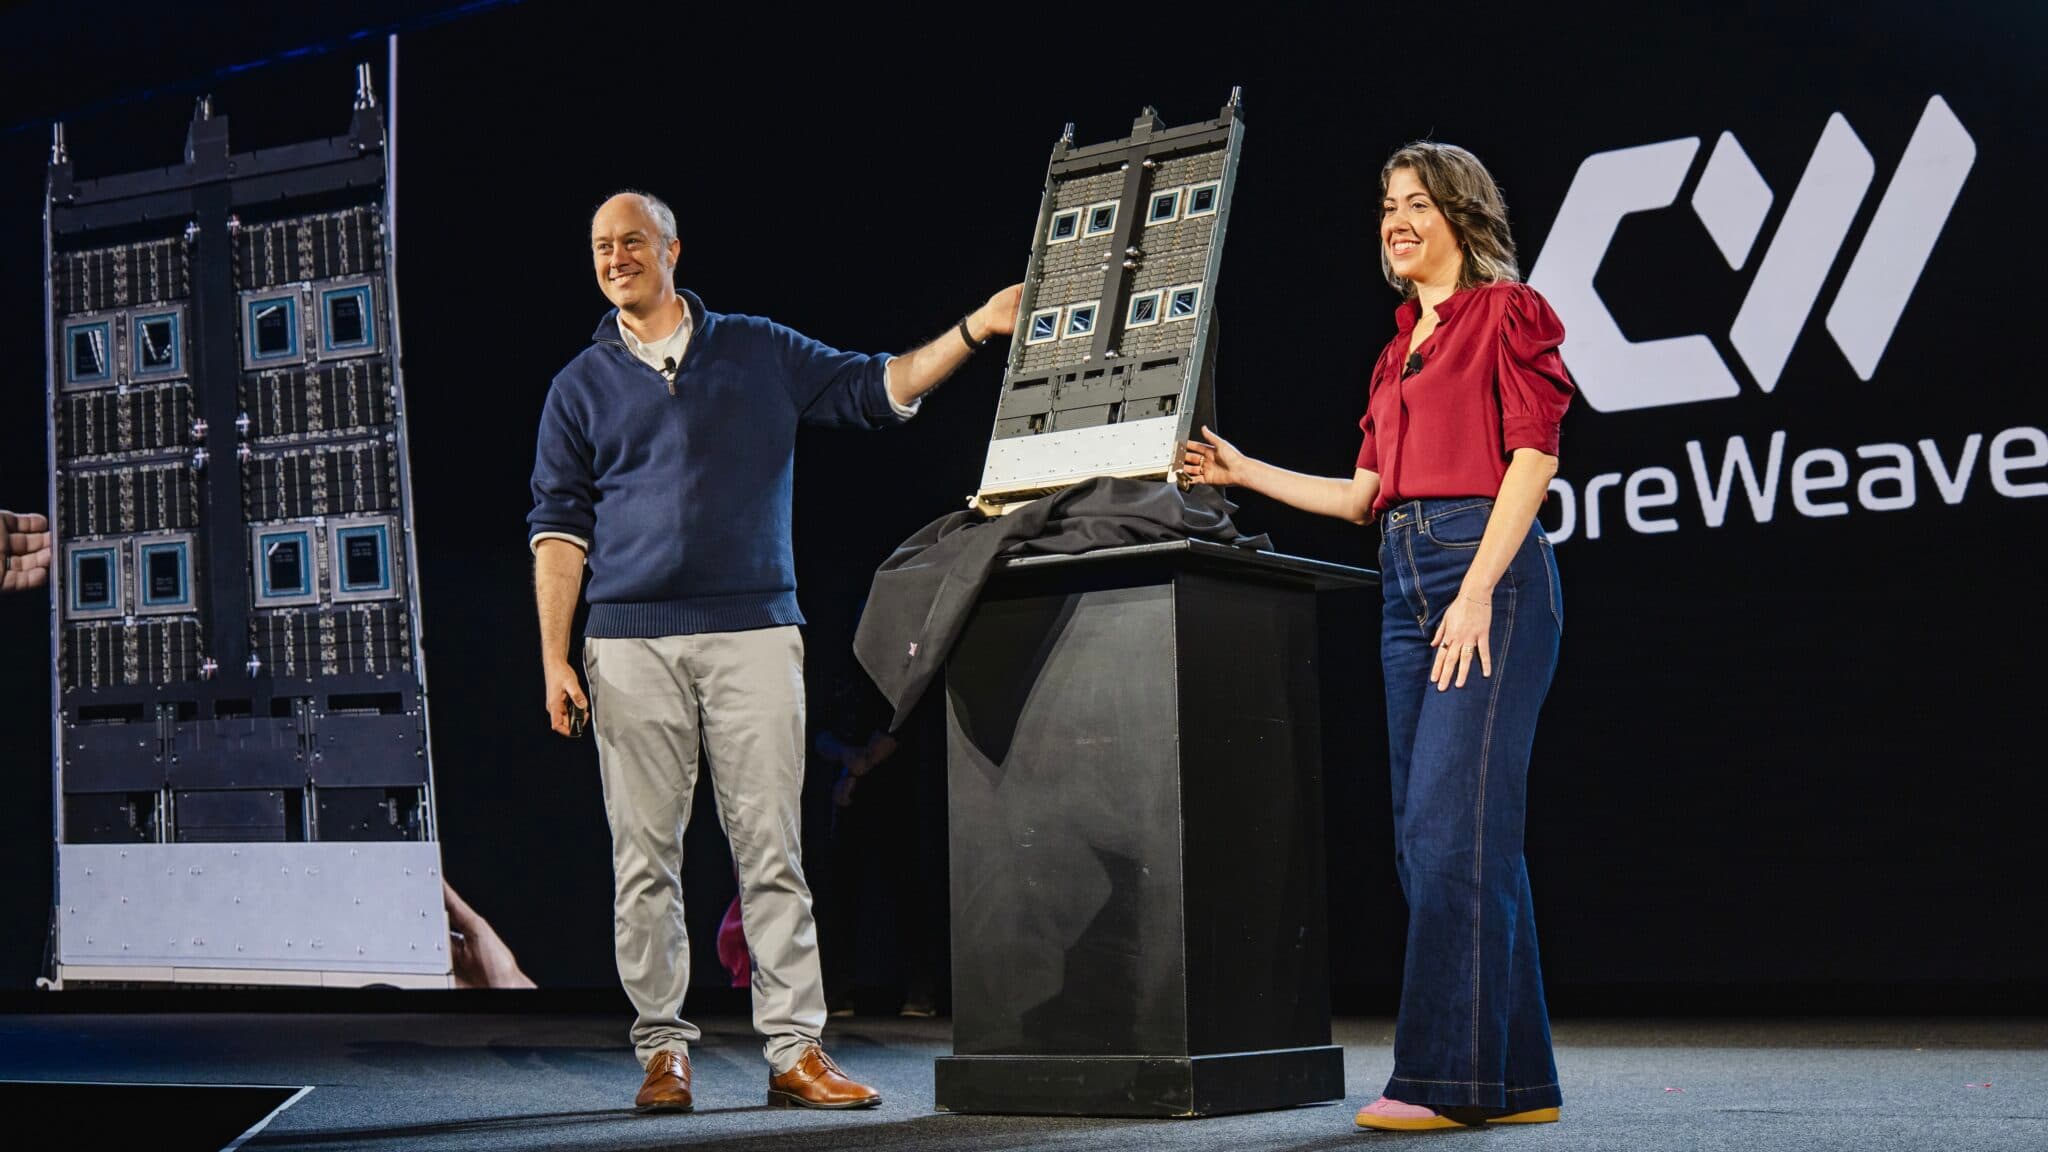
CoreWeave、Vera Rubin NVL72本番提供を開始
NVIDIA
CoreWeave
AIエージェント
インフラ
ハードウェア
クラウドコンピューティング
AIクラウドプロバイダーの米CoreWeaveは、サンフランシスコで開催された年次カンファレンス「CoreWeave Fully Connected」にて、次世代AIインフラストラクチャ「NVIDIA Vera Rubin NVL72(NVIDIAの次世代GPUアーキテクチャRubinを採用したラック規模のAI基盤)」システムの本番環境での提供を開始したと発表した。自律型AIソフトウェアエンジニア「Devin」を開発する米Cognitionが最初の顧客として同基盤上で本番ワークロードの稼働を始めている。さらに、AIエージェントの実行に特化した「NVIDIA Vera CPU」の導入計画や、開発・評価ループを加速する新環境「CoreWeave Forge」の一般提供もあわせて公表された。
CognitionのDevin、GB200比で推論スループットが最大4.8倍に向上
CoreWeaveは今月上旬にVera Rubin NVL72の最初の本番用ラックを受領し、数日間でCognition向けの本番クラスタを立ち上げた。システムにはSpectrum-X 102.4T Ethernetネットワーキングが採用されている。
Cognitionは、ベンチマーク「FrontierCode」からサンプリングした実際のソフトウェア開発タスクを用い、前世代の「GB200 NVL72」をベースラインとした推論性能テストを実施。その結果、SWE-2推論ワークロードにおいて、最大4.8倍のトータルトークンスループット向上を記録した。長文脈の処理や高度な並行性、多段階の推論を要するコーディングエージェントにおいて、レスポンスの高速化とトークンあたりの運用コスト削減に大きく寄与する。
エージェント実行に特化した「NVIDIA Vera CPU」と「CoreWeave Forge」
AIエージェントの運用では、モデル自体の推論計算だけでなく、強化学習(RL)やツール実行のために数千単位の隔離環境(サンドボックス)を低遅延で同時起動することが求められる。CoreWeaveが導入するNVIDIA Vera CPU(AIエージェントの隔離環境実行向けに設計された専用CPU)は、1ラックに128基のCPU・11,264コアを集約し、ラックあたり11,000以上の独立環境を同時にホスト可能だ。社内テストでは以下の改善が確認されている。
- サンドボックス起動速度: 従来の実行環境と比較して3倍以上高速化
- エージェント性能: ベンチマーク「Terminal-Bench」の通過タスク全体で1.7倍の性能向上
- 通信・分離: BlueField-4 DPUとSpectrum-Xスイッチにより、強化学習ジョブと並行してセキュアな低遅延通信を維持
あわせて発表された開発環境「CoreWeave Forge」では、Weights & Biases、OpenPipe、marimo notebookが統合された。自律分析ツールの「CoreWeave ARIA」、エージェントの障害検出率を20%改善する可観測性サービス「CoreWeave Agent Lens」、隔離実行基盤「CoreWeave Sandboxes」が一般提供(GA)されたほか、サーバーレス強化学習(Serverless RL)ではセルフマネージド環境比で1.4倍の高速化と40%のコスト削減を達成している。
インフラ性能比較とエージェント開発への影響
自律型AIエージェント向けインフラとしての進化点は以下の通りである。
| 項目 | 前世代(GB200 NVL72) | 新世代(Vera Rubin NVL72 / Vera CPU) |
|---|---|---|
| 主な想定用途 | LLMの事前学習・汎用推論 | 自律型AIエージェントの並行推論・強化学習 |
| 推論スループット (SWE-2) | 基準(1.0x) | 最大4.8倍(Cognitionベンチマーク) |
| サンドボックス起動時間 | 基準 | 3倍以上高速化(Vera CPU環境) |
| ラック収容環境数 | - | 1ラックあたり11,000以上の独立コア環境 |
| ネットワーク基盤 | 従来型InfiniBand/Ethernet | Spectrum-X 102.4T Ethernet + BlueField-4 DPU |
未確認事項と読者への影響
現時点でVera Rubin NVL72の提供はCoreWeave Cloudの早期アクセス顧客(アーリーアクセス)向けとなっており、一般ユーザーへの提供時期や従量課金体系、日本国内拠点からのアクセスレイテンシは未公表である。ただし、Canva、Capital One、MasterClass、医療AIのEnnoble Careなどが既にプラットフォームの採用を進めている。
自社でAIエージェントやコーディング支援基盤を運用する日本の開発者にとって、推論スループットが4.8倍、環境起動が3倍高速化することは、エージェント運用の最大課題であった「レイテンシ遅延」と「トークンコストの高騰」を同時に解決する選択肢となる。
分析・展望:AIインフラの主戦場は「エージェント推論とサンドボックス並行度」へ
これまでのAIインフラ競争は、主に基底モデルの事前学習におけるGPUクラスタ規模やFLOPS値が焦点であった。しかし、自律型エージェントの実用フェーズに入ったことで、要件は「数万の隔離サンドボックスを瞬時に立ち上げ、リアルタイム推論と強化学習ループを回し続けること」へとシフトしている。
CoreWeaveがGPU(Rubin)だけでなくCPU(Vera)と隔離基盤(Forge/Sandboxes)を包括して提供し始めたことは、エージェント専用クラウド基盤という新たなカテゴリの確立を象徴している。今後、メガクラウド(AWS、Azure、Google Cloud)との間でも、エージェント実行効率を巡るインフラ刷新競争が一層加速するとみられる。
引用元:NVIDIA Blog | Wccftech
参考ソース
NVIDIA Blog
From Training to Production, NVIDIA and CoreWeave Close the Loop on Agentic AI
NVIDIA Vera Rubin NVL72 and Vera CPU on CoreWeave accelerate agentic AI for companies including Cognition, extending a nearly decade-long run on NVIDIA infrastructure that stays productive, durable and fungible across generations.
https://blogs.nvidia.com/blog/coreweave-agentic-ai-vera-rubin
Wccftech
CoreWeave Deploys NVIDIA Vera Rubin NVL72 In Cloud, Up To 4.8x Token Generation
NVIDIA & CoreWeave are now offering Vera Rubin NVL72 & Vera-standalone in the cloud, taking the fastest AI platform into full production.
https://wccftech.com/coreweave-deploys-nvidia-vera-rubin-nvl72-in-cloud-up-to-4-8x-token-generation

