Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月2日(水)のニュース一覧へ引用元:Google
Google、Geminiに対話型動画理解機能を追加
Google
Gemini
マルチモーダル
AIエージェント
API
米Google(米国の検索・テクノロジー大手企業)は2026年9月2日、最新の大規模マルチモーダルモデル群(Gemini 3.7 Flash、3.6 Flash、3.5 Flash-Lite)において、動画処理を自律的に最適化する「エージェント型動画理解(AIが動画内の必要な部分を動的に探索・精査する処理方式)(Agentic Video Understanding)」の提供を開始した。
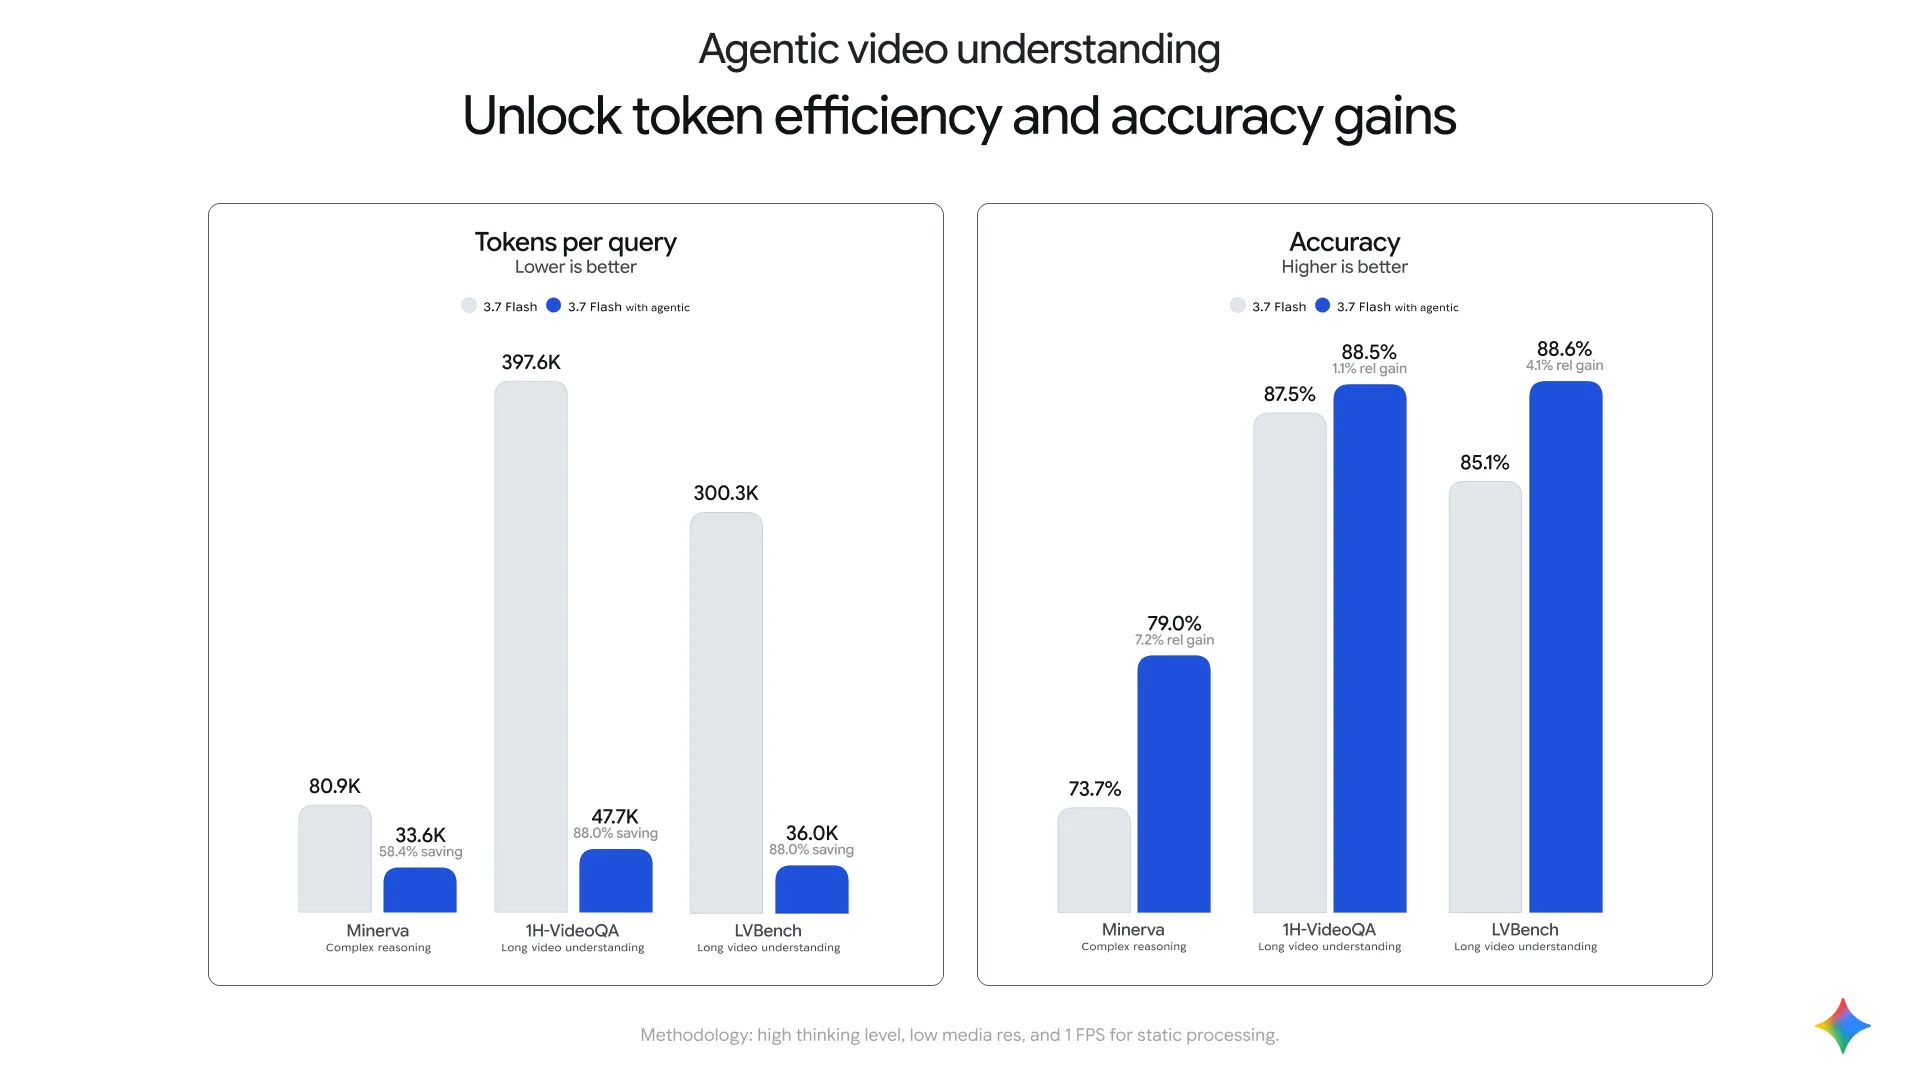
動的な探索ループによりトークン消費を最大88%削減
従来の動画処理では、動画全体を固定のフレームレート(既定では1秒あたり1フレーム / 1 FPS)で一律に読み込む「静的処理」が主流であった。これに対し、エージェント型動画理解では、モデルが自律的な探索ループを通じて内部ツールを呼び出し、必要なシーンのフレーム、音声、文字起こしを能動的にスキャン・精査する。
Googleの発表による主な性能向上と特徴は以下のとおりである。
- 効率性と精度の両立: 標準的な動画分析ベンチマークにおいて、トークン消費量を最大88%削減、分析コストを最大66%削減しながら、精度を最大7%向上させた。
- 長尺動画での高い効果: 10分のチュートリアル動画から数時間の講義・会議録画まで、長尺コンテンツの解析においてコストと情報欠落のジレンマを解消する。
- 1秒未満の瞬間特定: 固定FPSでは見落としがちな瞬時の画面変化やカットの境界を特定する「サブセカンド・モーメント検索」が可能。
- 高速動作のカウントと異常検知: 必要に応じて局所的にフレームレートを引き上げて再検証することで、素早い動作の回数計測や微細な視覚的異常の検出に対応する。
提供プラットフォームと今後の展開
本機能はGoogle AI StudioのGemini APIおよびGemini Enterprise Agent Platformを通じて即日利用可能となった。追加の機能利用料は発生せず、通常のAPIトークン従量課金が適用される。
さらにGoogleは、本機能を一般ユーザー向けのGeminiアプリ(FlashおよびFlash-Liteモデル)へ近日展開するほか、今後数か月以内にYouTubeの視聴ページ上にあるAI対話機能「Ask YouTube」の基盤にも統合する計画を明らかにした。
分析・展望
動画データを丸ごとLLMのコンテキストウィンドウに流し込む従来のアプローチは、コストと計算負荷の面で実用上の大きな制約となっていた。動画を「道具を使って調べる対象」としてエージェント的に処理する今回のアーキテクチャは、マルチモーダルAIの実用化と低コスト化を大きく加速させるパラダイムシフトといえる。
引用元:Google


