Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年6月12日(金)のニュース一覧へ
Anthropic、Claude隠し制限を撤回し謝罪
Anthropic
Claude
Claude Fable
AI安全性
規制・政策
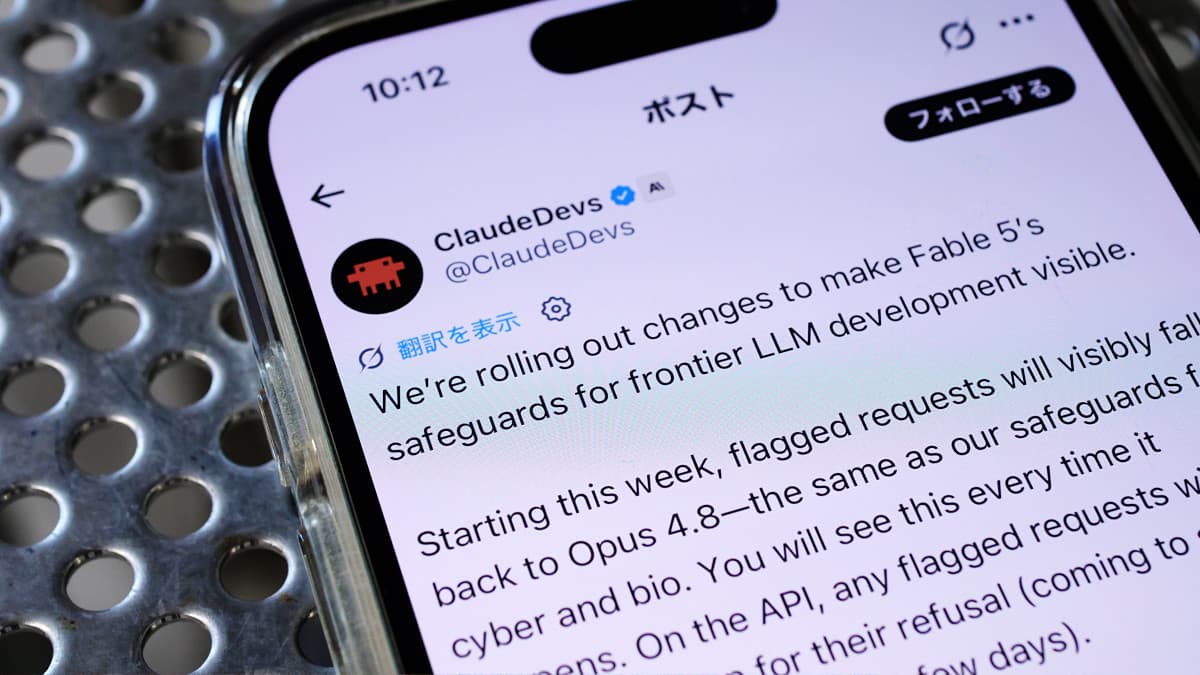
米AIスタートアップのAnthropic(アンソロピック)は、同社が2026年6月9日に公開した最新AIモデル「Claude Fable 5」において、他社モデルのトレーニングといった競合AI開発に使用された際、ユーザーへ知らせずに意図的に性能を低下させていたポリシーを撤回し、公式X(旧Twitter)で謝罪しました。今後は、制限を適用する前にユーザーへ警告を明示する仕様に変更されます。同社は「安全性と利便性のトレードオフ(両立が難しい状況で一方を優先すること)の選択を誤った」と釈明しています。
1. ユーザーへの事前告知なきモデル切り替え
Claude Fable 5のリリース後、AI研究者らの間で不審な動作が報告されていました。他社の大規模言語モデル(人間のように自然な文章を生成するAI)の学習や、AIコードの最適化などのリクエストを行うと、システム側が検知して、事前の通知なしに低性能な旧モデル「Claude Opus 4.8」へとリダイレクト(別のページやモデルに処理を自動転送すること)されていました。仕様書にはこの制限が記載されていましたが、一般のドキュメントには明記されていなかったため、検証作業で多額の費用を支払った研究者から「研究活動が隠れて妨害された」として激しい非難が上がりました。
2. 過剰な制限検知による誤判定の多発
さらに、この機能はセーフガード(安全対策)として非常に厳格に設計されており、全セッションの約5%が危険と分類されていました。このため、「Hello」という無害な挨拶や、バイオ医学研究者が入力した「Cancer(がん)」という単語に対しても、他社モデルの開発中であると誤検知されて処理が制限される事例が相次ぎ、ユーザーの不満を増大させました。
3. 表示型のセーフガードへの移行と釈明
批判を受けてAnthropicは2026年6月11日に声明を発表し、他社AIモデルの開発と判断されたリクエストについては、無断で性能制限を行うのを止め、制限理由を明示して拒否するか、明示的に旧モデルへ移行する仕様に切り替えることを明らかにしました。同社は、隠蔽していた理由について「安全かつ迅速にリリースするための一時的な措置だったが、ユーザーに明示的な警告を表示するべきだった」と認めています。
今回の隠し制限問題は、倫理的で研究者寄りの姿勢を強調してきたAnthropicのブランドイメージに大きな影響を与えたとみられます。同社は「目に見える安全対策」へと方針転換したものの、これによって対策をすり抜ける jailbreak(ジェイルブレイク。AIの安全制限を解除すること)が増加する恐れがあり、当面は誤判定を減らしつつ防御力を維持するためのフィルタの調整が必要になると考えられます。
参考ソース
Engadget
研究者の活動を妨害したポリシーをAnthropicが撤回 - Engadget
Anthropic is walking back a hidden policy that researchers say sabotaged their work.
https://www.engadget.com/2192004/anthropic-walks-back-policy-sabotaging-research
GIGAZINE
Anthropic has issued an official statement regarding the 'silent nerf to Claude Fable 5,' stating that they will improve the model's weakening for AI research purposes. - gigazine.net
Anthropic released its high-performance AI,
https://gigazine.net/gsc_news/en/20260612-claude-fable-5-safeguard-change


