Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年6月6日(土)のニュース一覧へ
引用元:Analytics DeepLearning.AI
アリババ新LLM「Qwen3.7-Max」、米国勢に肉薄
Alibaba
Qwen
LLM
推論
AIエージェント
オープンソース
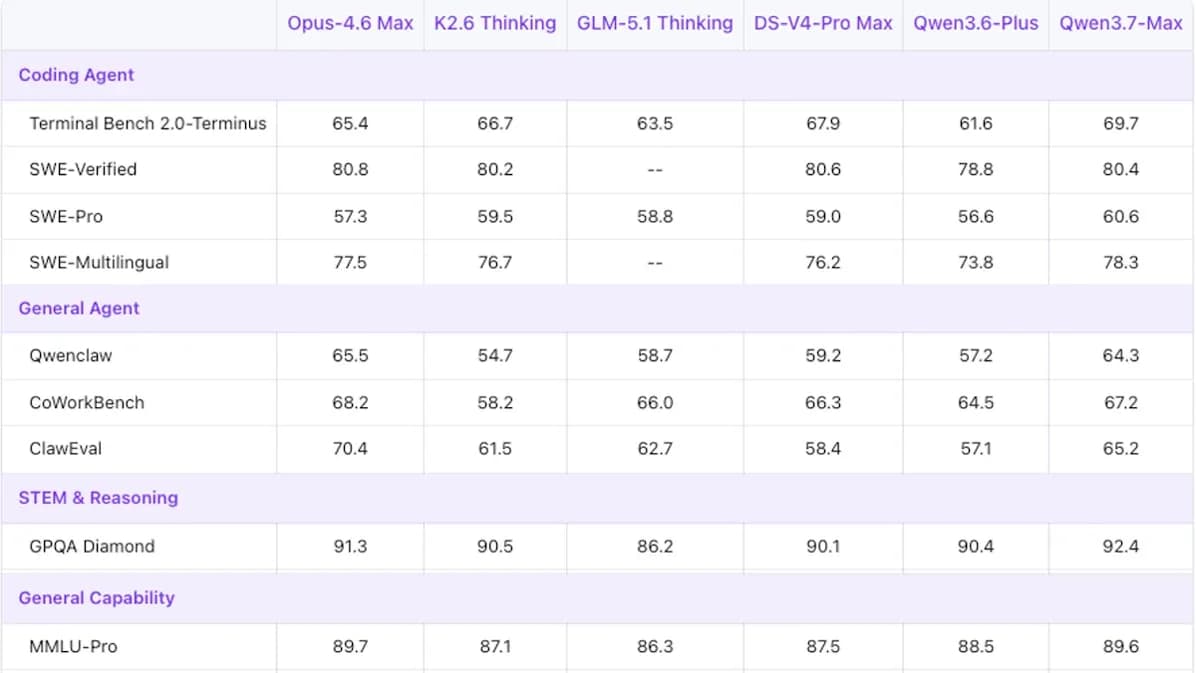
中国のテック大手アリババは、自社のフラッグシップ大規模言語モデル(LLM。大量のテキストデータを学習したAI)の最新版「Qwen3.7-Max」を発表しました。このモデルは、長時間の自律的なAIエージェント(人間の指示を汲み取って自立的に行動するプログラム)タスクに向けて最適化されています。中国製LLMとしてはトップランクの実力を持ち、推論速度や精度において米国の最先端モデルに匹敵する性能を示しています。なお、今回のQwen3.7-Maxは、モデルの内部構造やパラメータを非公開とする「クローズドソース」モデルとしてAPI(外部のシステムと機能を連携するための仕組み)などを通じて提供されます。
1. 処理能力と主要機能
Qwen3.7-Maxはテキスト処理に特化したモデルで、最大100万トークン(AIが処理するテキストの最小単位)の入力と、最大6万4,000トークンの出力をサポートします。出力速度は毎秒208.3トークンと非常に高速です。また、OpenAIやAnthropicなどの主要なAPI仕様と互換性を持ち、推論の文脈を次のターンに引き継ぐ機能や、プロンプトキャッシング(過去のプロンプトを一時保存して処理を高速化する技術)、ツール利用などの高度な機能をネイティブで備えています。
2. 独自の強化学習と第三者機関による評価
アリババの発表によると、同モデルのトレーニングには「実行するタスク」「ツールを呼び出すエージェントハーネス(実行環境)」「成否を判定する検証器(ベリファイア)」の3つの要素を分離した、独自の強化学習アプローチが用いられました。これにより、特定の環境に依存しない汎用的な能力を獲得しています。 第三者機関であるArtificial Analysisによる総合評価(実用的な10種のタスクに基づく評価)では、米国製LLMに肉薄する第7位(推論設定によっては第5位)にランクインしました。また、ファクト知識を測定するテスト(AA-Omniscience)では、回答できない質問に対しては無理に答えず「回答を控える」ことで、ハルシネーション(AIがもっともらしい嘘を出力する現象)率を23%に抑えており、テストされた最先端モデルの中で最も低い水準であることが確認されています。一方で、回答を辞退した割合が半数以上にのぼるため、評価には注意が必要との指摘もあります。
3. オープンからクローズドへの路線シフト
今回の発表は、アリババがこれまで取ってきた「オープンソース優先(技術情報を無償で公開する開発スタイル)」から、高性能な上位モデルを「クローズドソース」で提供して商業化を目指す方針へとシフトしつつあることを示しています。Qwen3.7-Maxや先行するQwen3.6-Max-Previewなどは非公開モデルとしてAPI経由で有料提供されており、開発資金の回収と持続的なビジネスモデルの構築を目指す同社の意図を反映していると見られます。
Qwen3.7-Maxの登場は、中国発のAIモデルが米国の主要モデル(OpenAI、Anthropic、Googleなど)に対して速度および推論精度の面で肉薄していることを明確に示しました。開発者にとっては、高速かつ安価な推論モデルの選択肢が増えるというメリットがあります。一方で、オープンソースコミュニティを牽引していたQwenシリーズが非公開モデルにシフトしつつあることは、今後のAIエコシステムのオープン性に対する議論を呼ぶ可能性があります。