Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月24日(土)のニュース一覧へ引用元:GIGAZINE
Liquid AIが低遅延推論エンジン「Liquid RIPL」発表
インフラ
ベンチマーク
エンタープライズ
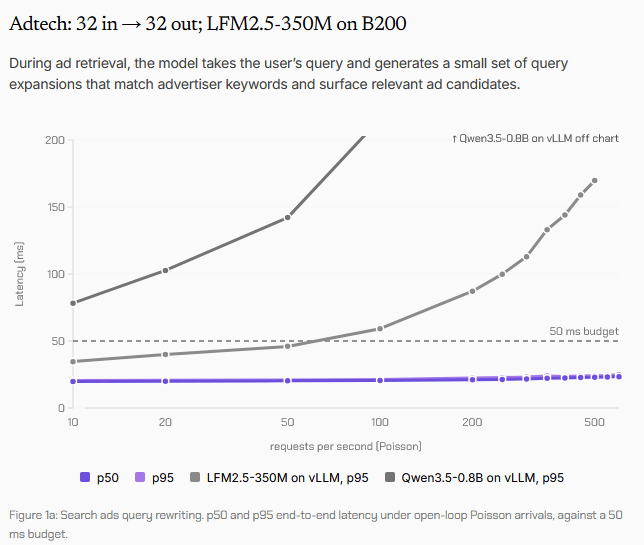
流動的基底モデル(Liquid Foundation Models)を開発する米 Liquid AI(MIT発のAIスタートアップで非Transformer系の基底モデルを開発) は2026年10月23日、極めて高い応答速度が求められるリアルタイム処理向け推論エンジン「Liquid RIPL」を発表した。検索エンジンのランキング生成やECのレコメンド、クレジットカード等の決済承認など、ミリ秒単位の遅延削減がビジネス価値に直結する処理に特化して設計されている。オープンソースの主要推論エンジン「vLLM(大言語モデルの高速・高効率なサービングを行うオープンソース推論エンジン)」と比較して最大14.4分の1の低遅延推論を達成した。
リアルタイム処理に特化した低遅延性能の検証
従来のLLMサービングでは秒間処理数(スループット)の向上が重視される傾向があったが、ユーザーの検索や決済処理にAIを介在させるシステムでは、最初のトークン出力や全体の応答時間(レイテンシ)を数ミリ秒から数十ミリ秒以内に抑える必要がある。Liquid RIPLはこうした要件を満たすため、Liquid AI製のモデルと組み合わせた最適化が施されている。
発表されたベンチマークによると、以下の性能向上が示された。
- 同モデルでの比較(LFM2.5-350M): LFM2.5-350MをLiquid RIPLで動作させた場合、同モデルをvLLM上で実行した場合と比較して大幅に遅延が短縮された。秒間リクエスト数が増加しても遅延の悪化が緩やかであり、高負荷時でも安定した応答を維持できる。
- 他モデルとの比較(最大14.4倍の高速化): LFM2.5-1.2BをLiquid RIPLで動作させた構成と、軽量モデルQwen3.5-0.8BをvLLMで動作させた構成を比較したところ、Liquid RIPL側の遅延が14.4分の1に抑制された。MiniCPM5やGranite 4.2などをvLLMで動作させた構成に対しても明確な低遅延優位性を示している。
対応ハードウェアと提供形態
Liquid RIPLは、エンタープライズ向けのハードウェア環境に対応している。
- 対応GPU: NVIDIA H200やRTX Pro 6000といったNVIDIA製GPU環境でLiquid AI製モデルを実行する用途に最適化されている。
- 商用提供: 具体的なソフトウェアライセンス体系や料金プランは一般公開されておらず、導入を検討する企業はLiquid AIの営業チームへ直接問い合わせる窓口となっている。
汎用推論エンジンとの比較および未確認事項の整理
本発表における独自性の整理と、導入検討にあたって確認すべき留意点は以下の通りである。
- 汎用基盤と特化基盤の違い: vLLMは多様なオープンモデルを幅広くサポートし、バッチ処理によるGPU利用率最大化を主目的とする汎用推論エンジンである。これに対しLiquid RIPLは、LFMモデルのアーキテクチャ特性を活かしてミリ秒単位の極限レイテンシ短縮に特化した専用エンジンという明確な差別化がある。
- 未確認事項の整理: 現時点でLiquid RIPLがTransformer系の他社オープンモデル(LlamaやMistralなど)に適用可能であるかは言及されていない。また、オープンソースとして一般公開される予定があるのか、あるいは完全プロプライエタリな商用製品として展開されるのかの詳細も未確認となっている。
リアルタイムAIとエージェント推論の展望
AIエージェントが複数の思考ステップや検索クエリを逐次実行するワークフローが普及するにつれ、1回の推論にかかる遅延の蓄積がシステム全体のボトルネックとして顕在化している。
特に検索や決済のような即時応答が必須のインフラにおいて、バッチスループットよりも単一リクエストのレイテンシを徹底的に削る推論エンジンの登場は、リアルタイムAI応用の実現性を大きく高めるとみられる。Liquid AIが提唱する非Transformer型アーキテクチャの推論効率の強みが、実運用の場面でどこまで浸透するか注目される。
引用元:GIGAZINE