Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月20日(火)のニュース一覧へ引用元:Engineering at Meta
引用元:Engineering at Meta
Meta、ギガワット級AIスパコン「Prometheus」発表
Meta
NVIDIA
インフラ
ハードウェア
半導体
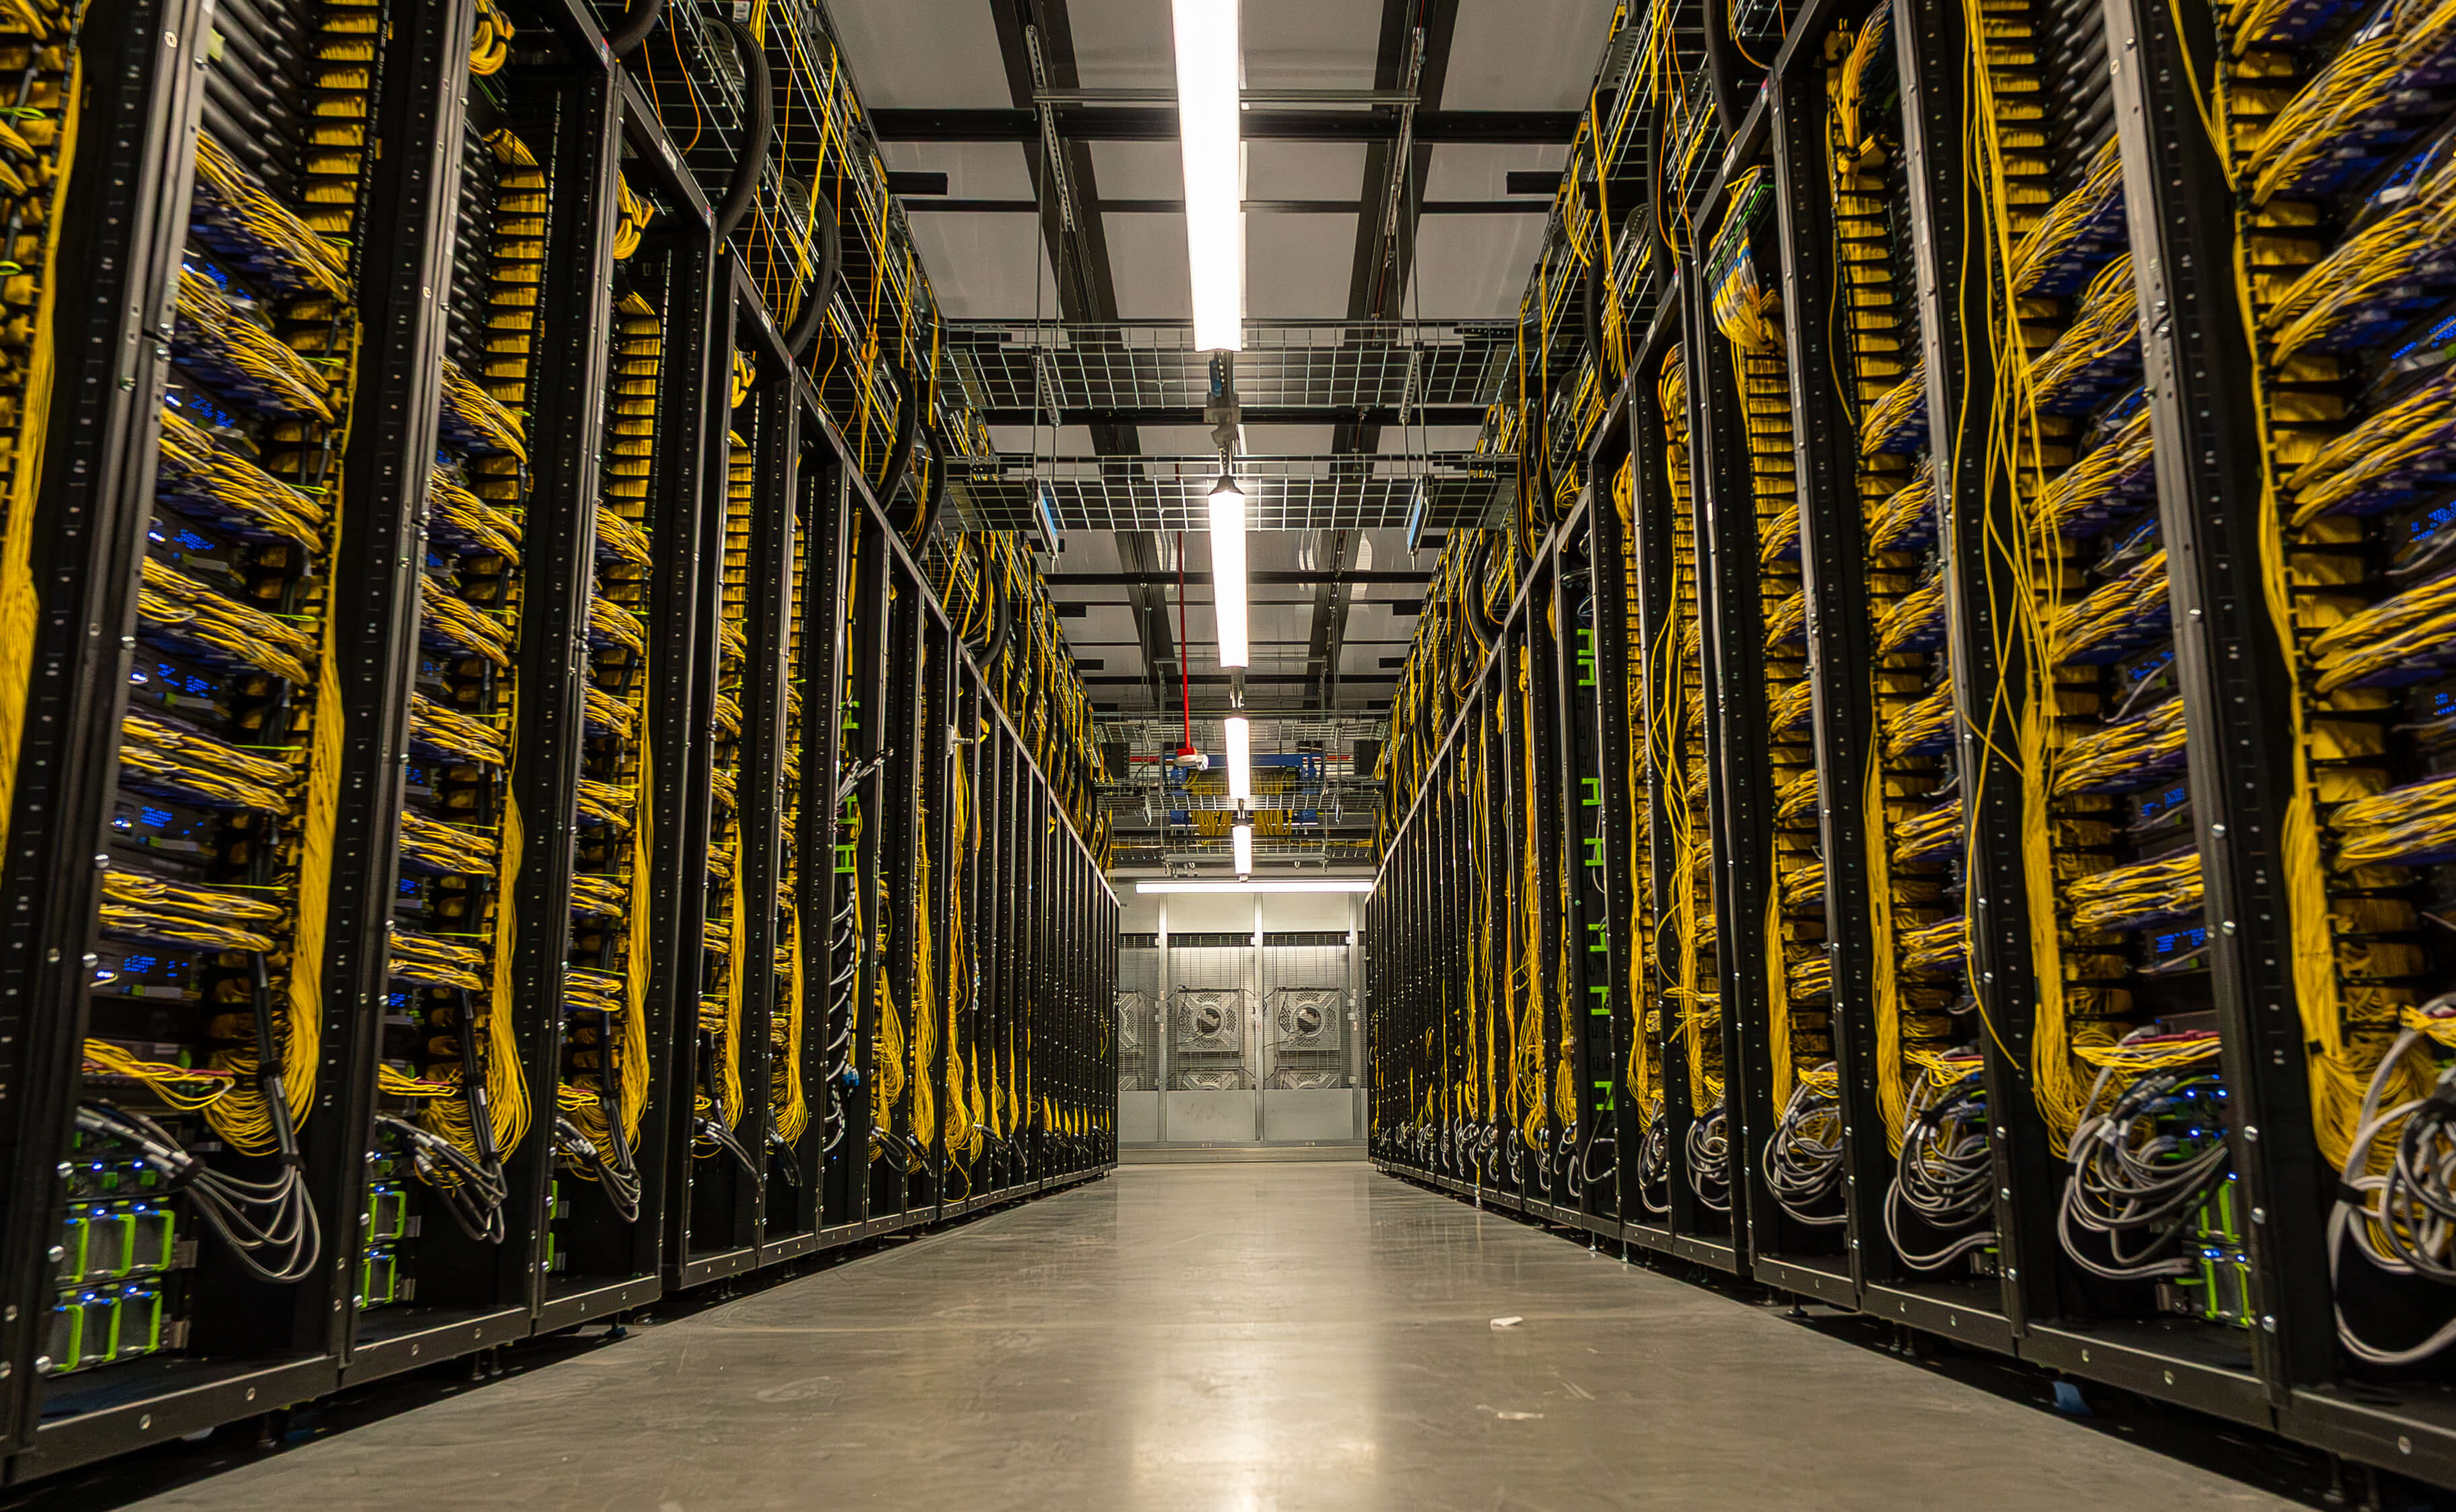
米Metaは2026年10月19日、オハイオ州ニューアルバニーで建設を進めるギガワット規模の次世代AIスーパーコンピューター「Prometheus(Metaがオハイオ州で構築する最大100万基GPU規模のギガワット級AIスパコン)」のアーキテクチャ詳細を発表した。第1フェーズの構築はすでに完了しており、同社のフロンティアモデル「Muse Wonder」の事前学習および強化学習で稼働実績を積んだ。今後はNVIDIAの最新GPU群を段階的に導入し、最終的に約100万基のGPUを単一の計算基盤として統合する計画である。
3世代にわたるNVIDIA GPUプラットフォームの展開
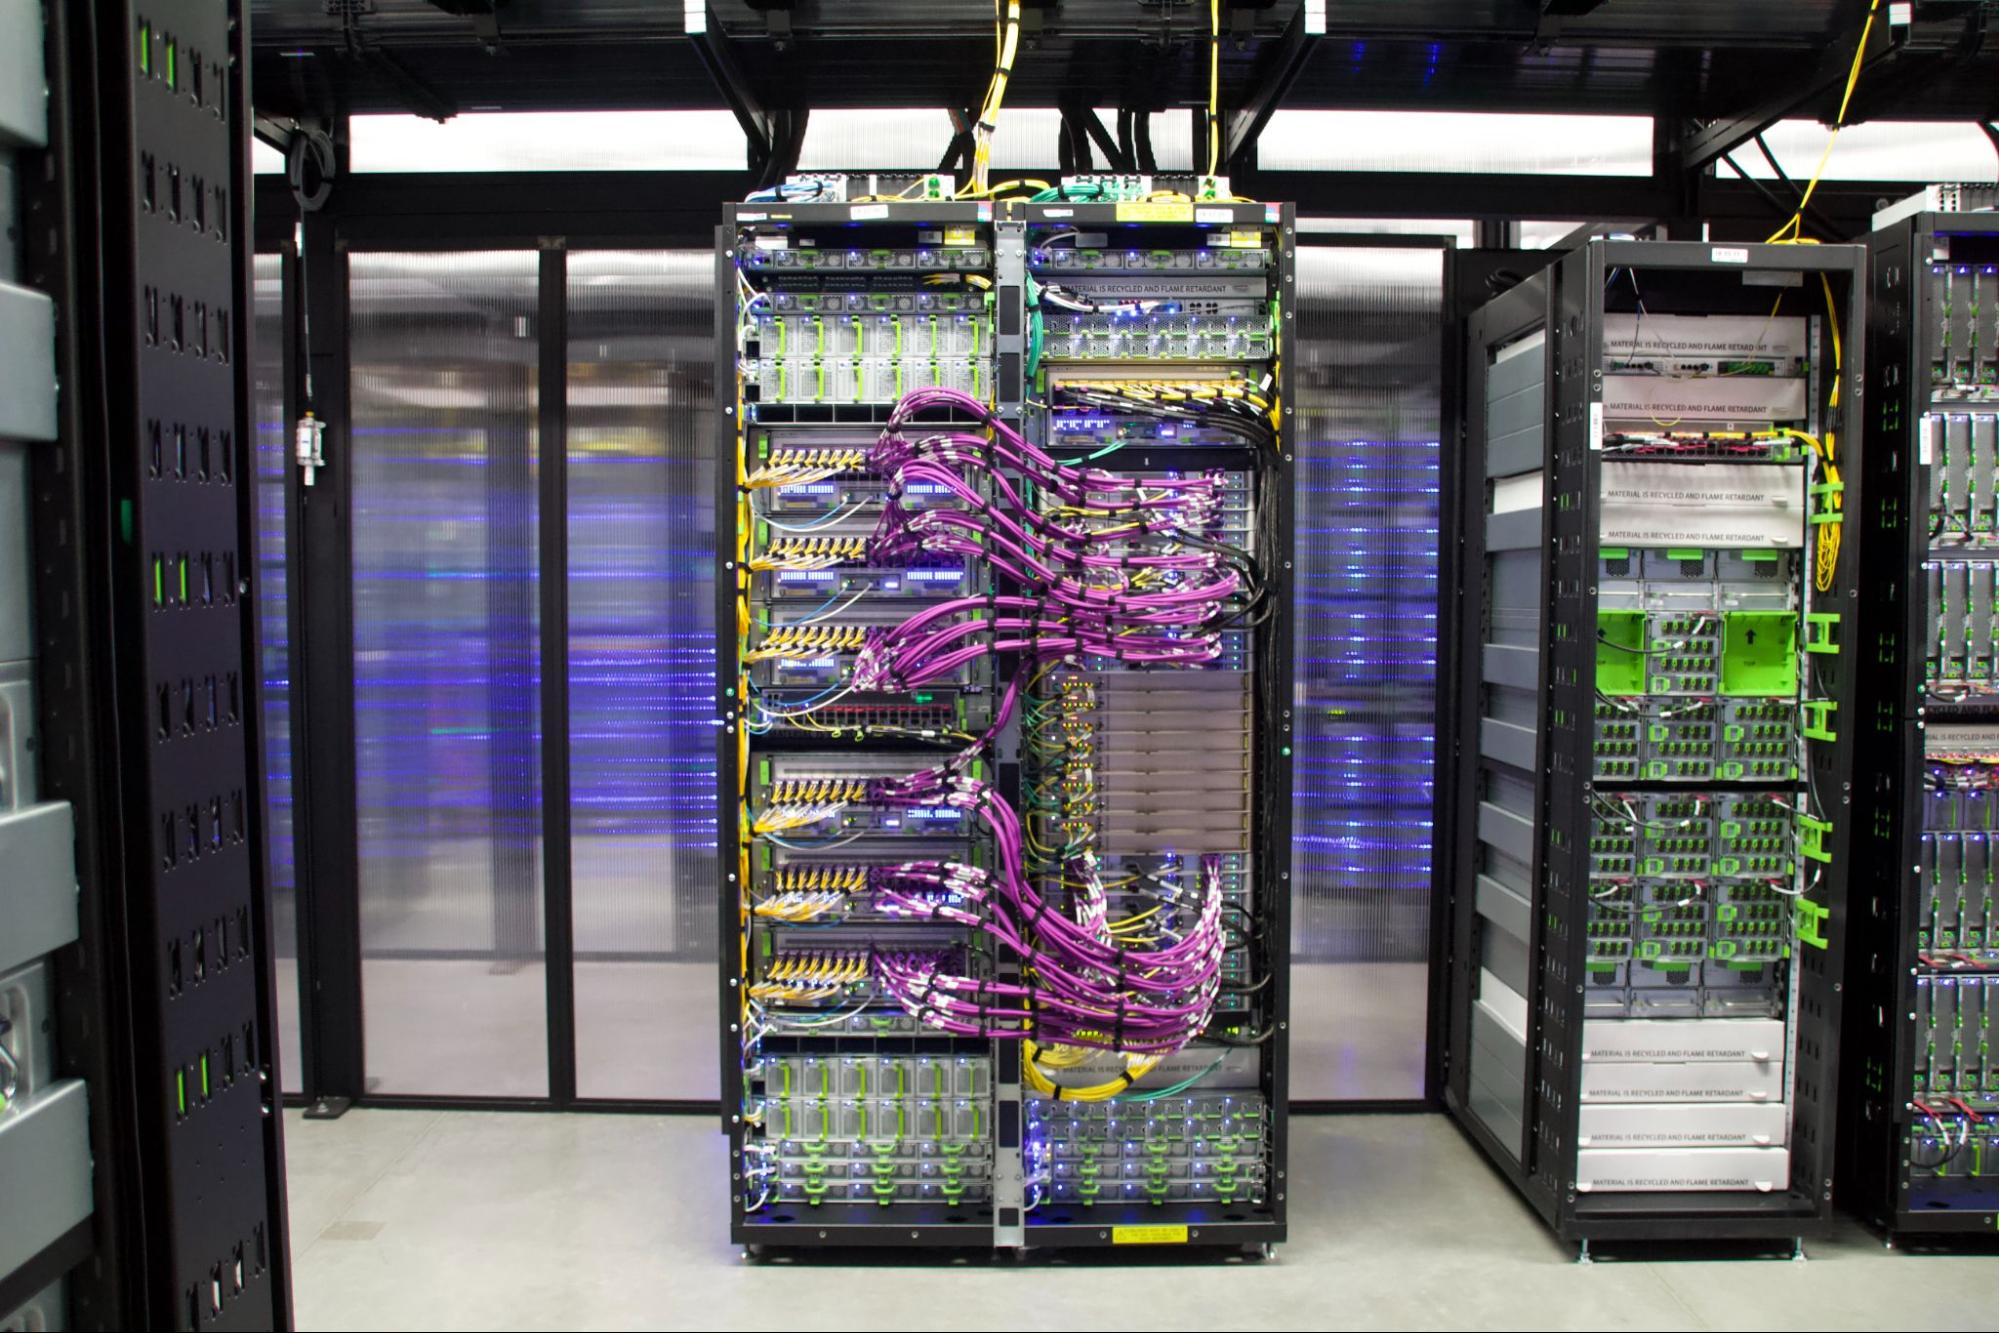
Prometheusは、72基のGPUを単一のアクセラレータドメインとして統合する「NVL72」ラックアーキテクチャを基盤に、以下の3世代のハードウェアプラットフォームを順次展開する。
| プラットフォーム | 採用GPU | ラック構成 | FP4演算性能(ラックあたり) | HBM容量(GPUあたり) | ラック消費電力 | 冷却方式 |
|---|---|---|---|---|---|---|
| Catalina | NVIDIA GB200 | 2ラックペア(36基×2) | 1,440 PFLOPS | 192 GB (HBM3e) | 約120 kW | 水冷(ORv3規格) |
| Clemente | NVIDIA GB300 | 1ラック(72基集約) | 1 EFLOPS超 | 288 GB (HBM3e) | 約135 kW | AALC/施設直結液冷(FLC) |
| San Miguel(導入予定) | NVIDIA Vera Rubin | 1ラック(72基集約) | 2.52 EFLOPS | 288 GB (HBM4) | 170 kW超 | 完全施設液冷 |
第1世代のCatalinaでは、GPUあたり800Gbpsのスケールアウト帯域を早期に確保するため、GPUとCPUを1対1でペアリングした2ラック構成(Ariel仕様)を採用した。続くClementeでは、NVIDIA ConnectX-8 SuperNICのネイティブ800G対応と2対1のGPU-CPU比率により、72基のドメインを1ラックへ集約した。さらに次世代のSan Miguelでは、HBM4(広帯域メモリの第6世代規格で通信速度と電力効率を大幅向上)と216TB/sのNVLink帯域を備え、GB300比で消費電力あたり性能が10〜20%向上する見込みだ。
72基GPU故障ドメインへの対処と99%の中断削減
NVL8からNVL72への拡張により、NVLink(NVIDIAが開発したGPU間を高速に直結するインターコネクト技術)の密結合ドメインが8基から72基へと広がり、障害発生時の影響範囲(フォールトブラスト半径)は9倍に拡大した。Metaはこの課題に対し、以下の耐障害設計を導入した。
- ラック内スペア構成(64/72スライス): 並列学習を2のべき乗単位で最適化するため、ラック内の72基中64基をアクティブに割り当て、残り8基をインラックスペアとして待機させる。GPU障害時は即座にスペアへ切り替わり、ハードウェア交換を待たずに直近のチェックポイントから再開する。
- PAFT(並列性認識フォールトトレランス): データ並列レプリカ単位で障害を隔離し、健全なクラスタ部分がステップを再試行しながら学習を継続する。
- 電力急変の抑制(Dynamo Dimmer): 数万基のGPUが一斉に計算と通信を同期する際、クラスタ内で30〜40%(数十メガワット規模)の急激な電力トランジェントが発生する。Metaは独自フレームワーク「Dynamo Dimmer」によりGPUの電力上限を動的に制御し、ラック内バッテリーバックアップ(BBU)や蓄電設備(BESS)と連携して送電網への負荷を平滑化している。
MetaとNVIDIAの共同エンジニアリング体制により、2025年半ばに8,000基あたり日次約1,000件に達していたジョブ中断率は99%削減された。現在の平均中断間隔(MTBI)は54,000 GPU時間を超えており、最終目標である100,000 GPU時間(日次2件以下)の達成に向けた改善が継続している。
発表で未確定の課題と制約
Prometheusの野心的な計画の一方で、以下の重要事項は今回の発表で明示されていない。
- 100万基GPU達成の時期: 約100万基へのスケールアップに関する具体的な完了年度や設備投資総額は明らかにされていない。
- 電力供給網の制約: ギガワット規模の受電には現地の電力会社(Entergyや地域電力事業者)との大規模な送電網拡張が必要であり、実稼働までの送電インフラ工事の進捗がボトルネックとなる懸念がある。
- 完全液冷への移行コスト: Vera Rubin世代(170kW超/ラック)の稼働には従来の空冷併用(AALC)が通用せず、データセンター全体の施設液冷(FLC)配管への全面改修が前提となる。
超巨大インフラ内製化が促すフロンティア競争の二極化
編集部注: Metaが公開したPrometheusの構成は、単に計算資源を調達するだけでなく、OCPを通じたオープンハードウェア設計やFBOSSによる独自イーサネット網、電力平滑化ソフトに至るまで、データセンターの全レイヤーをソフトウェア制御下に置くアプローチの集大成と言える。
メガワット級からギガワット級への移行は、フロンティアAIモデルの開発に必要な資本的障壁を劇的に引き上げる。約100万基のGPUを同期稼働させるノウハウを持つ企業と、外部クラウドの標準インスタンスに依存する企業との間で、学習効率と開発スピードの格差は今後いっそう拡大するとみられる。


