Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月15日(木)のニュース一覧へ引用元:Glitchwire
NVIDIA、自律組み立てAI「AlphaNIST」発表
NVIDIA
ロボティクス
フィジカルAI
研究
米NVIDIAのシアトル・ロボティクス研究所(Seattle Robotics Lab)の研究チームは2026年10月、製造組み立ての高難度標準ベンチマーク「NIST Assembly Task Board #1」に含まれる全20種類のタスクを、単一のニューラルネットワークポリシーで解く自律型ロボット学習システム「AlphaNIST」を発表しました(論文 arXiv:2610.13354)。人間のデモンストレーションや細かな誘導報酬を一切排除し、部品が正しく組み合わさった時にのみ与えられる「二値報酬(バイナリリワード)」だけで強化学習を行い、シミュレーション上で98.2%の成功率を達成しました。
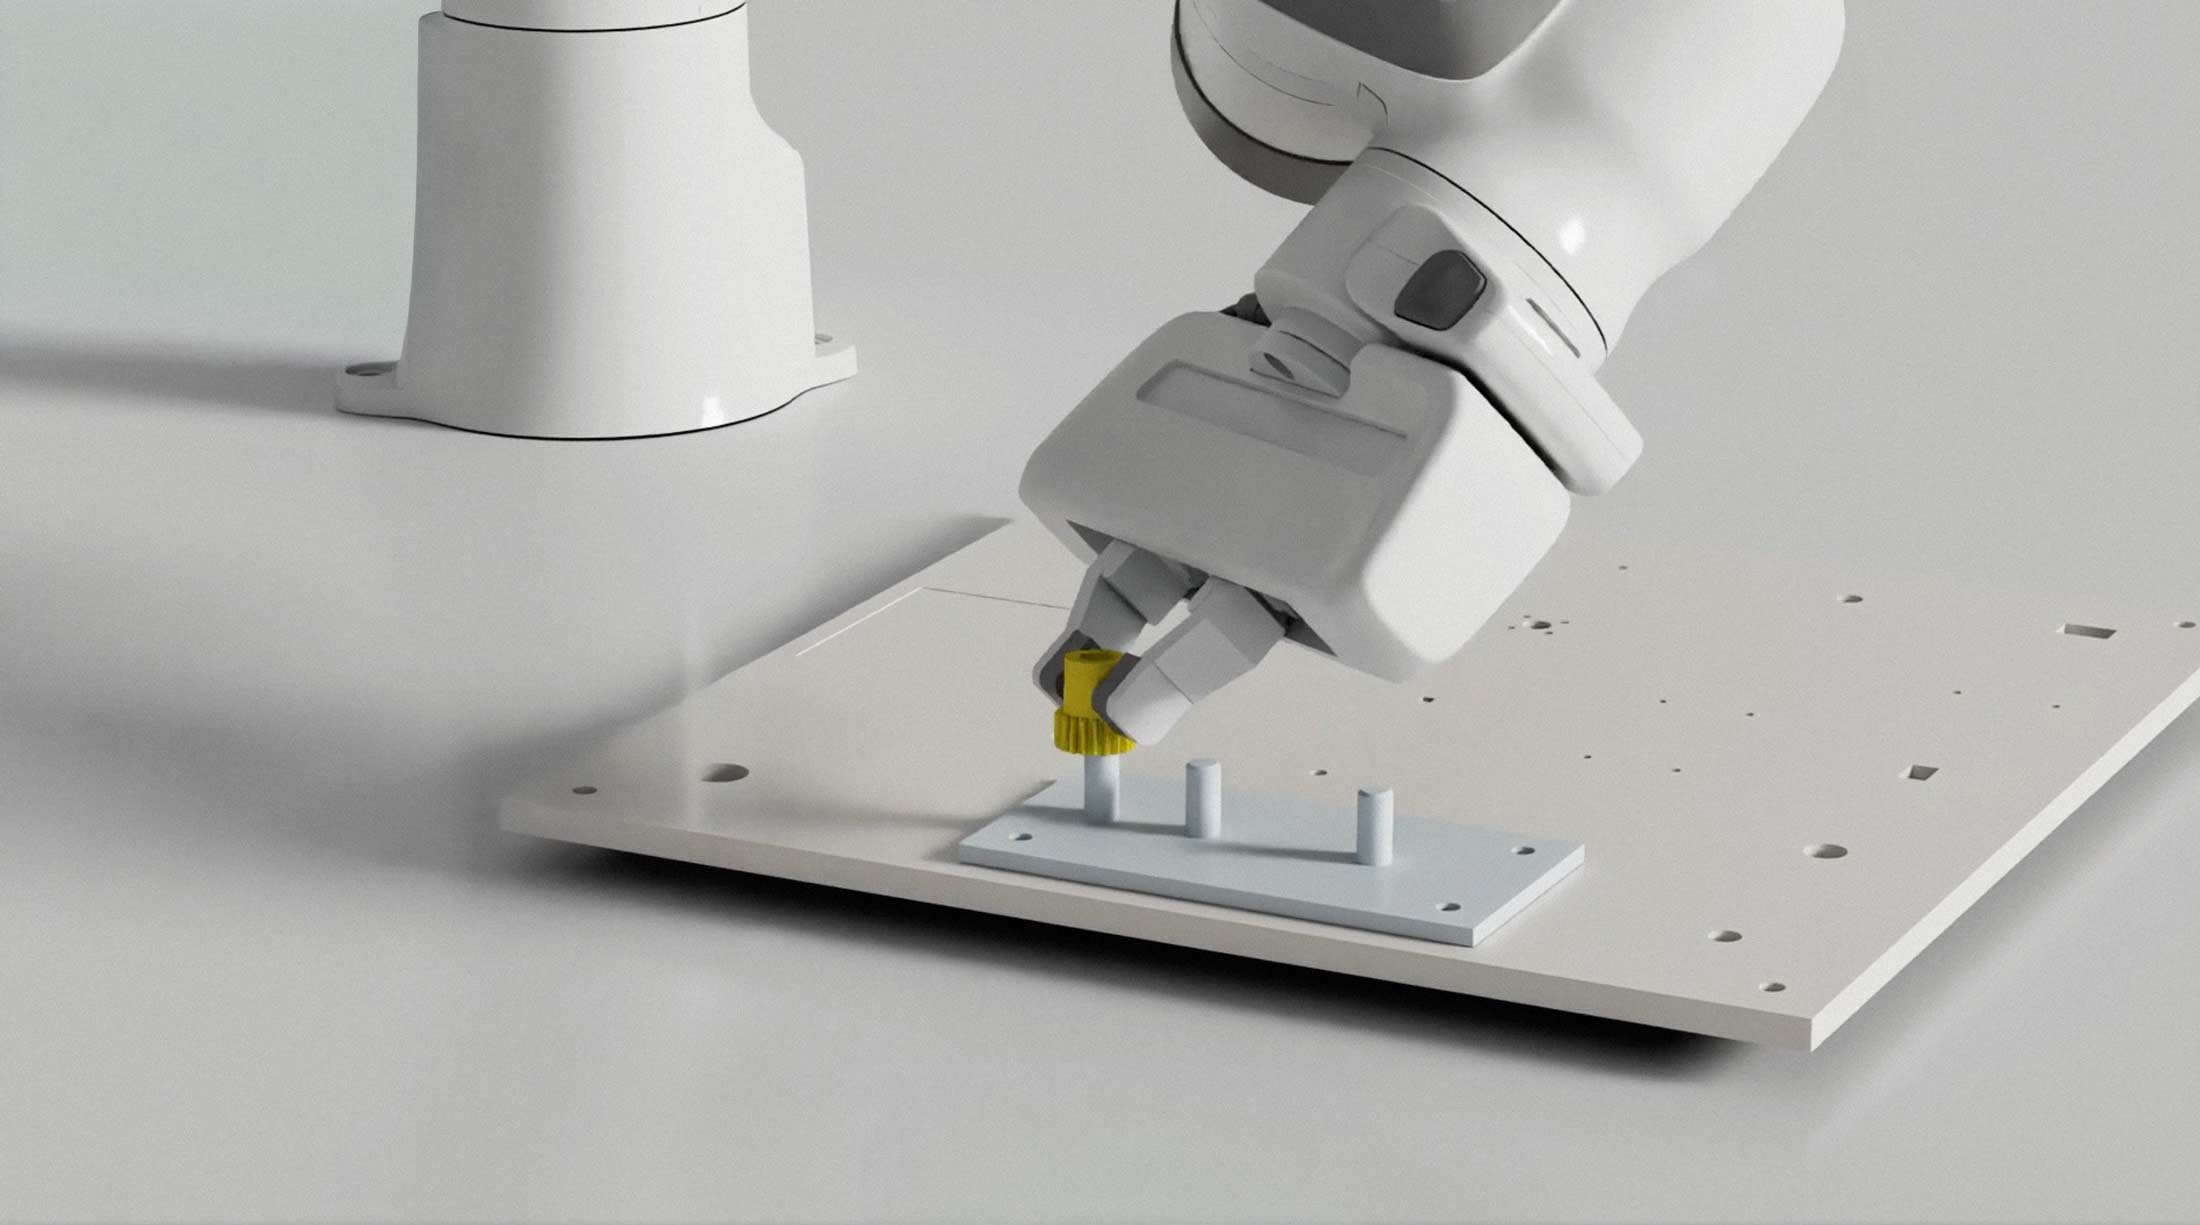
人間の指導なしに試行錯誤から創発した高精度なマニピュレーション技術
NIST Assembly Task Board #1は2017年の登場以来、ロボットによる精密な部品組み立ての試金石とされてきました。基板上にはピン挿入、ギアの噛み合わせ、防水コネクタの挿入、ナットのネジ締めなど、実際の工場製造に直結する20種類の部品ペアが配置されています。最小部品サイズは4mm、わずかな傾きで部品が噛み込み(ジャミング)を起こす極小の公差(クリアランス)が要求されます。
従来の強化学習研究では、アプローチごとに人間が模範動作(デモ)を与えたり、目標位置への接近度合いを小刻みに評価する「密な報酬設計(Dense Reward Shaping)」を行っていましたが、AlphaNISTはそれらを完全に排除しました。
- 二値のタスク完了報酬のみ: 学習系に与えられるのは、組み立てが完了した瞬間の1ビットの成功信号と、激しい振動を抑える制御コストのみです。
- 創発的戦略の獲得: 人間が教えていない巧みな動作を自律的に発見しました。例えば、8mmピンの中央を掴んだ場合は一度台に置き、端を掴み直して挿入しろを確保する「自律的リグラスプ(握り直し)」や、コネクタを基板表面に押し当てて姿勢を整えてからソケットへ滑り込ませる接触整流動作が確認されています。
- 10連続タスクの一括実行: 別途訓練されたポリシーでは、1回のエピソードで10種類の組み立てを連続で実行し、10個すべてが完了した時点で初めて報酬を受け取る長大タスクも自律解決しました。
従来手法との比較と学習アーキテクチャ
| 比較項目 | 従来のロボット強化学習 | AlphaNIST |
|---|---|---|
| 事前指導・デモ | 人間の遠隔操作や軌道データが必須 | 一切なし(ゼロから自律試行) |
| 報酬設計 | 接近度や向きなど手作業の密な報酬 | 組み立て完了時の二値報酬(0か1)のみ |
| タスク対応力 | 部品ごとに個別のモデルや微調整 | 単一ポリシーで全20タスクを汎用実行 |
| シミュレーション規模 | 数百〜数千環境 | 最大256,000並行環境(GPUあたり4,000) |
| ベンチマーク成功率 | 全タスク制覇の手法は未存在 | シミュレーション上で**98.2%**を達成 |
学習はNVIDIAのロボティクス物理シミュレータ「Isaac Lab(GPU上で数万の環境を同時並行シミュレーションできるロボティクス学習基盤)」上で実行されました。7自由度のFranka Emika Pandaロボットアームを用い、ロボットの状態と部品・相手側形状の点群(Point Cloud)を入力として、25Hzの周期で関節目標位置とグリッパー開閉コマンドを出力します。
未確認事項と今後の課題
研究チームが指摘している主な制約と課題は以下のとおりです。
- シミュレーションから実機への転移(Sim-to-Real): 今回の成果はシミュレーション環境内での検証であり、実機ハードウェアへの直接適用は今後の課題です。NISTボードの実環境公差は最小0.029mmに達し、シミュレータ以上の物理的摩擦やセンサ誤差が存在します。
- 未学習形状への汎化性: 20種類のタスクに対するマルチタスク学習には成功したものの、未知の形状や20種類を超えるタスク数へのスケーラビリティは論文化されていません。
分析と今後の展望
囲碁のAlphaGoやAlphaZeroが、人間の常識を超えた一手をゼロからの強化学習で自己発見したように、AlphaNISTはロボティクスにおける「創発的知能」の可能性を実証しました。中途半端な誘導報酬を与えるよりも、スパースな二値報酬と超並列な大規模計算(Isaac Lab)を組み合わせた方が、ロボットが真に頑健な接触操作戦略を自律的に見つけ出せるという発見は、マニピュレーション研究にパラダイムシフトを迫るものです。
NVIDIA自身、次世代AIサーバー「GB300」の検査トレイ自動組み立てなど、99.5%以上の超高精度が求められる工場内タスクのロボット化を急いでおり、AlphaNISTの成果は同社の人型ロボット基盤モデル「Project GR00T」やフィジカルAI(現実世界の物理法則を理解して実空間で動作するAI技術)の産業実装へ直結する重要なマイルストーンといえます。
引用元:Glitchwire