Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月29日(火)のニュース一覧へ引用元:GIGAZINE
Fireworks AI、思考35%削減の「Ember-1」発表
推論
LLM
API
オープンソース
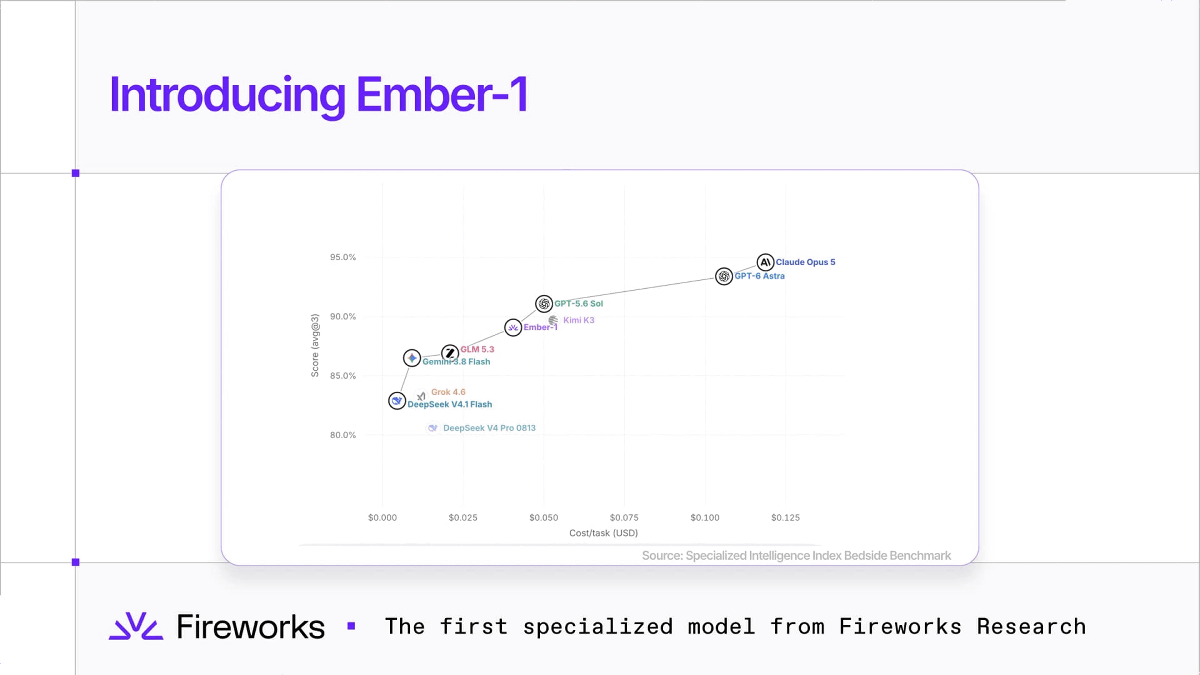
AIモデルの追加学習および高速推論APIを提供する米Fireworks AIは2026年9月28日、高性能オープンモデル「Kimi K3(中国Moonshot AIが開発した2.8兆パラメータの超大型オープン推論モデル)」をベースに開発した新型AIモデル「Ember-1」を発表した。最先端の推論モデルで課題となっていた「過剰な思考によるトークン消費と処理遅延・コスト増大」を解決するため、追加学習により不要な思考トークンを約35%削減しながら同等の精度を維持することに成功した。同社プラットフォーム上でAPIおよびプレイグラウンドの提供が開始されている。
推論モデルの「思考しすぎ」問題と追加学習アプローチ
近年のフロンティアAIモデルでは、最終的な回答を出力する前に段階的な論理構成を行う推論(Reasoning)(問題解決の手順や自己検証の過程を内部トークンとして生成する推論手法)機能が標準化されている。しかし、Fireworks AIの分析によると、高性能モデルでは全出力トークンの約90%が思考プロセスに費やされている実態がある。
特に複数ターンのやり取りを行うAIエージェント(自律的にタスクを計画・実行するAIソフトウェア)運用では、ステップごとに過去の全コンテキストを再読み込みするため、肥大化した思考履歴が累積APIコストとレイテンシを跳ね上がらせる要因となっていた。Kimi K3も一部のベンチマークで高い性能を示した一方で、タスクあたりの実行時間が平均1時間近くに達するなどコスト面が課題視されていた。
Ember-1はこの課題を解消するため、「問題遂行に不可欠なフィードバック思考」を保持しつつ、冗長で実質的な価値を生まない思考ループロジックを削ぎ落とす追加学習が施された。医療タスクベンチマーク「Bedside Bench」による検証では、Kimi K3と同等の正答スコアを維持しながら、大幅に低いコストと短い処理時間を実現している。
社内運用とA/Bテストでの実証結果
Fireworks AIはモデルの実用性を検証するため、社内従業員を対象にKimi K3からEmber-1への置き換えテストを実施し、不具合の報告がゼロ件であったことを確認した。
さらに、エンタープライズ顧客2社を対象としたA/Bテストにおいても、Kimi K3と同等の性能水準を保ちながら、タスクあたりの出力トークン数を約35%削減できることが実証された。
モデル比較と日本の開発者への影響
Kimi K3とEmber-1の主な特性の違いは以下の通りである。
| 項目 | ベースモデル(Kimi K3) | Fireworks AI「Ember-1」 |
|---|---|---|
| ベースアーキテクチャ | 2.8兆パラメータ オープンモデル | Kimi K3に追加学習・思考トークン削減を適用 |
| 思考トークン消費 | 出力の約90%を消費、長大化の傾向 | 不要な思考を間引き、出力トークンを約35%削減 |
| 処理時間・コスト | 長時間・高コスト(タスクあたり長大) | 「低性能・高コスト」から「同等性能・低コスト」へシフト |
| 提供形態 | オープンウェイト | Fireworks AI API / プレイグラウンド |
日本の開発者やスタートアップにとっても、エージェントワークフローを本番稼働させる際のAPI呼び出しコストとユーザーへの応答時間はプロダクト採算性を左右する重大な要素である。
Ember-1のAPI料金は、100万トークンあたり入力3ドル(約470円)、キャッシュ済み入力0.3ドル(約47円)、出力15ドル(約2,350円)に設定されている。特に入力プロンプトキャッシュ(0.3ドル)を併用することで、エージェントが繰り返しコンテキストを参照する際の運用コストを大幅に抑制できる。
なお、Ember-1のモデルウェイト自体が外部ダウンロード可能なオープンモデルとして公開されるのか、あるいはFireworks AIのマネージド環境専有のサービスにとどまるのかについては公式発表内で言及されておらず、未確認事項となっている。
思考トークン効率化の競争展望
これまでAIモデルの競争は「ベンチマークスコアの絶対値」が主要指標であったが、実運用フェーズへの移行に伴い「トークンあたりの知能密度(効率性)」が新たな競争軸となっている。
編集部注: 思考プロセスを際限なく展開して正答率を稼ぐ手法は、計算リソースとAPIコストの観点から実ビジネスでの普及に限界がある。Ember-1のように、蒸留やファインチューニングを通じて推論効率を最適化する「軽量・高密度推論」の試みは、今後の実用エージェント開発における主流技術になるとみられる。
引用元:GIGAZINE