Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月25日(金)のニュース一覧へ引用元:The GitHub Blog
GitHub、AI連携C/C++自動ファジング基盤を公開
GitHub
セキュリティ
AIエージェント
オープンソース
開発者ツール
オープンソースソフトウェアの脆弱性発見において不可欠とされながらも、専門家の手作業に頼っていたファジング(不正な入力データを大量に与えて未知のバグや脆弱性をあぶり出すテスト手法)の自動化に向けた新たな基盤が登場しました。米GitHubのセキュリティ研究組織であるGitHub Security Labは、C/C++プロジェクトを対象とした自律型ファジング実行基盤「Fuzzing Taskflow」をオープンソースとして公開しました。
本ツールは同組織のAIセキュリティ自動化フレームワーク「GitHub Security Lab Taskflow Agent」を基盤に構築されています。既定のLLMモデルとしてClaude Sonnet 5(Anthropicが提供する高度な推論・コード生成能力を持つ大規模言語モデル)を採用し、リポジトリを指定するだけで、関数の抽出、テストハーネスの記述、代表的ファジングツールであるAFL++(コードカバレッジを測定しながら効率的にテスト入力を生成する代表的ファジングツール)の実行、カバレッジ解析、さらにはクラッシュ原因のトリアージと修正パッチ提案までを一貫して自動実行します。
意思決定と実行を分離した3層アーキテクチャ
GitHub Security Labによると、長年にわたりOSS-Fuzzなどに登録されているプロジェクトであっても、コードカバレッジの監視、未到達コードに対する新しいテストハーネスの作成、検出されたクラッシュのトリアージという3つの工程には依然として人間の介入が不可欠でした。Fuzzing Taskflowはこれらの一連の作業をLLMエージェントに委譲することを目指して設計されています。
システムは以下の3層で構成され、「LLMエージェントが意思決定を行い、MCPツールが実行を担う」という明確な責務分離が図られています。
- シェルドライバ(run_fuzzing.sh): パイプライン全体の各ステージを直列に繋ぎ合わせる実行スクリプトです。
./scripts/fuzzing/run_fuzzing.sh owner/repoのようにGitHubのリポジトリスラッグを指定するだけで起動します。 - Taskflow YAML群: 各ステージでLLMエージェントに具体的なタスクを指示するプロンプト定義です。
- MCPツール群: MCP(LLMと外部ツールを標準規格で接続するModel Context Protocol)を介して、AFLの実行やハーネスのコンパイル、クラッシュの保存、カバレッジレポートの読み取りなどの実行プリミティブを提供します。エージェントがAFLやclangを直接呼ぶのではなく、MCPツールが提供する抽象インターフェースを通じて処理を組み立てます。
パイプラインの状態はすべてSQLiteデータベース(fuzz_context.db)に保存され、ステージ間でのデータ受け渡しをメモリ上ではなくデータベース経由で行うことで堅牢性を確保しています。また、作成された各テストハーネスは、ファジング実行用の .afl バイナリ(afl-clang-lto -fsanitize=address などASan・UBSan連携)と、行・分岐カバレッジ計測用の .cov バイナリ(clang -fprofile-instr-generate -fcoverage-mapping)の2種類がビルドされ、高速なファジングと詳細なカバレッジ計測を両立させています。
カバレッジ駆動の自律フィードバックと構造認識ファジング
本パイプラインの中核となるのが、カバレッジ結果に基づいてテストを自律反復するフィードバックループです。
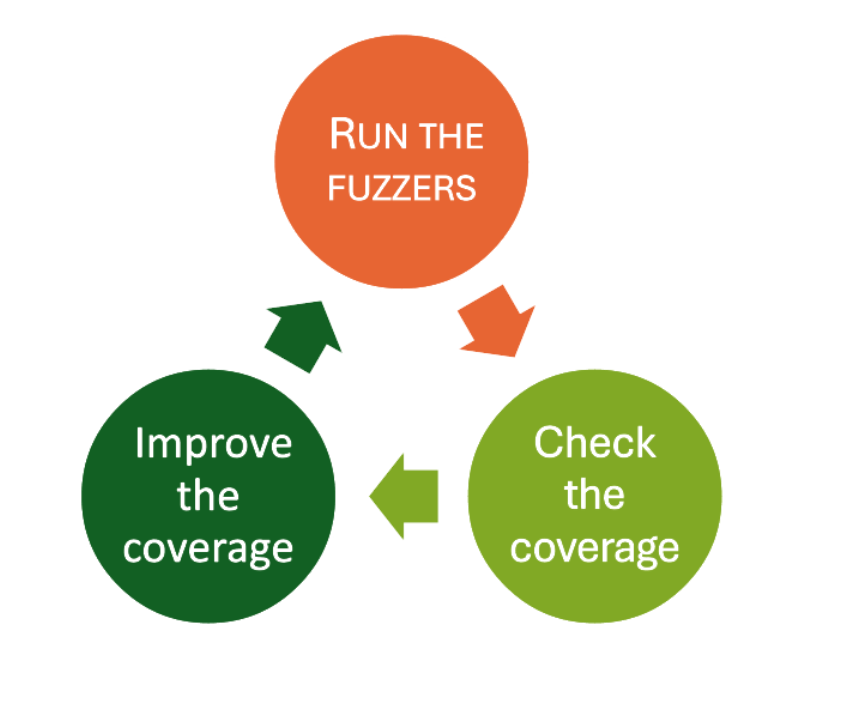
従来の開発現場では、研究者がLCOVレポートを手動で確認して未カバーの分岐を見つけ、ハーネスコードやシード入力を手作業で追加していました。Fuzzing Taskflowでは、エージェントが毎回のイテレーションでAFL++を実行した後、.cov バイナリでテストキューを再生して未到達ブランチを特定します。その分析結果に基づき、以下の4つのアクションを自律的に選択して実行します。
- 未カバー分岐に到達するための新たなシード入力を生成
- 追加のAPIを呼び出すためのハーネスコードの編集
- ガード条件が比較している定数を抽出したAFL辞書の自動拡充
- コールドなエラーパスやサードパーティ製ライブラリコードなど、深追いする価値のないギャップのスキップ判断
ファジングの実行時間バジェットは 30秒 → 60秒 → 120秒 → 240秒 → 480秒 → 960秒(合計約32分/ターゲット) と反復ごとに倍増します。初期段階では低コストな探索で到達しやすいカバレッジを獲得し、突破が困難なガード条件に対して段階的により長い時間を配分する仕組みです。さらに、2イテレーション連続で絶対行カバレッジの伸びが1%未満となった場合に探索を打ち切る「プラトー検出」を備え、無駄な計算リソースの浪費を防ぎます。
また、JSONやXML、正規表現などの構造化入力に対応するため、以下の4つの仕組みによる構造認識(Structure-aware)ファジングが組み込まれています。
- フォーマット別辞書とカスタムミューテータ: JSONの構文トークン結合、XMLのエンティティ、正規表現のReDoSパターンなどを考慮したミューテータを事前提供。
- ソースレベル辞書: 対象C/C++コード内の
#defineやcase、enumから文字列リテラルや32ビット数値を自動抽出してカスタムミューテータを動的生成。 - カバレッジ駆動の辞書拡充: 未到達行の周辺にある比較式(
strncmpやmemcmp、case 0xN等)を検出し、比較定数をクラシック辞書に動的追記。 - コーパススプライス: 安定したコーパスディレクトリ(
<workspace>/corpus/harness_<id>/)にafl-cminで最小化した入力群を保持し、過去のキャンペーンの成果を次回以降に継承。
クラッシュ分析・パッチ提案と従来手法の比較
ファジングでクラッシュが検出された後のトリアージ工程も自動化されています。afl-tmin によるクラッシュ入力の最小化、AddressSanitizer(ASan)環境でのスタックトレース取得、上位フレームの正規化ハッシュによる重複排除を経て、エージェントが公開APIからの呼び出し経路を逆算したMarkdown形式の調査レポートを作成します。
レポートでは各クラッシュに対して以下の判定ラベルが付与されます。
vulnerability(公開API経由で到達・悪用可能な真の脆弱性)harness_bug(ライブラリ本体ではなくハーネス側の記述不備によるクラッシュ)library_hardening,OOM,timeout,assertion_failure,duplicate
レポートにはファイル名と行番号を含む根本原因分析、到達可能性・悪用可能性の評価に加え、unified diff形式の修正パッチ案とリグレッションテスト設計が記載されます。また、キャンペーン開始と同時にポート8765でローカルHTMLダッシュボードが自動起動し、ハーネスごとの実行状況やカバレッジ推移のスパークライン、クラッシュヒートマップをリアルタイムに確認できます。
| 評価項目 | 従来のファジング運用(手動 / OSS-Fuzz等) | Fuzzing Taskflow(自律エージェント基盤) |
|---|---|---|
| 対象関数の選定 | 人間がソースコードを調査して手作業で特定 | LLMエージェントがリポジトリを走査して自動特定 |
| テストハーネス作成 | 開発者がC/C++で手作業記述 | エージェントが自動生成およびコンパイル |
| カバレッジ改善 | カバレッジレポートを目視して手動修正 | カバレッジ計測結果からシード・辞書・コードを自律反復改善 |
| クラッシュトリアージ | デバッガ等でスタックトレースを人間が解析 | 重複排除の上、脆弱性かハーネス不備かを自動判定 |
| 修正対応 | 原因特定からパッチ作成まで人手で実施 | 根本原因の特定とunified diff形式の修正案を自動提示 |
運用上の安全リスクと未確認事項の整理
本ツールは大幅な省力化をもたらす一方で、アーキテクチャ上の重要な制約とセキュリティリスクが存在します。
- 任意コマンド実行とプロンプトインジェクションのリスク: Fuzzing Taskflowは、
afl-fuzzやclangだけでなく、LLMエージェントが選択した任意のビルドコマンドをホスト上で直接実行します。コンテナ等のサンドボックス層を挟まずにホスト上で実行されるため、解析対象のリポジトリ内に悪意ある指示(プロンプトインジェクション)が含まれていた場合、実行ユーザーの権限で任意の不正操作が行われる危険性があります。GitHub Security Lab自身も「Codespacesや使い捨てVMなどの隔離された環境で、非特権ユーザーとして実行すること」を強く推奨しています。 - 修正パッチの信頼性と人間レビューの必須性: エージェントが提示する修正パッチはすべて「要レビュー(review required)」扱いとなっています。LLMの推論能力には限界があり、誤った修正案や不完全なパッチを提案する可能性があるため、最終的な適用にはセキュリティエンジニアによる確認が欠かせません。
分析・展望:自律型セキュリティ検証の普及と「実行環境の安全性」
ファジングはソフトウェアの未知の脆弱性を発見する極めて強力な手法でありながら、テストハーネスの記述やクラッシュトリアージに高度な専門性と多大な工数を要することが普及の大きな壁となっていました。Fuzzing Taskflowが提示した「意思決定をLLMエージェントに委譲し、確定的な実行をMCPツール群で抽象化する」という設計パターンは、C/C++にとどまらず他の言語や検証工程にも応用可能な現実的なアプローチです。
一方で、本ツールの登場は、コードを自動生成してビルドを実行する「自律型AIエージェント自体の安全性確保」という新たな課題を浮き彫りにしています。悪意あるリポジトリの解析時にエージェントが乗っ取られるリスクを抑えるため、隔離された実行サンドボックス技術と組み合わせた運用が今後の標準になるとみられます。AIを活用した脆弱性探索が日常的なCI/CDプロセスへ浸透していく中で、検査精度の向上とともに、エージェントを安全に走らせる実行基盤の整備が重要な論点となっていくと考えられます。
引用元:The GitHub Blog