Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月22日(火)のニュース一覧へ
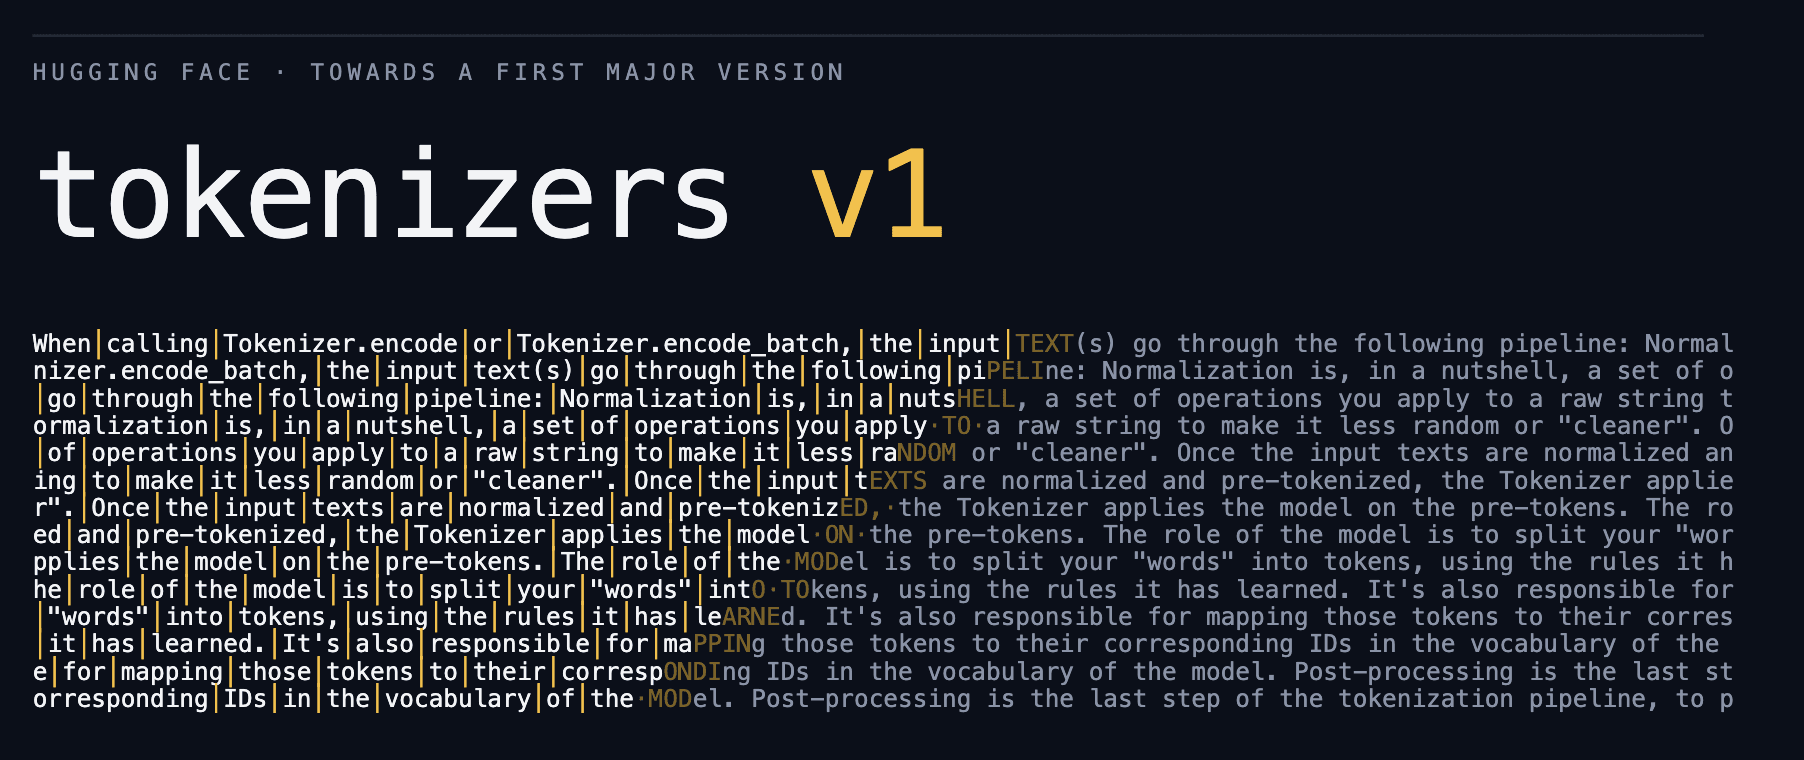
Hugging Face、高速版「Tokenizers v1」公開
Hugging Face
オープンソース
開発者ツール
LLM
バージョンアップ
オープンソースAIコミュニティを主導する米Hugging Face(オープンソースAIモデルやライブラリのハブを提供する企業)は2026年9月21日(現地時間)、機械学習パイプラインでテキストを数値トークンへ変換する基盤ライブラリのメジャーアップデート版「Tokenizers v1」を公開した。従来バージョン(v0.23)と比較して最大数十倍のエンコード・デコード処理速度を達成しながら、出力されるトークンIDやAPIの完全な後方互換性を維持している。
GPUを待たせないトークナイズ処理の高速化
大規模言語モデル(LLM)の推論が高速化し、学習データセットが巨大化するにつれて、前処理であるテキストのトークナイズ処理がシステム全体のボトルネックとなるケースが増加していた。CPU側でのトークナイズ完了を待つために、高価なGPUが計算を停止(アイドル)してしまう現象が課題視されていた。
Tokenizers v1は、Rustで記述された中核処理を抜本的にリファクタリング。シングルスレッドおよびマルチスレッド環境でのメモリアロケーションとデータ走査ロジックを最適化し、従来版と比べて劇的なスループット向上を実現した。開発にはオープンソースの知見が集約され、IBMやNVIDIA、PyTorch ExecuTorchチームなどからのパッチ提供や多種ハードウェアでの検証協力が反映されている。
新旧バージョンの仕様および性能の比較
Tokenizers v1と従来バージョン(v0.23)における設計方針と性能特性の比較は以下の通りである。
| 項目 | Tokenizers v1(最新版) | Tokenizers v0.23(従来版) |
|---|---|---|
| 処理速度・スループット | 従来比で最大数十倍に高速化 | 基準速度(高並列時にボトルネック化) |
| 出力トークンIDの一致性 | 100%完全一致(後方互換性を保証) | 基準出力 |
| APIおよび語彙互換性 | 既存コードの変更不要で差し替え可能 | 基準API |
| 対応アルゴリズム | BPE、WordPiece、Unigram等に汎用対応 | 同左(処理速度に制約) |
| マルチコアスケーリング | スレッド数に応じた線形なスケール向上 | スレッド競合による頭打ち傾向 |
日本の開発者への影響と未確認事項
PythonおよびRustでLLMの開発やデータセット作成を行う日本のエンジニアや研究者にとっても、Tokenizers v1の導入メリットは大きい。既存のコードベースや学習済みモデルの重みを一切変更することなく、依存パッケージを更新するだけで前処理パイプラインの高速化を享受できる。特に大量の日本語コーパスを前処理する事前学習フェーズや、秒間数千リクエストを処理する商用APIサーバーにおいて、CPU負荷の軽減とインフラコスト削減に直結する。
なお、特殊な正規化ルールやカスタム事前分割器(Pre-tokenizer)を独自に組み込んでいる環境において、エッジケースでの完全な挙動一致が保たれているかについては、各プロジェクト環境での事前テストが推奨される。
分析と今後の展望
AIモデルの巨大化とインフラコストの肥大化が続く現在、演算アクセラレータだけでなくCPU側のデータ準備パイプラインを極限まで効率化する取り組みが重要性を増している。Hugging Faceがエコシステムの基盤であるTokenizersを大幅刷新したことは、PyTorchや各種推論エンジン全体の効率向上を底上げする。主要なモデルハブとしての地位を強固にしつつ、本番運用に耐えうる実用的なオープンソース基盤を提供する同社の姿勢を示すリリースといえる。
引用元:Hugging Face