Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月14日(月)のニュース一覧へ引用元:Google Cloud 引用元:Google Cloud
Google Cloud、TPU v6eのGemma 3推論性能を公開
Google
Gemma
ベンチマーク
クラウドコンピューティング
半導体
結論:ワークロード特性による推論スケーリングの壁を定量解明
米Google Cloudは自社公式ブログにおいて、AIアクセラレータ Cloud TPU v6e(Googleの第6世代AI専用プロセッサ(Trillium)) 上でオープンウェイト言語モデル Gemma 3(Googleが開発したオープンウェイトの大規模言語モデルファミリー)(12Bおよび27B)を運用した推論ベンチマーク結果を公開しました。
調査では、入力が大きく出力が小さい「分類タスク」と、出力が大部分を占める「長文生成タスク」で推論挙動が根本的に異なることを実証しました。事前入力処理(プリフィル)主導の分類では両モデルとも高いスケーラビリティを維持する一方、逐次生成(デコード)主導の生成タスクでは、27Bモデルが同時64ユーザーを超えるとパフォーマンスの上限に達することを定量的に示し、本番環境のサイズ適正化指針を提示しています。
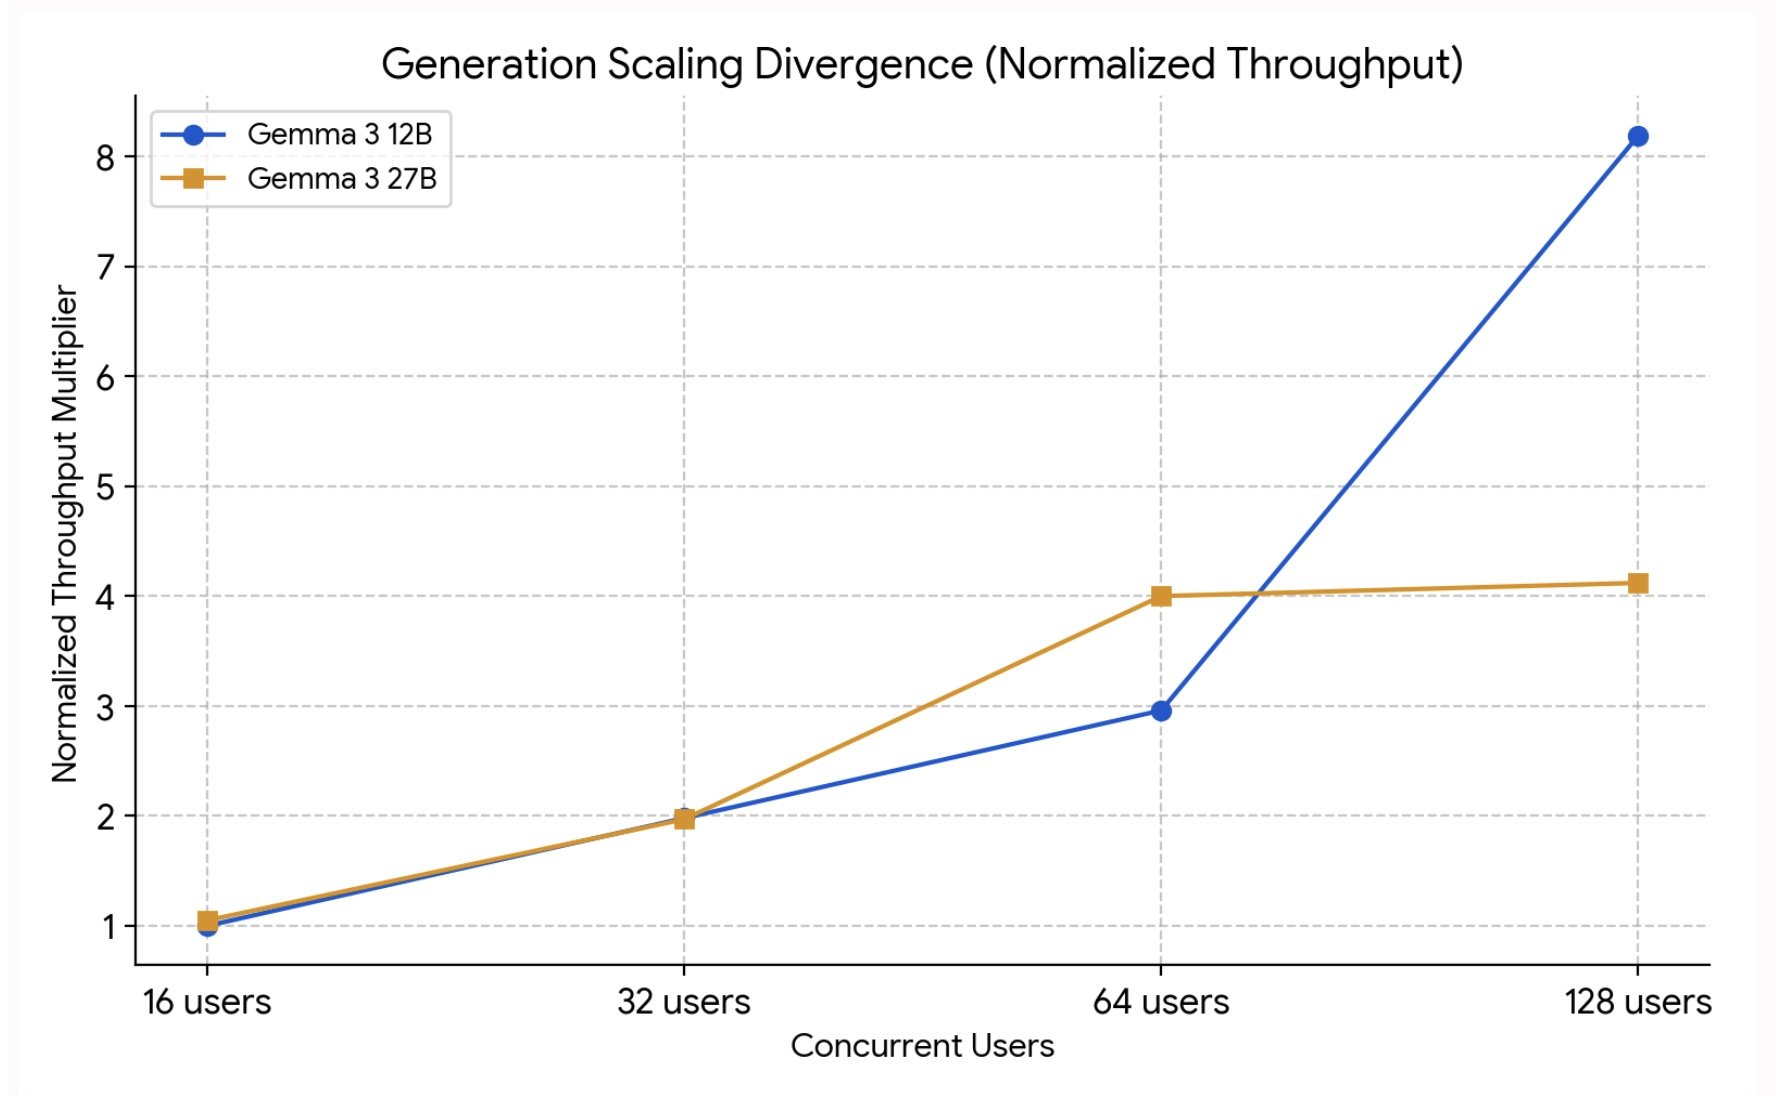
確認済みの事実:2つのワークロードと推論スケーリングの測定結果
公開された技術レポートによると、検証環境にはGoogle Kubernetes Engine(GKE)Autopilotクラスタを用い、2×2チップトポロジで構成された単一ホストのTPU v6eノードプールを接続。推論サービングエンジンには vLLM(高速なオープンソースLLM推論・サービングフレームワーク)(vllm-project/tpu-inference)を採用し、max-model-len=128000、max-num-batched-tokens=8192、max-num-seqs=512 のグローバル設定で測定を行いました。
検証された2つのワークロードとスループットの推移は以下の通りです。
- 分類タスク(高入力・低出力): 入力シーケンス長約4,000トークン、出力シーケンス長約10トークンのEコマースコンプライアンス判定を想定。プリフィル処理が支配的なこのタスクでは、12Bモデルと27Bモデルのスケーリング挙動にほぼ差がなく、同時128ユーザー時に正規化スループット係数は12Bが6.37倍、27Bが6.04倍に達しました。
- 生成タスク(低/中入力・高出力): 入力500トークン、出力約1,000トークンの分析的提言書作成を想定。同時64ユーザーまでは両モデルとも同等にスケール(12Bが2.96倍、27Bが4.00倍)しましたが、同時128ユーザー時において12Bが8.19倍まで線形にスケールしたのに対し、27Bは4.12倍で頭打ち(飽和)となりました。
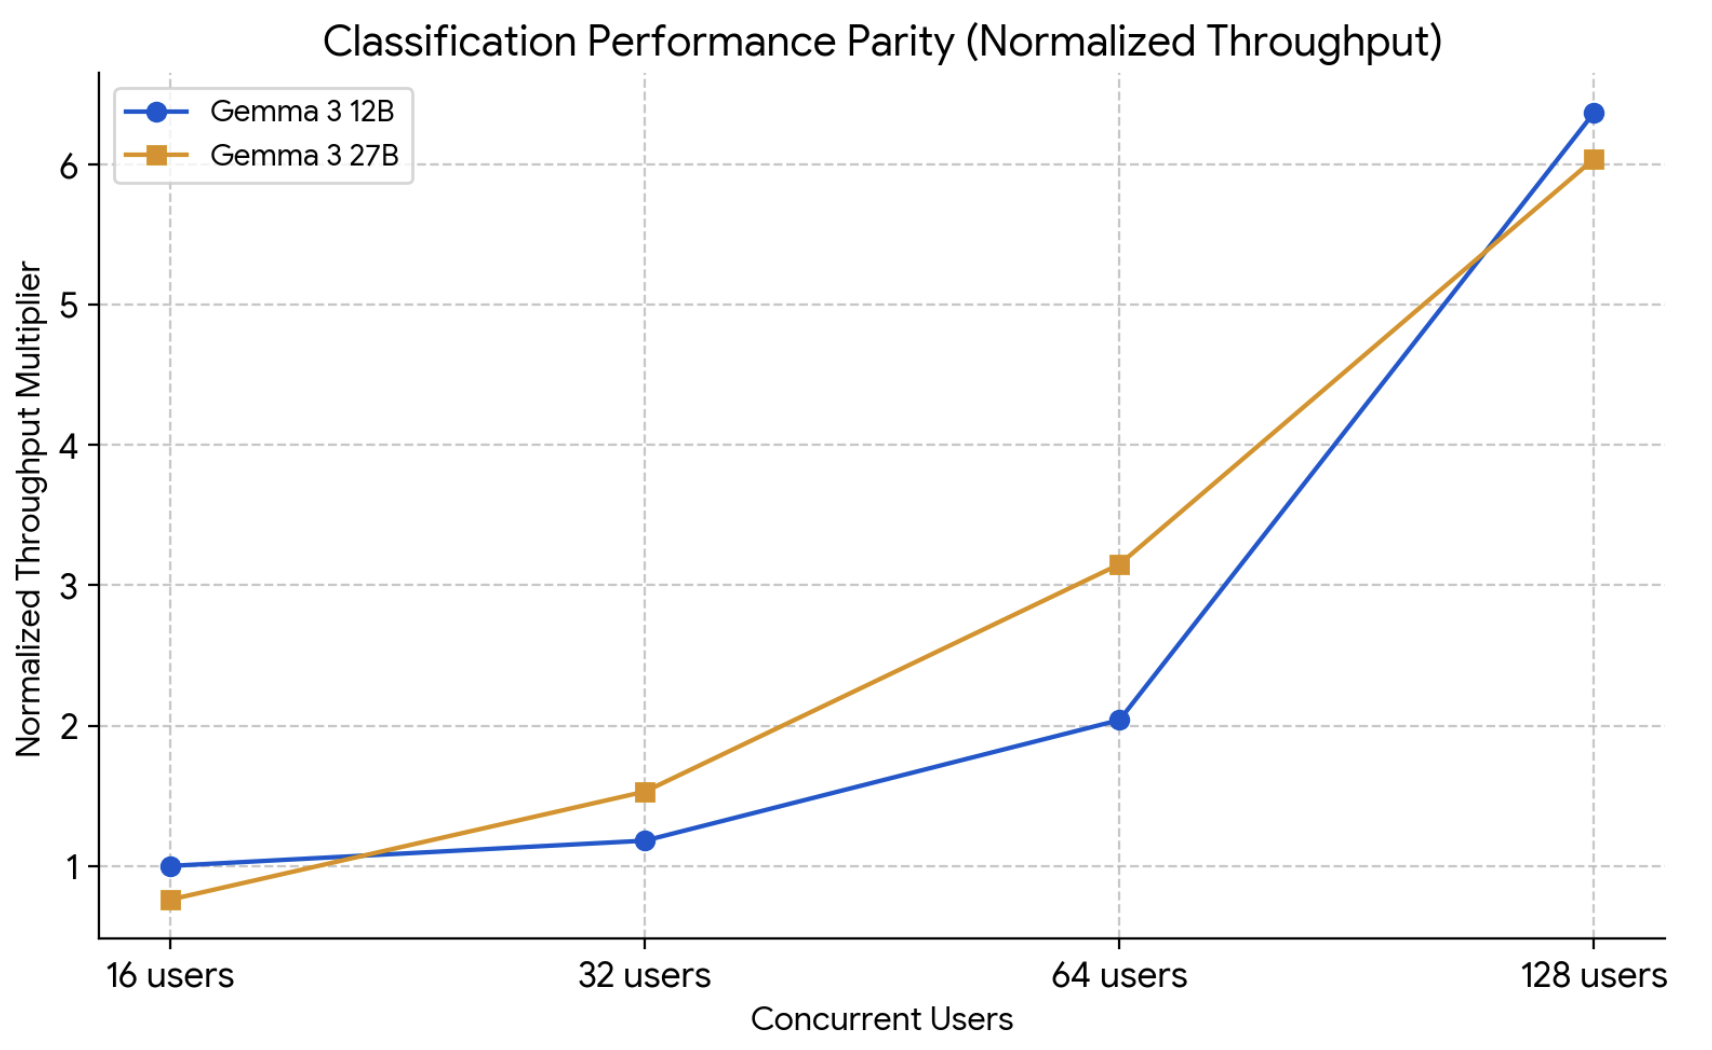
エンドツーエンド(E2E)のレイテンシ分析では、分類タスクにおいて12Bモデルはユーザー数が32人から64人に増えた時点でレイテンシが約2倍に跳ね上がり、リソース競合が発生しました。一方の27Bモデルでは64人まで比較的横ばいを維持し、128人で2倍に達するなど、パラメータ規模とタスクによる飽和点の違いが確認されています。
独自価値要素:タスク別サイジング指針とvLLM最適化ノウハウの整理
ベンチマーク結果に基づき、Google Cloudのエンジニアは本番環境における実用的なサイジングおよび設定指針を以下のように整理しています。
| ワークロード種別 | 入力/出力トークン比 | スケーリング挙動と飽和特性 | アーキテクチャ推奨設計 |
|---|---|---|---|
| 分類・要約 | 入力大(約4,000)/出力小(約10) | 27Bでもスループット低下なし(128人で6.04倍) | スループットを損なわずに表現力の高い Gemma 3 27B を安全に選択可能 |
| 長文生成 | 入力小(約500)/出力大(約1,000) | 27Bは同時64人超で急激に飽和(4.12倍止まり) | 高負荷時は 12B に切り替えるか、27BのPodあたり同時接続を 64 に制限 |
さらに、ハードウェア飽和に伴う深刻なレイテンシ悪化やリクエストのサイレントドロップを防ぐため、以下の実践的な回避策が示されています。
- レイテンシ駆動のスケーリング: CPUやメモリ使用率に基づく標準トリガーではなく、エンドツーエンド(E2E)レイテンシ指標を監視してPodの自動スケーリングを実行する。
- バケットパディングの最適化: TPU固有のvLLMバケットパディング環境変数(
VLLM_TPU_BUCKET_PADDING_GAP)を積極的に調整し、メモリ断片化と計算リソースの無駄を排除する。
分析・展望:モデルパラメータ一辺倒から「ワークロード整合型インフラ」へ
今回の公開データは、LLMの推論効率がモデルのパラメータ数だけで決まるものではなく、サービングフレームワーク、チップアーキテクチャ、そしてプロンプトと生成トークンの比率の組み合わせによって大きく変動することを実証しています。
単一の大型モデルをあらゆる用途に使い回すのではなく、タスクのトークン形状(プリフィル重視かデコード重視か)に応じてモデルサイズと同時実行上限を個別に設計することが、クラウド上のユニットエコノミクス(単位コストあたりの処理性能)を最大化する鍵となります。
引用元:Google Cloud


