Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月7日(月)のニュース一覧へ引用元:ITmedia AI+
AI知能指標v4.2公開、Claude Fable 5.1が首位獲得
Anthropic
Claude
ベンチマーク
研究
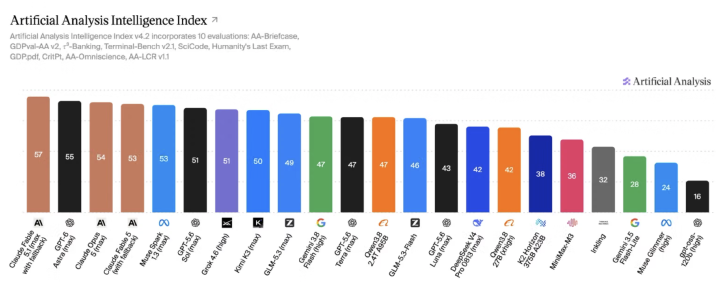
AIモデルの第三者性能評価を手掛ける米Artificial Analysisは、知能指標「Intelligence Index」の最新版となるv4.2を公開した。より複雑で実務的なタスクの評価項目を追加するとともに、非公開テストデータの比重を前バージョンの2倍となる40%へ引き上げ、AI開発企業によるベンチマーク対策(ゲーム化)の排除を図った。今回の改定に伴う総合スコアランキングでは、米Anthropicのフロンティアモデル「Claude Fable 5.1」が首位を獲得した。
非公開データの倍増と評価項目の刷新
Intelligence Indexは、知識労働や高度コーディング、専門領域の知識など多面的な性能を統合して算出される総合ベンチマーク指標である。今回のv4.2では、同社独自開発の実務評価「AA-Briefcase」および米Surge AIが開発したPDF解析能力測定「GDP.pdf」を新規採用した。一方で、主要モデルの間で正解率が飽和状態に達していた「GPQA Diamond」は評価対象から除外された。
最大の変更点は、指標全体に占める非公開テストデータの割合をv4.1時点の20%から40%へ倍増させたことだ。公開ベンチマークへの過剰適合や事前学習データ混入を防ぐ狙いがあり、次期v5ではさらにこの非公開比率を高める方針を示している。
Claude Fable 5.1が首位、GPT-6 Astraが続く
更新後の総合評価において、Anthropicの「Claude Fable 5.1」がトップに立った。次点には米OpenAIの最新鋭モデル「GPT-6 Astra」が続き、前世代の「GPT-5.6 Sol」から4ポイントのスコア向上を記録した。GPT-6 Astraは出力トークンの効率面で他社フロンティアモデルを上回る結果を示したものの、非公開実務データの総合得点ではClaude Fable 5.1が僅差で首位を維持した。
ベンチマークの陳腐化や過学習対策が業界全体の課題となる中、非公開データへの移行を進める独立機関の評価手法が注目を集めている。
引用元:ITmedia AI+


