Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年7月18日(土)のニュース一覧へ引用元:NVIDIA Blog
NVIDIA、次世代AI「Vera Rubin」の効率公開
NVIDIA
半導体
ハードウェア
インフラ
NVIDIA(AI向けGPUおよびシステムソリューションを提供する半導体大手)は、自律的に思考し動作するAIエージェント時代に向け、次世代AIファクトリーの主軸となるチップアーキテクチャ「Vera Rubin(ヴェラ・ルービン)」の設計と性能に関する詳細を公表しました。同社は、推論の処理コストを示す従来の指標である「コスト・パー・トークン(Cost per Token)」の上位概念として、AIの継続的な強化学習プロセスを効率化する「1ドルあたりの知能(Intelligence per Dollar)」という新指標を提唱し、ハードウェア全体のコスト効率を最大化するアプローチを説明しています。
自律型AIに必要な「常時強化学習」を支える新メトリックとVera Rubinの役割
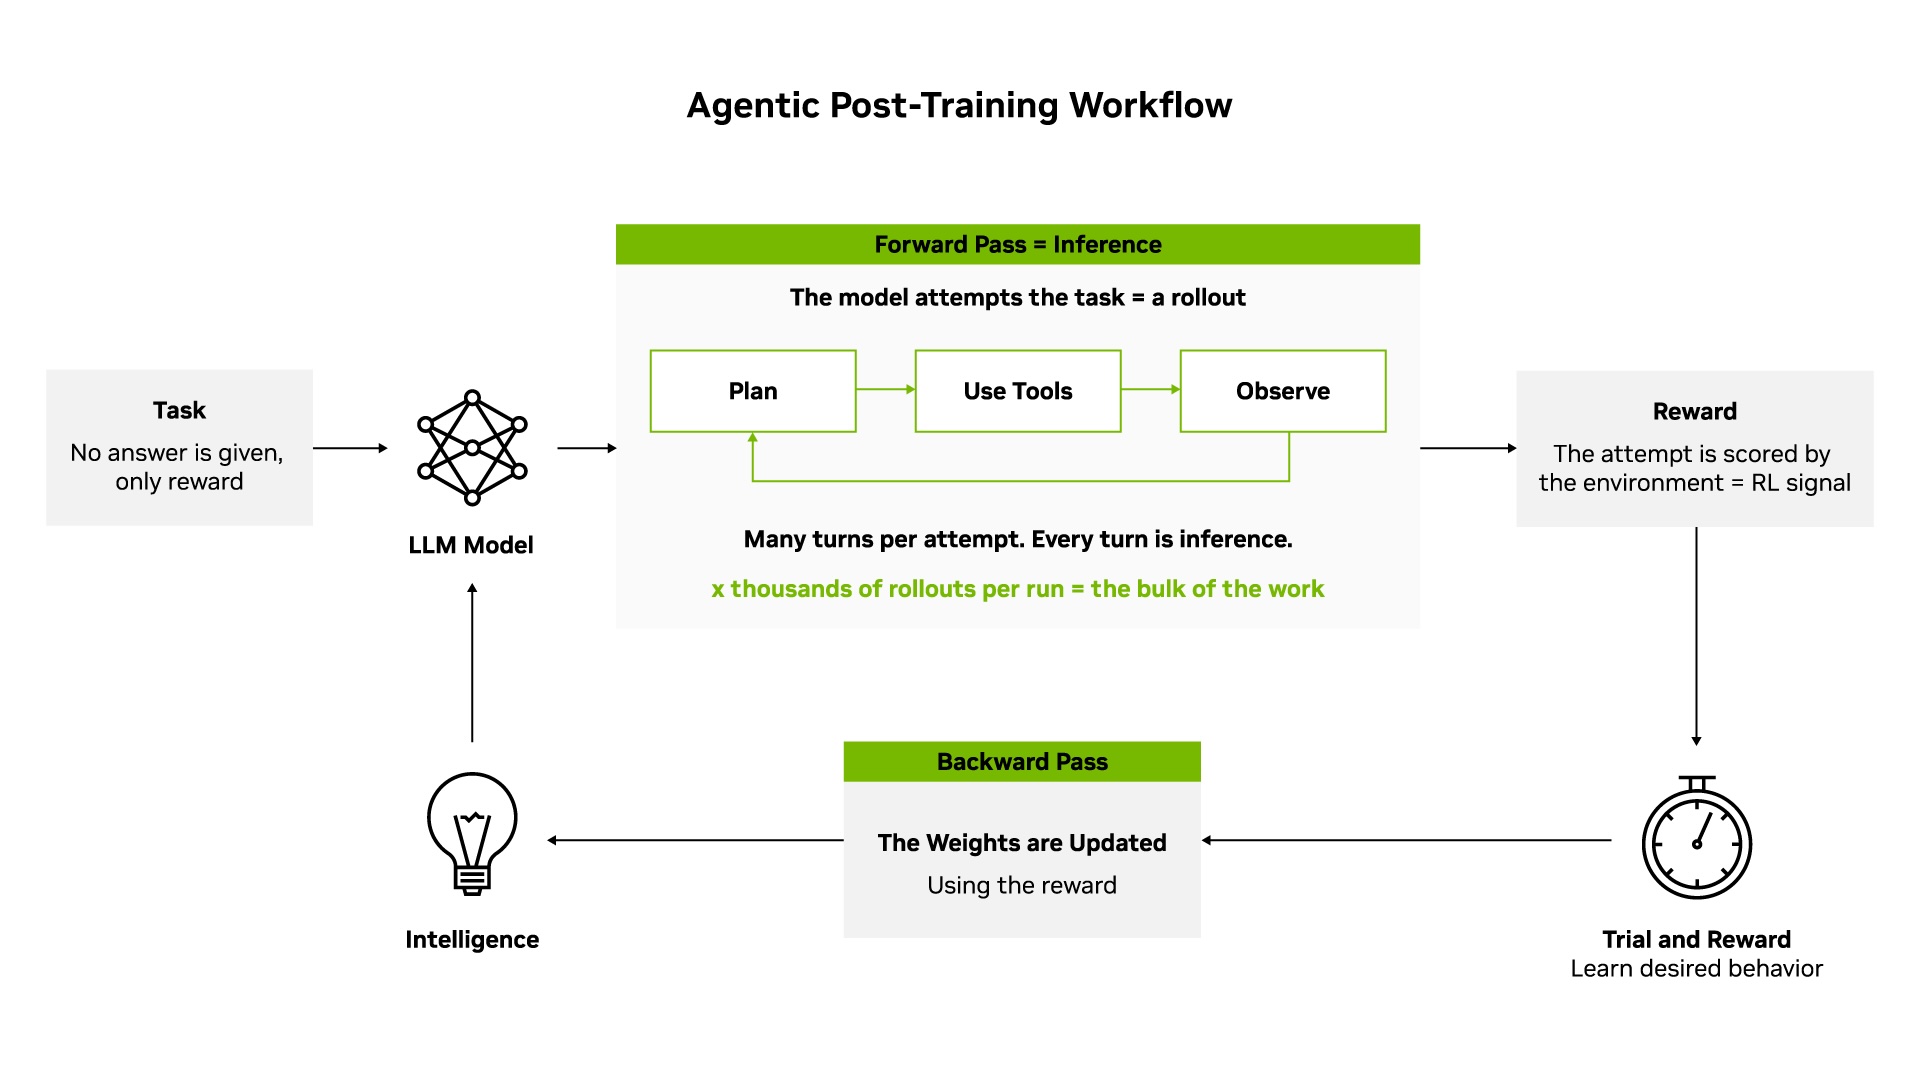
エージェント型AI(Agentic AI)は、単に質問に回答するだけのテキスト生成モデルとは異なり、目標を達成するために自律的に計画を立て、外部ツールを使用し、途中で直面したエラーから自己修正する処理を繰り返します。このため、初期訓練の後に施される微調整フェーズ「ポストトレーニング」が、稼働後の環境変化に合わせて常に更新され続ける「継続的ポストトレーニング」へと進化しています。
NVIDIAが提唱する「1ドルあたりの知能」は、この常時ループする強化学習や微調整モデルを、どれだけ安価に構築し維持できるかを示す指標です。AIインフラそのものの処理単価(コスト・パー・トークン)を下げることは、すなわち知能を構築するためのすべてのプロセスのコスト削減に直結します。
前世代Blackwellの4分の1のGPU数で超巨大モデルの訓練が可能に
Vera Rubinプラットフォームは、この常時稼働する強化学習とロールアウト(自律試行環境)の並行処理に特化してハード・ソフト両面が最適化されています。
- 圧倒的なGPU数削減: 前世代の「Blackwell」アーキテクチャと比較して、超巨大モデルをわずか4分の1(1/4)のGPU数でトレーニングすることができます。
- 自律デバッグ性能の証明: 同アーキテクチャ上で強化学習を用いて構築された、5,500億パラメータを持つ混合専門家(MoE)モデル「Nemotron 3 Ultra」は、現実のソフトウェアバグ修正能力を評価する「SWE-bench verified」において**71.7%**の成功率を記録。およそ10件中7件のオープンソースバグに対して、自律的で正しいコード修正プログラムを作成できる知能を実現しました。
30%のスループット向上を示すVera CPUとパートナー企業の実績
パートナー企業によるVera Rubin世代テクノロジーの初期実証結果も公開されています。
AIスタートアップのPrime Intellectは、NVIDIAの新しい「Vera CPU」を統合した強化学習サンドボックスを検証。その結果、従来の一般的なx86ベースのサーバーアーキテクチャと比較して、CPU単体で平均30%向上したデータスループット(処理密度)を達成しました。
検索AIを提供する Perplexity も、数百台のNVIDIA GPUにまたがる独自の非同期強化学習スタックにこの技術を組み込んでいます。1兆パラメータ規模の巨大モデルの重み(ウェイトデータ)を、学習用ノードと推論用ノードの間で2秒未満で同期するRDMA転送エンジンなどを運用し、実稼働AIの超高速なアップデートサイクルを確立しています。
独自価値:BlackwellとVera Rubinの比較と日本国内へのインパクト
| 評価項目 | 前世代「Blackwell」 | 次世代「Vera Rubin」 |
|---|---|---|
| 主たる設計フォーカス | 高効率なAI推論とフルビルド訓練 | 常時ループする強化学習(ロールアウト並行処理) |
| 同一巨大モデル訓練時のGPU数 | 基準値(100%) | Blackwellの4分の1(25%) に削減 |
| 強化学習でのスループット(Vera CPU) | x86基準値(100%) | 約30%向上 |
日本国内のAI開発者やスタートアップにとっても、GPUリソースの確保とAPIサーバーの運用コストは事業存続に関わる致命的な課題です。トレーニングに必要なGPUが4分の1に減少し、かつ強化学習の処理密度が30%向上するVera Rubinの登場は、開発資本力で大手に劣る国内のAI事業者が、Nemotronなどのオープンモデルを利用して独自の高性能なアクション実行型エージェントサービスを内製・カスタマイズする道を大いに開くことになります。
出典元:NVIDIA Blogの公式記事、Prime IntellectやPerplexityの共同発表。