Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年7月14日(火)のニュース一覧へ引用元:Anthropic公式リサーチ
Claude、言語で価値観が変わる仕組みを解明
Anthropic
Claude
Claude Opus
Claude Sonnet
研究
AI安全性
LLM
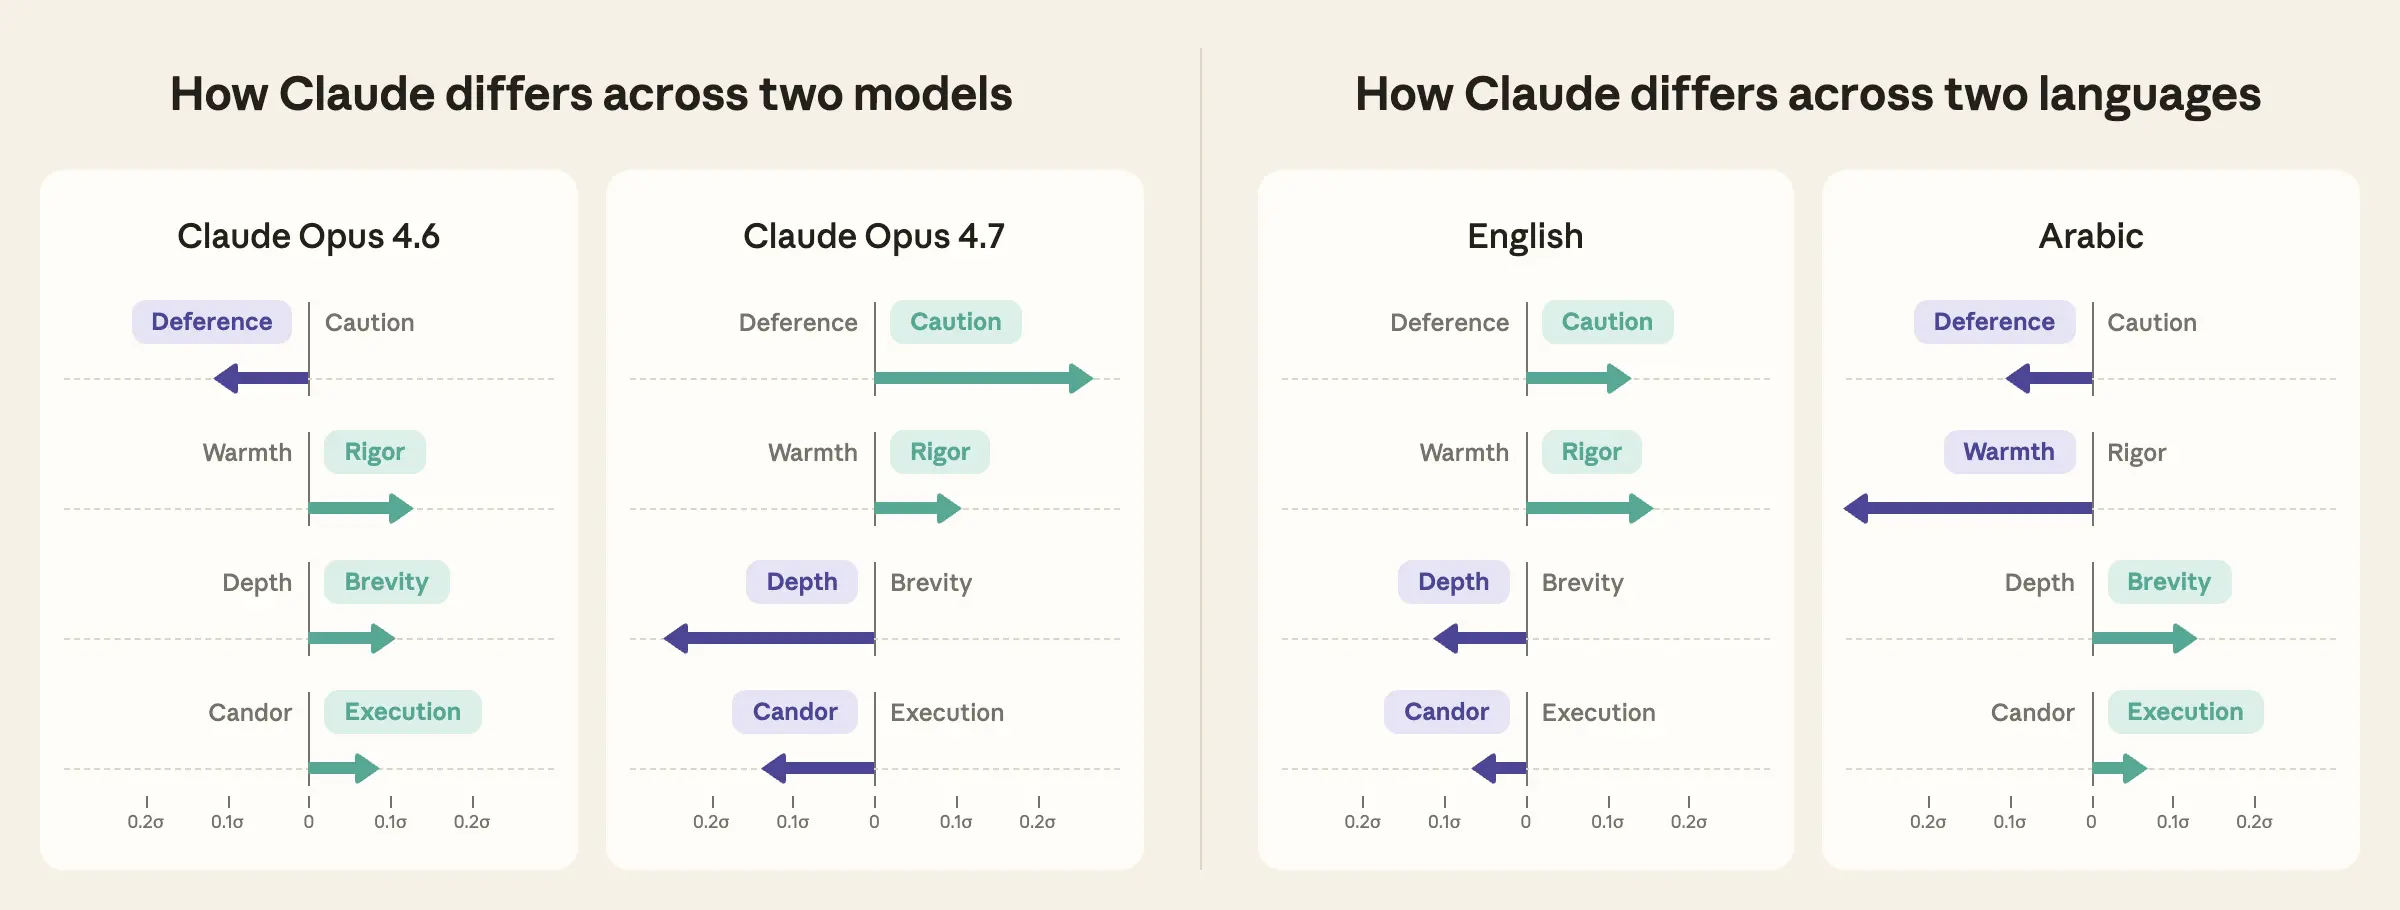
Anthropicは2026年7月13日、AIアシスタントClaude(Anthropicが開発するAIアシスタント)の対話サービス「Claude.ai」における約30万件の対話データを分析し、使用するモデルや言語によってClaudeが表現する「価値観」がどう異なるかを定量的に測定した研究結果を公開した。AIの応答に反映される数千の価値観を4つの軸に圧縮することで、モデル間・言語間の傾向の違いを可視化できる手法を提案している。
3,000超の価値観を4軸に圧縮する手法
本研究は、先行研究「Values in the Wild(Anthropicの先行調査。70万件の対話から3,000超の価値観を特定)」で特定された3,000以上の価値観を339項目に集約し、さらに次元削減(高次元データを少数の主要な軸に圧縮する統計手法)を適用して以下の4軸に整理した。
| 軸 | 一方の極 | もう一方の極 | 代表的な振る舞い |
|---|---|---|---|
| Deference vs. Caution | 同調(ユーザーの要求に寄り添う) | 慎重(リスクや危害を防ぐ) | 要求の肯定 vs. リスク警告 |
| Warmth vs. Rigor | 温かさ(肯定・励まし) | 厳密さ(正確性・透明性) | ユーモア vs. 前提の誤り指摘 |
| Depth vs. Brevity | 詳細(ニュアンスを含む説明) | 簡潔(最小限の回答) | 推論過程の提示 vs. 要点のみ |
| Candor vs. Execution | 率直(限界や不確実性を示す) | 実行(洗練された結果の提示) | 自身の誤りへの言及 vs. 自信ある回答 |
これら4軸は、会話のタスク・トピック・ユーザー側の価値観を統制した後の分散の**15%**を説明する。分析対象は2026年5月の2週間に収集された約30万件の対話で、Sonnet 4.6(Anthropicの中型Claudeモデル)・Opus 4.6・Opus 4.7の3モデル×上位20言語から各約5,000件を均等にサンプリングしている。
Sonnet 4.6とOpus 4.7で異なるキャラクター傾向
モデルごとの価値観プロファイルには明確な差異が確認された。
| モデル | 傾向が強い軸 | 特徴的な振る舞い |
|---|---|---|
| Sonnet 4.6 | 同調・温かさ・簡潔 | ユーモアや励まし、ユーザーのアイデアを肯定 |
| Opus 4.6 | 厳密さ・同調・簡潔 | 要点を簡潔に伝え、リクエスト範囲に留まる |
| Opus 4.7(Anthropicの最新大型Claudeモデル) | 慎重・厳密さ・詳細・率直 | 前提の誤り指摘、リスク警告、自身の限界の表明 |
Anthropicによれば、この結果はモデルに対する社内外の主観的な評価とも一致する。たとえばOpus 4.7は「回答をより慎重に留保する傾向がある」というClaude.aiユーザーの指摘と合致し、Sonnet 4.6は公式ローンチ時に「温かく、正直で、向社会的」と説明されていた。
ヒンディー語では温かさ、英語では厳密さが顕著
同一のリクエストであっても、使用言語によってClaudeが表現する価値観には大きな差があることが判明した。4軸のうち特に言語間の差が大きかったのは「温かさ vs. 厳密さ」軸である。
- ヒンディー語・アラビア語: 丁寧な挨拶、ユーモア、ユーザーのアイデアへの肯定など温かさ関連の価値観が顕著
- 英語・ロシア語: 前提の修正要求、証拠の確認、正確性の強調など厳密さ関連の価値観が強い
- アラビア語: 4軸すべてで最も「同調」「簡潔」寄り
- 英語: 4軸すべてで最も「慎重」「詳細」寄り
- オランダ語: 率直さ(自身の誤りの認知)が最も高く、インドネシア語は実行寄り
研究チームは具体例として、同じ事業計画へのフィードバックをヒンディー語とロシア語でそれぞれ依頼した場合、Claudeが異なる価値観でフレーミングするため、利用者が受ける印象に差が生じうることを指摘している。
言語間差異の要因と未解明の課題
この差異の原因として、研究チームは以下の仮説を挙げつつ、いずれも未確定としている。
- 学習データの量と構成の偏り: 言語によってデータ量が大きく異なり、専門的テキストの割合にも差がある
- 文化的コミュニケーション規範の反映: 言語圏ごとの会話規範にClaudeが適応している可能性
- 意図的な制御の欠如: ClaudeのConstitution(Claudeの行動指針を定めた文書)は温かさや慎重さなどの基本的価値観を規定しているが、それらが言語間でどう変動すべきかは規定していない
日本語利用者にとっての意味
本研究の分析対象にはClaude.ai上位20言語が含まれており、日本語もその対象に入る。ただし、日本語での具体的な価値観プロファイルの数値は本研究では個別に詳述されていない。英語では厳密さ・慎重さ寄りの傾向が確認されているが、日本語での傾向がそれと同じかどうかは本研究からは判断できない。日本語でのClaude利用において、丁寧さの度合いや回答の詳細さに関する違和感がある場合、本研究が示す言語間のバイアスがその一因である可能性がある。
モデル評価への統合と残る課題
Anthropicは本手法をモデルのリリース前評価および展開後モニタリングに組み込む方針を示している。具体的には、キャラクタートレーニングの調整やシステムプロンプトの変更が価値観プロファイルに期待どおり反映されるかを検証する用途が想定されている。
ただし、研究チーム自身が認めているとおり、現時点では以下の点が未解明である。
- 価値観の差異がユーザーの信頼や意思決定の質にどう影響するかの実証データがない
- モデル間の差異がキャラクタートレーニングのどの段階に起因するかの特定ができていない
- 年齢・職業・地域などの人口統計的シグナルが価値観の表現にどう影響するかも未検証
言語間で利用者の体験が異なるという現状を可視化したことで、意図せぬバイアスの所在を特定する第一歩にはなるが、「どの差異が望ましく、どの差異が是正すべきか」という判断は今後の課題として残されている。
引用元:anthropic.com


