Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年6月11日(木)のニュース一覧へ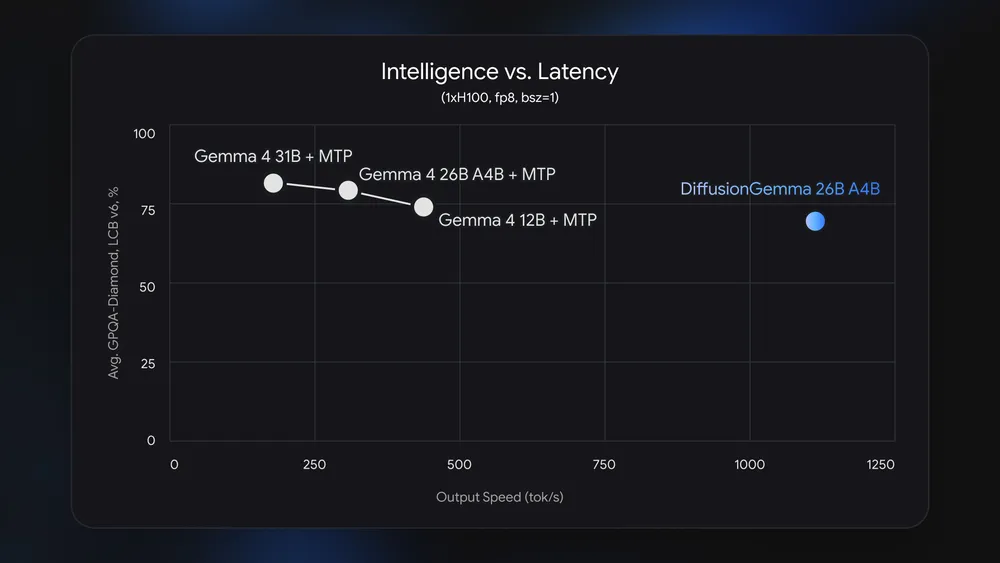
引用元:Google Blog 
Google
4倍速い拡散言語モデル「DiffusionGemma」公開
DeepMind
NVIDIA
Gemma
オープンソース
エッジAI
LLM
Google DeepMindは2026年6月10日、テキスト生成を飛躍的に高速化する実験的オープンモデル「DiffusionGemma」をリリース(Apache 2.0 ライセンス)しました。従来のLLM(大規模言語モデル)が採用している自己回帰(1語ずつ順次予測する手法)プロセスとは異なり、画像生成AIと同様にノイズからテキストを並列で復元する「テキストディフュージョン(Text Diffusion)」アプローチを採用したのが特徴です。26BのMixture of Experts(複数の専門モデルを組み合わせる手法、推論時のアクティブパラメータは3.8B)構成をベースとし、ローカルGPU環境などで最大4倍の高速化を実現します。
1. テキストディフュージョンのメカニズムと利点
従来のLLMは「タイプライター」のように左から右へ1文字ずつトークンを予測するため、推論がメモリ帯域幅(データの転送速度)に依存する「Memory-bound」になり、ローカルGPUの計算資源を十分に活用できませんでした。これに対し、DiffusionGemmaはランダムなプレースホルダーで構成された256トークンの「キャンバス」を同時に処理する「印刷機」のような動作をします。これにより処理が演算能力依存(Compute-bound)にシフトし、NVIDIA Tensorコアなどの並列演算能力を最大限に引き出すことができます。 また、全トークンが相互に接続する「双方向アテンション(双方向の注意機構)」を使用するため、確定したトークンの情報から前後の内容をリアルタイムで自己修正(再デノイズ:ノイズを取り除いて元のデータを復元する処理)する機能や、複雑なMarkdown、数式グラフ、コードの穴埋め(Code Infilling)などを得意とします。
2. NVIDIA GPUでの最適化と動作要件
今回のリリースにあたりGoogleはNVIDIAと緊密に連携し、ハードウェアスタック全般で最適化を行いました。パフォーマンス面では、単一のNVIDIA H100 GPUで毎秒1,000トークン以上、最新のGeForce RTX 5090で毎秒700トークン以上、GB100搭載のDGX Spark deskside personal AI supercomputerで毎秒150トークン以上の超高速推論を実現しています。26BのMoEモデルながら、量子化によってVRAM 18GB以下に収まるため、コンシューマ向けのハイエンドGPUでもローカルに動作します。Hugging Face Transformers、vLLM、Unsloth、NVIDIA NeMoなどでサポートが提供されています。
DiffusionGemmaは、エッジやローカル環境における開発ループ、インライン編集、エージェントループなどの低並行性・低遅延のリアルタイム対話型アプリに強みを持っています。一方で、GoogleおよびNVIDIAは、本モデルの出力品質自体は通常の自己回帰型「Gemma 4」よりも低いため、高品質が求められるプロダクション用途や、リクエストをバッチ処理で効率化できるクラウドserving(高QPS)環境では従来のGemma 4の使用を推奨しています。 しかし、Sudokuの解法タスクにおけるファインチューニングのデモ(正答率がベースの0%から80%へ劇的に向上)に象徴されるように、双方向アテンションがもたらす新しい推論特性は、非線形テキストドメインにおけるAI活用の新たな可能性を提示していると見られます。
参考ソース
DiffusionGemma: 4x faster text generation - blog.google
An overview of DiffusionGemma, an exceptionally fast text generation model with up to 4x faster speeds.
https://blog.google/innovation-and-ai/technology/developers-tools/diffusion-gemma-faster-text-generation
NVIDIA Blog
NVIDIA Accelerates Google DeepMind’s DiffusionGemma for Local AI - NVIDIA Blogs - blogs.nvidia.com
The new DiffusionGemma open model generates text in parallel — not one token at a time — and is optimized to run on the NVIDIA RTX PRO platform, NVIDIA DGX Spark systems and GeForce RTX GPUs.
https://blogs.nvidia.com/blog/rtx-ai-garage-local-gemma-diffusion
GIGAZINE
GoogleがGemma 4より4倍高速な拡散言語モデル「DiffusionGemma」をオープンモデルとして公開、数独が得意なファインチューニングモデルもあり - gigazine.net
2026年6月10日、Googleがオープンモデルの「DiffusionGemma」を公開しました。DiffusionGemmaは主流の自己回帰モデルではなく拡散言語モデルであり、高速応答が求められる分野での活躍が期待されています。
https://gigazine.net/news/20260611-google-ai-diffusiongemma
窓の杜
Google、ローカルAIが4倍速くなるテキスト生成モデル「DiffusionGemma」を実験的に発表、逐次ではなく一括で生成/「GeForce RTX 5090」で700トークン/秒超を達成 - forest.watch.impress.co.jp
米Google DeepMindは6月10日(現地時間)、実験的なオープンモデル「DiffusionGemma」を公開した。テキスト拡散(text diffusion)と呼ばれる手法を採用したモデルで、GPUで利用した場合、一般的なローカルLLMよりも最大4倍の高速推論を実現。スピードがとくに重要視される対話型のローカルワークフローに適しているという。
https://forest.watch.impress.co.jp/docs/news/2116179.html


