Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月25日(日)のニュース一覧へ引用元:Mashable
Block、音声のみで学習した全二重音声AI「Dessa」発表
音声AI
研究
マルチモーダル
エッジAI
AI安全性
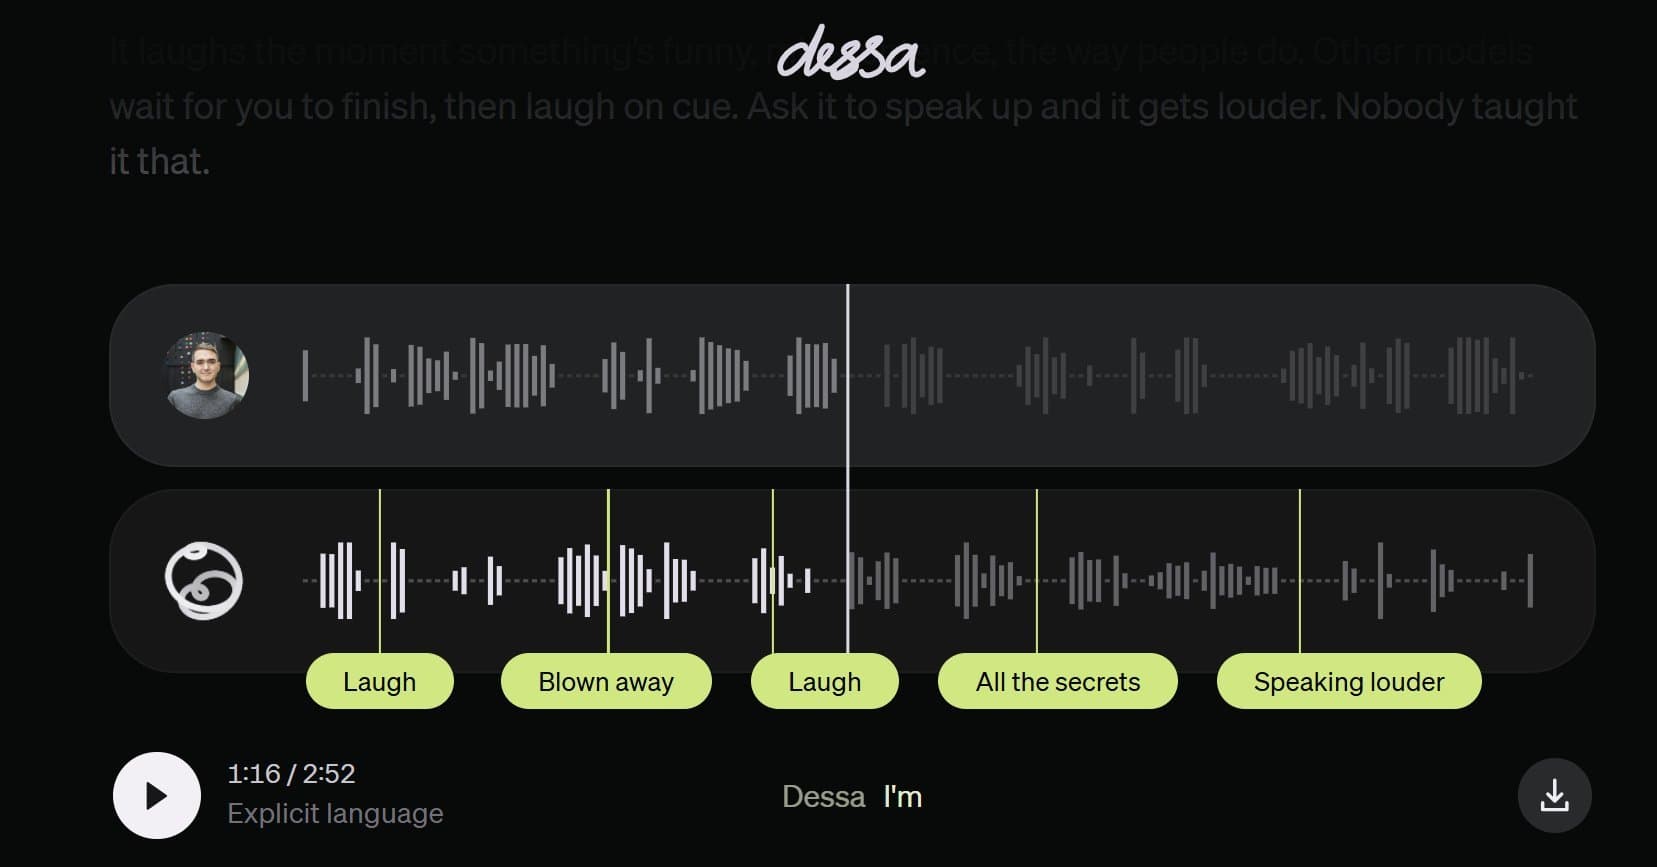
Jack Dorsey(ジャック・ドーシー)氏が率いる米Blockは2026年10月25日、テキストデータを一切使用せず、人間の肉声による会話音声のみからスクラッチ学習された全二重(full-duplex)音声AIモデル「Dessa(Blockが開発した人間の音声会話のみで事前学習された全二重音声AIモデル)」を発表した。従来の音声AIのように音声をテキストに変換してLLMで処理するパイプラインを排し、音声波形をそのまま理解・生成するEnd-to-End設計により、ため息や皮肉、笑い声、自然な相槌や割り込みといった感情表現をリアルタイムで双方向に対話できる。

テキストを介さない「聴いて学ぶ」アーキテクチャ
Block公式発表(block.xyz/dessa)によると、Dessaは事前学習済みのテキストLLMや文字起こしデータを一切使わずに開発された。人間が幼少期に文字を知る前に音声のやり取りだけで会話を習得するように、純粋な音声会話データのみを学習源としている。
公式発表で示された主な技術的特徴は以下の通りである。
- 全二重(Full-Duplex)対話: 相手の発話を聞きながら同時に発話することが可能。相槌(「うん」「なるほど」)や会話の途中の笑い、適切なタイミングでの割り込みを自律的に判断
- 感情・ニュアンスのダイレクト処理: 声の震え、皮肉、抑揚、息遣いなどを音声波形から直接抽出し、感情に応じた声色とトーンで応答
- 単一のNVIDIA GB200 NVL72で学習: 膨大なテキストコーパスを要する従来モデルに比べ、限られた音声データセットと計算リソース(1ラックのGB200 NVL72)で効率的に収束
- ローカル推論対応: 実時間よりも高速に推論可能で、Apple M4 Maxチップを搭載したMacBook Proなどの端末上で完全にローカル動作
従来のテキスト変換型音声AIとの構造比較
従来の音声AI(Siri等の音声アシスタントや、多くのLLM音声モード)とDessaのアーキテクチャおよび機能差は下表のように整理できる。
| 項目 | 従来の音声AIパイプライン | Block「Dessa」 |
|---|---|---|
| 処理構造 | 音声認識(STT)→ テキストLLM → 音声合成(TTS)の3段階 | End-to-End 音声波形入出力(Speech-to-Speech) |
| 学習データ | 兆単位トークンのWebテキスト + 音声コーパス | 人間の対話音声のみ(テキストゼロ) |
| 会話のタイミング | 相手の発話終了を待ってから生成(半二重) | 同時送受信の全二重(相手の話中に相槌や割り込みが可能) |
| 失われる情報 | テキスト変換時に抑揚・皮肉・ため息・震えが脱落 | 声のトーンや感情のニュアンスをそのまま保持・反映 |
| 稼働要件 | クラウドAPI連携が主流 | MacBook Pro M4 Max等でローカル動作可能 |
音声AIの安全性とHMIの将来展望
BlockのDessa開発チーム(トロントのAIスタートアップDessa出身の研究者らで構成)は、本モデルを開発した理由として「好奇心」「人間とAIの真の相互理解」に加え、「安全性」を挙げている。従来の音声AIはユーザーが激痛や極度のパニック状態にあっても声のトーンを認識できず、平坦なテキスト応答を繰り返してしまう危険性があった。声の感情や危機感を直接理解することは、将来の自律AIエージェントにおける重要な安全防壁となる。
現時点でDessaは一般公開されておらず、予期せぬリスクや課題を検証するため、外部のAI安全性研究者を対象とした先行アクセス募集が行われている。テキストを介さない真の音声対話AIの登場は、コールセンター業務や車載システム、介護・パーソナルアシスタントなど、感情理解が不可欠な領域のインターフェースを根本から塗り替える可能性を秘めている。
引用元:Block's latest AI model Dessa was trained entirely on human speech — and it shows / Block's new AI model Dessa was trained entirely on human speech to catch emotions text-based models miss / Dessa - the Conversation Model trained only on speech | ITmedia NEWS
参考ソース
Mashable
Block's latest AI model Dessa was trained entirely on human speech — and it shows
Jack Dorsey and Block, Inc. just took us one step closer to the singularity and it's simultaneously awesome and terrifying.
https://mashable.com/tech/block-unveils-new-ai-model-dessa-trained-entirely-on-human-speech
The Decoder
Block's new AI model Dessa was trained entirely on human speech to catch emotions text-based models miss
Block, the company behind Square and Cash App, has introduced Dessa, a speech model that processes audio directly instead of converting it to text first. Dessa is designed to recognize emotions, sarcasm, and pauses in real time. The model runs locally on a MacBook Pro M4 Max but isn't publicly available yet.
https://the-decoder.com/blocks-new-ai-model-dessa-was-trained-entirely-on-human-speech-to-catch-emotions-text-based-models-miss
ITmedia NEWS
ジャック・ドーシー氏率いるBlock、音声だけで学習した全二重音声モデル「Dessa」発表 「人と話しているよう」
Block(旧Square)は、テキストや事前学習モデルを使わず、人間の会話音声のみで学習させた全二重音声モデル「Dessa」の研究プレビューを発表した。相づちや感情の抑揚を直接聞き取り表現できるのが特徴で、NVIDIAのラック1台で学習されており、MacBook Proでローカル実行できる。一般提供時期は未定。
https://www.itmedia.co.jp/news/article/2610/26/2000002574