Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月25日(日)のニュース一覧へ引用元:NVIDIA Nemotron
NVIDIA、会話モデル「Nemotron Bolt」公開
NVIDIA
Gemma
オープンソース
エッジAI
LLM
AIエージェント
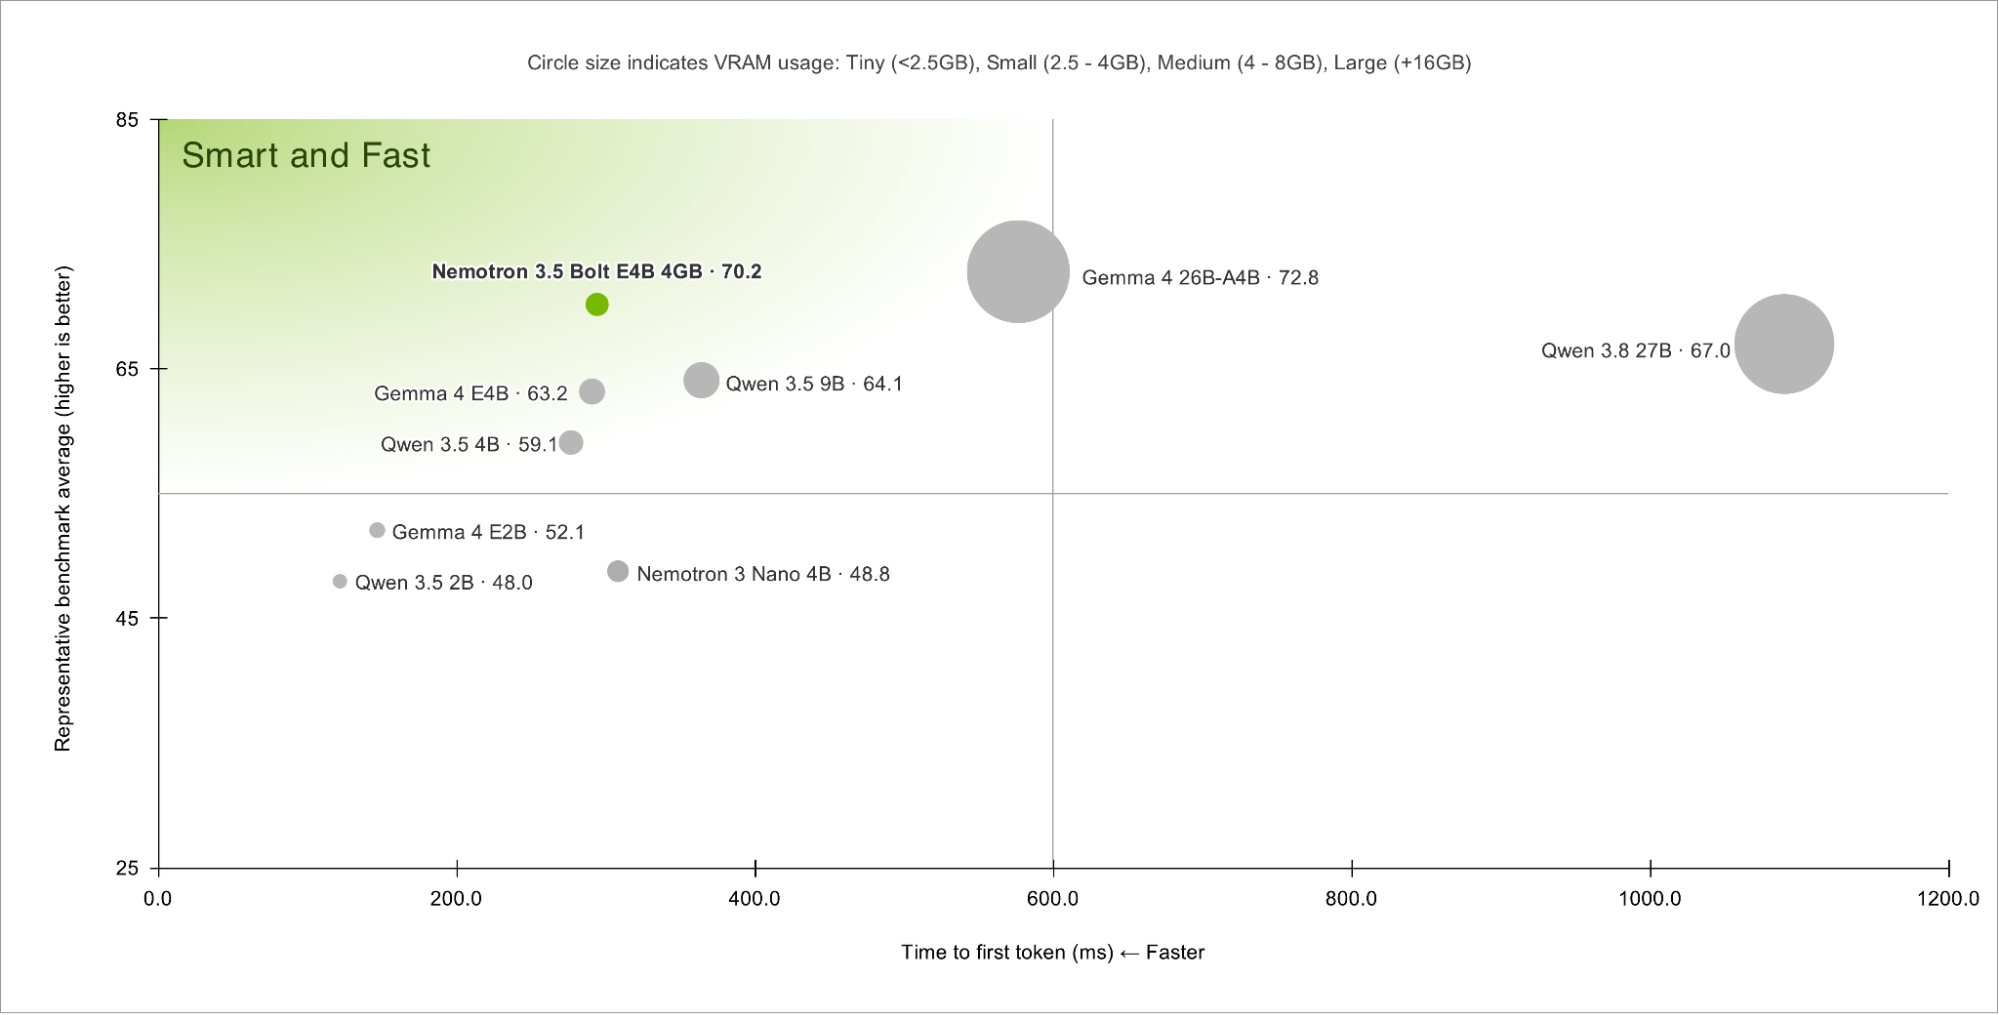
米NVIDIAのResearchチームは2026年10月23日(現地時間)、音声アシスタントやゲームNPC、ロボティクス向けの小型オープン言語モデル「Nemotron 3.5 Bolt E4B 4GB(NVIDIAが開発した会話・ツール呼出特化の4GB級小型モデル)」を公開した。Googleの「Gemma 4 E4B」をベースに独自の強化学習を施したモデルであり、約4GBのVRAM(ビデオメモリ)フットプリントで動作しながら、前世代モデル比で約40%高い応答品質と最大80%の出力トークン削減を実現している。
会話と自律ツール連携に特化したアーキテクチャ
Nemotron 3.5 Bolt E4B 4GBは、総パラメータ数8Bのうち計算実行時の重みが4B相当(Effective 4B)のアーキテクチャを採用している。NeMo-RLおよびNeMo-Gymを用いた強化学習(RLVR/RLHF)により、多ターンのツール呼び出しやシステム指示の優先順位遵守、簡潔な対話応答能力が徹底して強化された。
公式発表および技術報告書で示された主な特徴は以下の通りである。
- 多ターン・ツール連携: 会話の文脈に応じた非同期ツール呼び出しやAPI連携に対応
- 対話モード: 短く自然な話し言葉で応答する
conversational_modeを搭載 - 思考制御(Reasoning): 複雑な要求に対する思考モードのON/OFF切り替えと遅延に応じた予算制限が可能
- 64Kコンテキスト長: 会話履歴やツール定義、外部知識を包括的に保持
- 並列ドラフター「DFlash」: 1回の順伝播でドラフトトークンを並列提案・検証し、親モデル比で最大21%のスループット向上を達成
特筆すべき点として、開発陣はSFT(教師あり微調整)をあえて排除し、強化学習のみで事後学習を行っている。SFTを挟むとツール呼び出し精度は上がるものの、会話の自然さと簡潔さが退行したためである。
実機検証による性能比較と親モデルとの差異
国内クラスメソッド(DevelopersIO)による検証記事では、NVIDIA DGX SparkおよびJetson Orin Nano Superの実機環境において、親モデルであるGemma 4 E4B-itや競合モデル(Qwen3.5 4B)との詳細な性能比較が報告されている。
| モデル・構成 | 単発速度 (tok/s) | 日本語課題 (10問) | コード生成 | 長文指示遵守 | ツール呼出 |
|---|---|---|---|---|---|
| Nemotron 3.5 Bolt E4B (DFlash) | 128.79 | 8/9 (思考ON/OFF同等) | 5/5 (全通過) | 遵守 | 5/5 (適切に自律判断) |
| Gemma 4 E4B-it (MTP) | 139.35 | 8/9 | 3/5 | 逸脱あり | 過剰呼出あり (2回に1回) |
| Qwen3.5 4B (ドラフトなし) | 68.06 | 8/9 (16Kトークン消費) | 5/5 | 逸脱あり | required時0件返却 |
実測において、DGX Spark上のllama.cppではDFlash有効時に単発 128.79 tok/s、8並列で合計 355.81 tok/s を記録した。また、思考をOFFに設定した場合でも日本語課題の正答率は8/9を維持しつつ、処理所要時間が55.2秒から15.1秒へと4分の1近くに短縮された。
さらに親モデルとの比較では、Gemma 4が説明だけで済む問いに対しても不要なツール呼び出しを行ったり長文指示を落としたりしたのに対し、Bolt E4Bは指示の優先順位を遵守し、過剰なツール呼び出しを行わない挙動が確認されている。
エッジ対話エージェントの実装インパクト
本モデルの真価は、高性能な対話能力を小型エッジハードウェアで常駐稼働させられる点にある。Jetson Orin Nano(8GB)環境でも量子化版(Unsloth UD-Q4_K_XLなど)を用いることで14.68 tok/sで動作し、音声インターフェースやロボットの受付窓口として十分実用的なレスポンスが得られる。
128GBのDGX Sparkやワークステーション環境では、Bolt 74Bなどの超巨大モデルの横に常駐させ、会話やツール呼び出しの一次受付をBolt E4Bが担い、重厚な推論のみを後段の大規模モデルへ割り振る多層エージェントパイプラインを1台のマシン上で容易に構築できる。オープンライセンス(OpenMDW-1.1)のもと、Hugging FaceやOllama、llama.cppから即座に利用可能である。
引用元:NVIDIA Nemotron 3.5 Bolt E4B 4GB / 4GB の会話モデル「Nemotron 3.5 Bolt E4B」を DGX Spark で動かしてみた
参考ソース
NVIDIA Nemotron
NVIDIA Nemotron 3.5 Bolt E4B 4GB
We are releasing NVIDIA Nemotron 3.5 Bolt E4B 4GB, an open small language model optimized for speed and intelligence per GB in conversational agents.
https://research.nvidia.com/labs/nemotron/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB
クラスメソッド発「やってみた」系技術メディア | DevelopersIO
4GB の会話モデル「Nemotron 3.5 Bolt E4B」を DGX Spark で動かしてみた
Nemotron 3.5 Bolt E4B 4GB を DGX Spark の llama.cpp で測りました。DFlash ありで単発 128.79 tok/s、日本語 8/9、コード生成 5/5。親の Gemma 4 E4B と同条件で並べ、8GB の Jetson でも試しました。
https://dev.classmethod.jp/articles/dgx-spark-nemotron-3-5-bolt-e4b-4gb-first-touch

