Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月22日(木)のニュース一覧へ引用元:NVIDIA Blog
NVIDIA、シミュレーション加速cuDSSを一般提供開始
NVIDIA
開発者ツール
半導体
インフラ
研究
米NVIDIAは2026年10月21日(現地時間)、工学や科学分野の大規模シミュレーションをGPUで高速化する新ライブラリ「NVIDIA cuDSS(大規模な疎行列直接ソルバーをGPUで計算するためのCUDA-Xアクセラレーションライブラリ)」(CUDA Direct Sparse Solver)の一般提供(GA)を開始したと発表しました。航空機・先端半導体・産業機械などの設計プロセスにおいてボトルネックとなっていた「大規模疎行列の直接解法」をGPUにオフロードすることで、従来のCPU処理と比較して最大10倍の計算スループットを実現します。
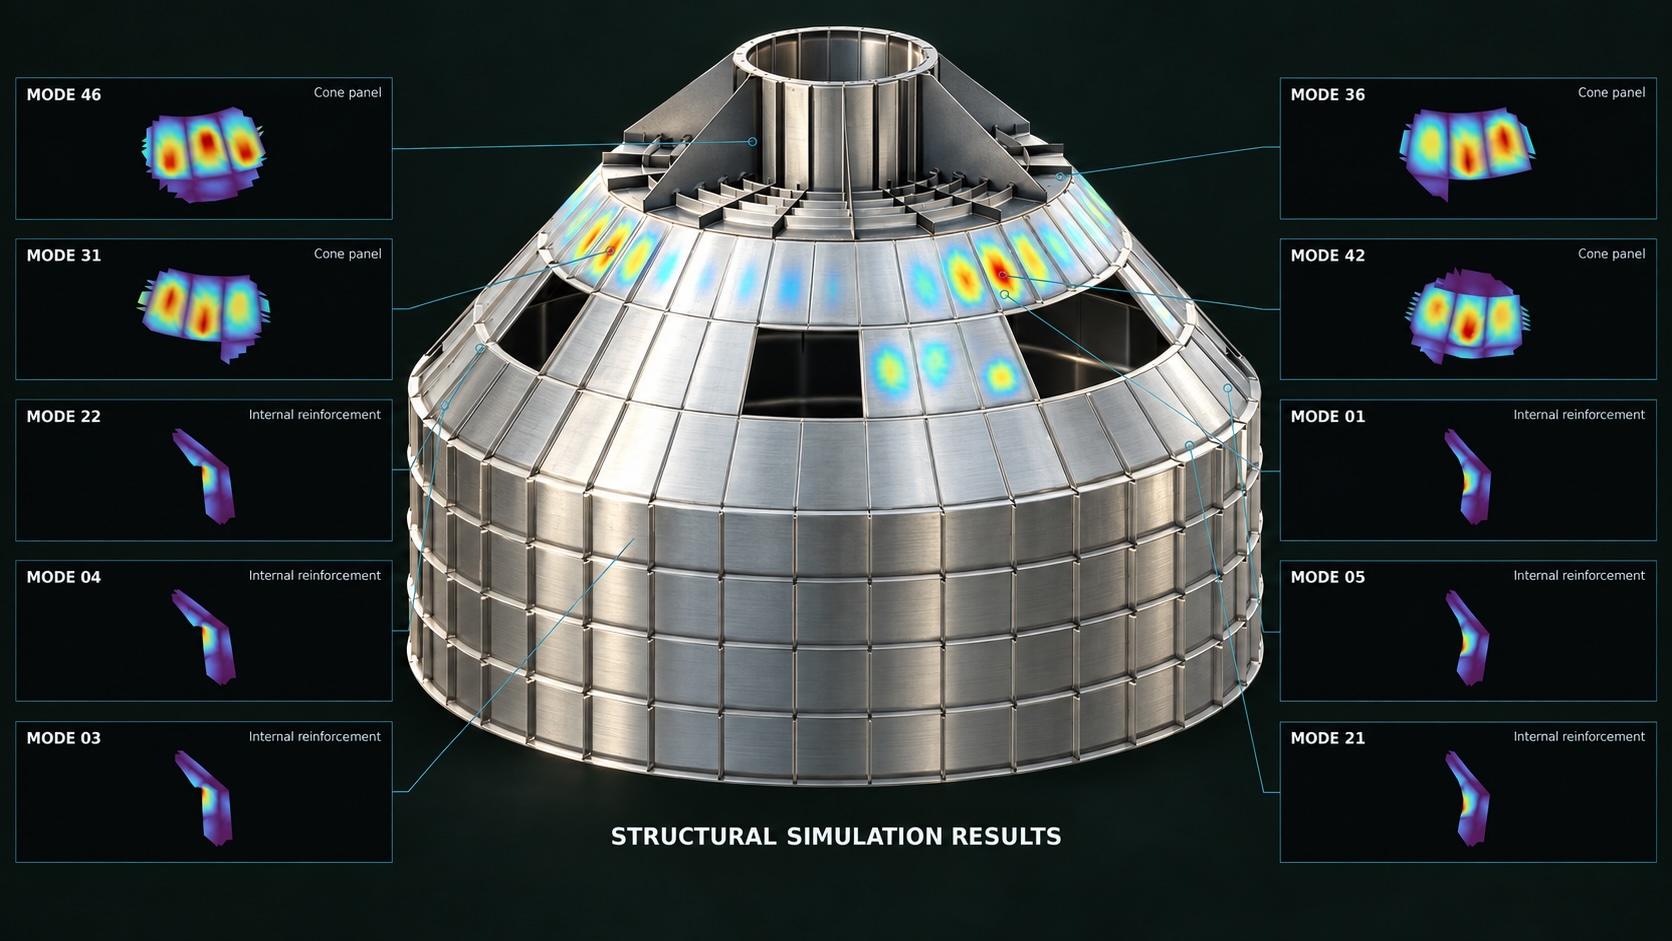
大規模疎行列直接ソルバーのGPUオフロードと産業界での導入成果
現代の先端製造業や物理科学研究では、製品を実際に試作する前にコンピューター上で挙動を予測する数値シミュレーションが不可欠となっています。しかし、モデルが高精度・複雑化するにつれて方程式の求解に膨大な時間がかかり、検証できる設計案の数が制限される課題がありました。
cuDSSは、シミュレーションの反復処理の中で最も計算負荷が高い「疎行列(大部分の要素がゼロである行列)の直接解法」をGPUで並行処理します。すでに主要なエンジニアリングソフトウェア企業が自社ツールへの統合を進めており、具体的な高速化実績が公表されています。
- 半導体材料・欠陥解析(Applied Materials): 物理解析・欠陥シミュレーション基盤「Ginestra」にcuDSSを組み込み、CPU単体処理と比較して最大10倍の高速化を達成しました。半導体材料の探索とデバイス信頼性評価の期間を大幅に短縮しています。
- EUV露光プラズマ解析(COMSOL / ZEISS SMT): 「COMSOL Multiphysics」とcuDSSの組み合わせにより、次世代半導体製造に不可欠なEUV(極端紫外線)リソグラフィのプラズマシミュレーションで4倍の高速化を実測し、計算全体を6日と14時間で完了させました。
- 熱・応力解析(Cadence): 3Dチップ設計や先端パッケージの熱解析ツール「Celsius」にcuDSSを統合し、Nokiaなどの顧客における複雑な設計解析を加速しています。
- 構造解析・電磁界解析(Dassault Systèmes): 「Abaqus」構造解析および電磁界ソルバーにおいて、8〜10倍の性能向上を報告しています。
- 流体構造連成解析(Siemens): 「Simcenter STAR-CCM+」において流体と構造の相互作用シミュレーションを高速化しています。
- デバイスシミュレータ(Synopsys): 先端ロジック・パワー半導体向け「Sentaurus Device」にcuDSSを適用し、Infineon等のデバイスモデリングを支援しています。
比較:従来のCPU直接法ソルバーとcuDSSによるGPU加速
工学シミュレーションで広く利用されてきた従来のCPUベース疎行列直接ソルバー(Direct Sparse Solver)と、今回GAとなったcuDSSの主な特徴の比較は以下のとおりです。
| 項目 | 従来のCPUソルバー(Intel MKL PARDISO等) | NVIDIA cuDSS(CUDA-X) |
|---|---|---|
| 主計算デバイス | マルチコアCPU | NVIDIA GPU(単体ワークステーション〜HPCクラスタ) |
| 計算スループット | コア数とメモリ帯域がボトルネック | GPUの広帯域メモリと並列処理コアを活用し最大10倍高速 |
| 対応言語・API | C / Fortran中心 | C、C++、Python、Fortranの各インターフェースに対応 |
| 展開容易性 | 既存コードの修正が必要なケースが多い | 標準的なAPI設計により既存CAE・EDAツールへ迅速に組み込み可能 |
| スケーラビリティ | 単一ノード内のSMP並列が中心 | 1台のPCから複数ノードの大規模クラスタまで拡張可能 |
日本の産業界への影響と今後の展望
日本には自動車、精密機械、半導体材料・製造装置などの高度な製造業基盤が存在し、CAE(計算力学支援)やEDA(電子設計自動化)ツールによるシミュレーションの高速化は国際競争力に直結する重要テーマです。
今回のcuDSSのGAにより、Dassault Systèmes(Abaqus)やSiemens(STAR-CCM+)、Synopsys、Cadenceといった日本の製造業で標準的に使われている商用CAE/EDAツールにおいて、順次GPUによる大幅な高速化の恩恵を受けられる環境が整います。従来のCPUクラスタで数日〜数週間かかっていた設計検証サイクルが短縮され、試作回数の削減や開発期間の短縮につながるとみられます。
なお、現時点では各商用ソフトウェアの次期アップデートにおけるcuDSS組み込みバージョンの国内提供開始時期や、ライセンス体系への影響については各ベンダーからの個別発表を待つ必要があります。NVIDIAはGTC Berlinの展示ブースにてDassault SystèmesとともにcuDSSの実機デモを公開しており、製造業のデジタルツインやフィジカルAI開発を支える計算基盤として普及が進むとみられます。
引用元:NVIDIA Blog