Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月20日(火)のニュース一覧へ引用元:Google Developers Blog 引用元:Google Developers Blog
Google、エッジAI向けLiteRT Tensor APIを発表
Google
エッジAI
開発者ツール
オープンソース
C++ネイティブでエッジ向けモデルの構築とゼロコピー最適化を実現
Googleは、エッジデバイス向けAI実行フレームワークLiteRT(旧TensorFlow Liteから発展したGoogleのオンデバイスAIランタイム)において、C++ネイティブ言語でTensorレベルのモデル構築と最適化を直接行える新レイヤー「LiteRT Tensor API」を公開した。これまで主流だった学習済みモデルの変換パイプラインに加え、開発者が計算グラフの演算子(Op)を直接記述し、CPU、GPU、NPUをまたぐゼロコピーのデータ共有やモデルの高速化を単一のコードベースで実現できるようにする。
従来のエッジ最適化の課題とTensor APIの4大特徴
エッジAIの現場では、PyTorchなどからLiteRT Torch(PyTorchモデルをLiteRT形式に変換するツール)を経由してランタイムへ渡す変換手法が最も手軽で推奨される。しかし、最新のモデル構造の試行や低レベル最適化を行う場合、従来のC++やシェーダー言語による手書き実装では、MetalやOpenCL、Vulkanといったハードウェア固有のバックエンドごとにコードを書き直す必要があり、CPU・GPU・NPU間のバッファ同期やデータコピーのオーバーヘッドも大きな負担となっていた。
今回発表されたLiteRT Tensor APIは、以下の4つの主要機能によりこの課題を解決する。
- 計算グラフ構造の完全制御: Scaled Dot-Product Attention、RMSNorm、KV-cache更新などのLLM(大規模言語モデル)向け複合Opを含むすべてのOpの配置・接続を開発者が直接決定できる。
- 重みデータの直接取り込み: Hugging Faceの
.safetensorsファイルなどのモデルチェックポイントから、中間の変換スクリプトを介さずに直接重みをロードできる。 - Tensor中心のゼロコピーバッファ相互運用: 前処理、モデル推論、後処理の各工程がアクセラレータ上の共有バッファ経由でテンソルを直接受け渡すため、CPUを経由したデータの往復コピーが発生しない。
- AIコーディングエージェントとの連携: 構造化されたプリミティブで構成されるプレーンなC++コードであるため、AIコーディングエージェントがモデルグラフの生成、書き換え、各デバイス向けチューニングを自動実行しやすい。
実証例:SAM 2がWebGPU上で3倍以上高速化、Apple MLX比1.5倍
Googleは実証として、Metaの画像・動画セグメンテーションモデル「SAM 2(Segment Anything Model 2)」をLiteRT Tensor APIのC++で実装した。前処理から画像エンコーダ、マスクデコーダ、後処理に至るパイプライン全体をGPU上で完結させ、CPUへのデータ転送を排除している。
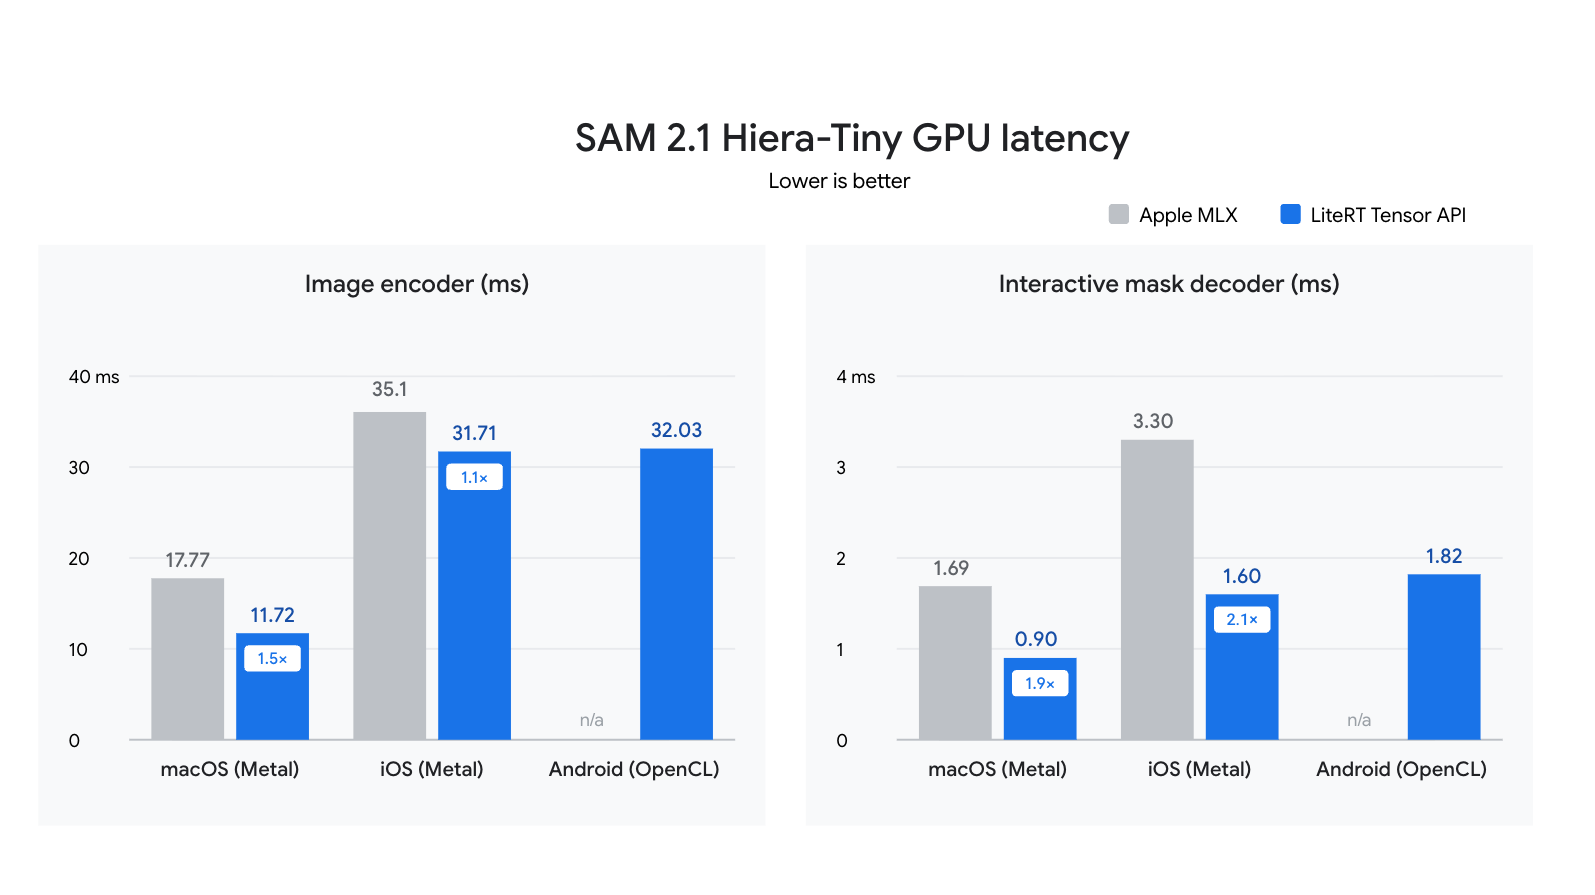
Googleのコーディングエージェント「Antigravity」による最適化では、オブジェクトの可視性判定をWebGPU環境でCPUにフォールバックさせずGPUフレンドリーな演算に書き換えるなどの改善が行われ、512×512解像度での処理速度が毎秒10フレーム未満から30フレーム超へと3倍以上高速化された。MacBook Proでのベンチマークテストでは、Appleの機械学習フレームワークMLX(Apple Silicon向けに最適化された機械学習フレームワーク)と比較して約1.5倍高速に動作した(fp16、画像エンコーダおよびマスクデコーダ)。さらに同一のC++コードがmacOS(Metal)、iOS(Metal)、Android(OpenCL)でポータブルに動作することが実証されている。
2系統の実行パス:XNNPACK直接実行とLiteRT形式エクスポート
LiteRT Tensor APIでは、開発ワークフローに応じて2つの実行パスが選択できる。
| 実行方式 | 利用ランタイム / バックエンド | 特徴と用途 |
|---|---|---|
| ダイレクトCPU実行 | XNNPACK(ARMやx86向けの高効率ニューラルネットワーク演算ライブラリ) | モデルファイルのビルド不要。.safetensorsから重みを即座に読み込みCPUで高速に反復検証 |
| LiteRTエクスポート | LiteRTランタイム(CPU / GPU / NPU) | .tflite形式としてエクスポート。モバイルアプリやLiteRT.jsを通じたブラウザWebGPU実行に配備 |
開発者はXNNPACKパスで素早くプロトタイピングとアルゴリズム検証を行い、実機配備時に.tfliteを出力して各種アクセラレータへデプロイするという柔軟な開発サイクルを構築できる。
エッジAI最適化の自動化と今後の展望
Googleは今後、GPU向け「ML Drift」バックエンドの直接サポート拡充、NPU向け最適化Opの追加、全グラフの自動量子化機能、画像サイズやシーケンス長の変化に対応する動的シェイプ(dynamic shape)のサポートを進めるとしている。さらに、Pythonからのオーサリング環境も提供予定である。
LiteRT Tensor APIの登場は、単にC++開発者の利便性を高めるだけでなく、AIエージェントがハードウェア仕様に合わせてモデル構造自体を自律的に書き換えて最適化する「エージェント駆動型コンパイル」へのシフトを加速させる動きとみられる。
