Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月16日(金)のニュース一覧へ引用元:ITmedia AI+
ITmedia、Claude Haiku 5.5の日本語実務性能を検証
Anthropic
Claude
Claude Haiku
ベンチマーク
LLM
IT系ニュースメディアのITmedia AI+は、米Anthropicが2026年10月7日にリリースした最軽量モデル「Claude Haiku 5.5(Anthropicが提供する高速・低コスト向けの大規模言語モデル)」について、日本のビジネス実務を想定した3つの課題による性能検証結果を公開した。「Claude Sonnet 5.5」および米OpenAIの競合モデル「GPT-6 Luna」と比較した結果、定型的な議事録作成では上位モデルに匹敵する品質を約18分の1のコストで達成したものの、文脈に応じた自身の立場の把握が求められる複雑タスクでは回答のブレが確認された。
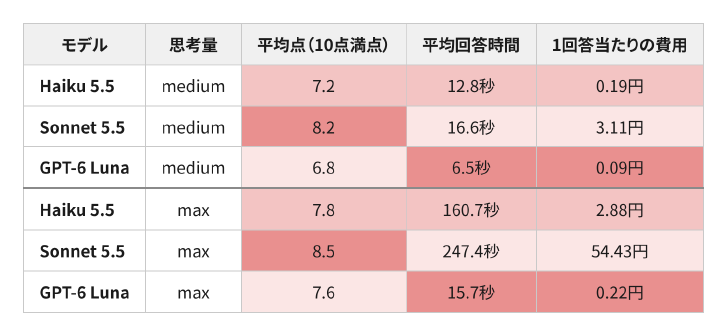
3つの実務タスクにおけるスコアとコスト検証
ITmediaの検証では、思考量設定を「medium」と「max」に切り替え、各設定で3回ずつ回答を生成(計54回答)。Claude Fable 5.1およびGPT-6 Astraによるブラインド評価(10点満点)の平均点を算出した。
- 課題1(納期遅延のお詫びメール): medium設定ではGPT-6 Lunaが平均8.8点で首位。Haiku 5.5は8.0点とSonnet 5.5(8.3点)に迫り、指定文字数を全回で遵守した。一方、max設定ではSonnet 5.5が9.5点に伸長したのに対し、Haiku 5.5は7.8点へと低下し、思考量を増やしても品質が上がらない挙動が観測された。
- 課題2(走り書きメモからの議事録作成): medium設定のHaiku 5.5は平均7.2点を記録し、Sonnet 5.5と同点となった。所要時間は11.6秒(Sonnet 5.5は16.4秒)、1回答あたりの費用は0.18円とSonnet 5.5(3.22円)の約18分の1に抑えられた。
- 課題3(英文メールの要約・論点整理・返信): Haiku 5.5のmedium設定は平均6.3点にとどまり、3回中2回で取引上の立場を取り違える誤りが発生した。max設定では8.2点まで改善したが、回答に254.1秒・4.68円を要し、Sonnet 5.5のmedium(25.3秒・4.69円・9.0点)と同等のコストで所要時間が10倍に達した。
思考量設定と上位モデルとの費用対効果の逆転現象
検証データから浮き彫りとなった各モデルの特性と運用上の選定基準を以下に整理する。
| 課題・指標 | Haiku 5.5 (medium) | Haiku 5.5 (max) | Sonnet 5.5 (medium) | GPT-6 Luna (medium) |
|---|---|---|---|---|
| 定型議事録 スコア | 7.2点 | 7.3点 | 7.2点 | 5.5点 |
| 複雑要約 スコア | 6.3点 | 8.2点 | 9.0点 | 6.0点 |
| 3課題平均時間 | 12.8秒 | 160.7秒 | 16.6秒 | 7.5秒 |
| 3課題平均費用 | 0.19円 | 2.88円 | 3.11円 | 0.09円 |
最大思考量(max)に設定した場合、Haiku 5.5は思考トークンを大量に出力(Artificial Analysisの指摘では1タスク約16万2000トークン)するため、API従量課金が跳ね上がり、Sonnet 5.5の通常思考(medium)とコストが変わらなくなる。したがって、「Haiku 5.5を限界まで深く考えさせる」よりも「最初からSonnet 5.5を通常設定で走らせる」方が短時間かつ高精度な成果を得られる。
軽量モデルの適材適所とハイブリッド運用への示唆
本検証結果は、LLMの選択において「単価の低さ」だけでなく「タスク難度と思考量設計」を考慮した適材適所のアーキテクチャ設計が不可欠であることを示唆している。
- Haiku 5.5が真価を発揮する領域: フォーマットが決まったテキスト抽出、メモからの構造化整理、軽量な分類タスクなど、定型的な推論で完結する業務。
- Sonnet 5.5以上を充てるべき領域: 契約交渉、立場や前提知識の推論を伴うビジネスメール、長文の複雑な論点整理。
企業におけるAIエージェントの構築においては、単一モデルですべての処理を賄うのではなく、Haiku 5.5のような軽量モデルを定型前処理やサブタスクに配置し、中核の意思決定を上位モデルが担うハイブリッド運用の設計が実効的なコスト最適化につながる。
引用元:ITmedia AI+


