Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月14日(水)のニュース一覧へ引用元:Microsoft Copilot Blog
Microsoft、Copilotにプロンプト注入防御層を導入
Microsoft
Microsoft 365 Copilot
セキュリティ
エンタープライズ
Microsoftは2026年10月13日、公式ブログ「Microsoft Copilot Blog」で、Microsoft 365 Copilot(Microsoft 365アプリに組み込まれた業務向けAIアシスタント)に「信頼を考慮した制御(Trust-Aware Controls)」と呼ぶ新しい防御層を導入すると発表しました。社外から届いたメールのような「信頼できないコンテンツ」を、AIモデルに直接渡さず隔離した経路で変換してから扱う仕組みです。メールや文書に紛れ込ませた悪意ある命令でAIの挙動を乗っ取る攻撃を減らすのが狙いで、Copilotを業務で使う企業の情報システム部門・セキュリティ担当者にとっては、テナント側で有効化を検討すべき設定が増えたことになります。
間接プロンプトインジェクションが既存の権限管理をすり抜ける理由
公式ブログによると、生成AIを業務に取り入れた組織は、従来のアクセス制御・ID管理・データ保護の枠組みに収まらない新しい脅威に直面しています。その代表が間接プロンプトインジェクション(AIが処理するメールや文書に埋め込まれた悪意ある指示でAIを操る攻撃)です。
- 正規のメール・文書・メッセージに悪意ある指示が埋め込まれ、AIがタスクの一部としてそれを読み込む
- 信頼できるプロンプトと一緒にモデルへ渡されると、埋め込まれた指示が「データ」ではなく「命令」として扱われる恐れがある
- 結果として、意図しないデータ開示や回答への不正確な情報の混入などにつながりうる
Microsoftは、この攻撃が既存の権限の範囲内だけで成立しうる点を強調しています。システムはそのコンテンツへのアクセスを許可されており、認証・アクセス管理・データ損失防止が設計どおり動いていても、推論時のリスクは残るといいます。
背景には構造上の違いがあります。従来のコンピューターはハードウェア分離や特権命令などで命令とデータを分けてきましたが、多くの生成AIでは命令とデータが同じ入力の流れの中にトークン(AIモデルが文章を処理する際の最小単位)として並びます。ニューラルネットワーク自体には両者を構造的に分ける仕組みがないため、取り込んだコンテンツに埋め込まれた悪意ある指示も、本来の指示と一緒に処理されてしまうと同社は説明しています。
業界でもこの問題は重視されており、ブログは「OWASP Top 10 for LLM Applications 2026」がプロンプトインジェクションをLLMアプリケーションのアプリケーションレベルで最大のセキュリティリスク(1位)に位置づけている点を挙げています。
Trust-Aware Controlsの4つの処理段階
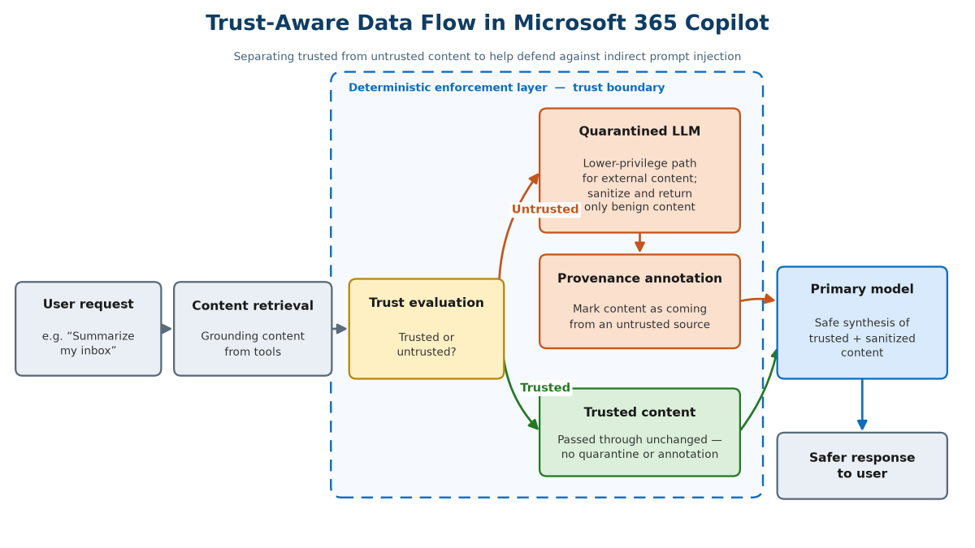
新しい防御層は、Copilotが取得したコンテンツ(ツールの出力)と主たる大規模言語モデルの間に置かれ、信頼できない情報源のコンテンツをモデルの文脈に入る前に処理する「信頼境界」を形成します。公式ブログが示す処理の流れは次のとおりです。
| 段階 | 内容 |
|---|---|
| 信頼度による分類 | 根拠データを取得する際、決定論的な信号でコンテンツを「信頼済み」「未信頼」に分類する。例として、組織外から届いたメールはポリシーにより未信頼と分類できる |
| 隔離と制約付き処理 | 未信頼のコンテンツは主モデルに直接渡さず、機能を制限した隔離経路で、ユーザーの質問の文脈に沿って変換する。有用な情報を残しつつ悪意ある内容を落とす |
| 出所(プロベナンス)の明示 | 未信頼の情報源から来たコンテンツであることを示すマーカーを付け、後段の処理で出所を考慮できるようにする |
| より安全な回答生成 | 主モデルは「変更なしの信頼済みコンテンツ」と「変換・構造化された未信頼コンテンツ」だけを使って回答を作る |
同社はこの層の特徴として、オーケストレーション(処理の段取り)の決まった位置で未信頼コンテンツを確実に捕捉する「決定論的な信号」と、ユーザーの指示に照らして無害な内容だけを残す「構造化された受け渡し」の2点を挙げています。
メール要約で想定される攻撃例
ブログでは、受信トレイの要約をAIに頼むケースが例示されています。業務メールに隠し命令が埋め込まれていると、AIはそのメールを取得してシステムプロンプトと一緒にモデルへ渡し、埋め込まれた命令が出力に影響しうるといいます。この場合アクセスポリシー違反もデータの誤った取り扱いも起きておらず、システムは設計どおり動いているのに、「要約すべきデータ」と「実行すべき命令」を区別できないことが問題だと同社は説明しています。
有効化の条件と提供範囲で未確認の点
公式ブログでは、テナントでこの保護を構成するには、未信頼コンテンツの識別に使うOutlookの送信者設定を有効化し、CVE-2026-55145の構成ガイダンスを確認するよう案内しています。一方で、発表から読み取れない点も残っています。
- 提供状況の幅: 「提供状況と動作はリリース段階やテナント環境によって異なる場合がある」と注記されており、全テナントで一斉に有効になるわけではない
- 対象範囲: 当初の対象は社外とのやり取りを含む「高リスクのコンテンツ」で、他のコンテンツ種別や情報源への拡大は「検討中」とされている
- 効果の数値: 攻撃をどの程度防げるかを示す具体的な遮断率や評価結果は公表されていない。同社自身も「単一の対策ですべての間接プロンプトインジェクションを防げるわけではない」としており、分類器によるフィルタリングや入力の無害化といった既存対策を補完する「多層防御」の一部と位置づけている
- 日本語環境: 日本語のメールや日本のテナントで動作に差があるかは、発表では触れられていない
日本でMicrosoft 365 Copilotを導入している企業にとっては、社外メールを要約させる使い方が一般的なだけに、Outlook側の送信者設定とMicrosoftが公開しているCVE-2026-55145の構成ガイダンスを確認することが当面の実務的な対応になります。
「検出」から「流れの制御」へ移る対策の考え方
編集部注: 今回の発表で注目されるのは、悪意ある指示を見つけ出す確率的な「検出」ではなく、出所に基づいて情報の流れそのものを制限する「決定論的な制御」を前面に出した点です。ブログは、既存の緩和策が攻撃パターンの変種で後退しやすいと認めたうえで、出所に応じて事前に定めた制約をかける研究上のアプローチを製品に取り込んだと説明しています。この方向性が根拠となり、今後は「どのコンテンツを未信頼とみなすか」というポリシー設計が、AIの安全性を左右する運用上の論点になるとみられます。同社が企業向けの信号やポリシーシステムとの統合を進めるとしている点も、管理者がより細かい信頼モデルを設定する方向を示唆しています。
ただし、未信頼コンテンツを変換する過程でどこまで有用な情報が保たれるかは、要約の精度との兼ね合いになります。効果の定量的な評価が示されていない現時点では、既存の対策と組み合わせて使う前提で評価するのが妥当とみられます。
