Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月10日(土)のニュース一覧へ引用元:Hugging Face 引用元:Hugging Face
Ai2、数千基GPU向け新スケジューラ導入を報告
NVIDIA
インフラ
研究
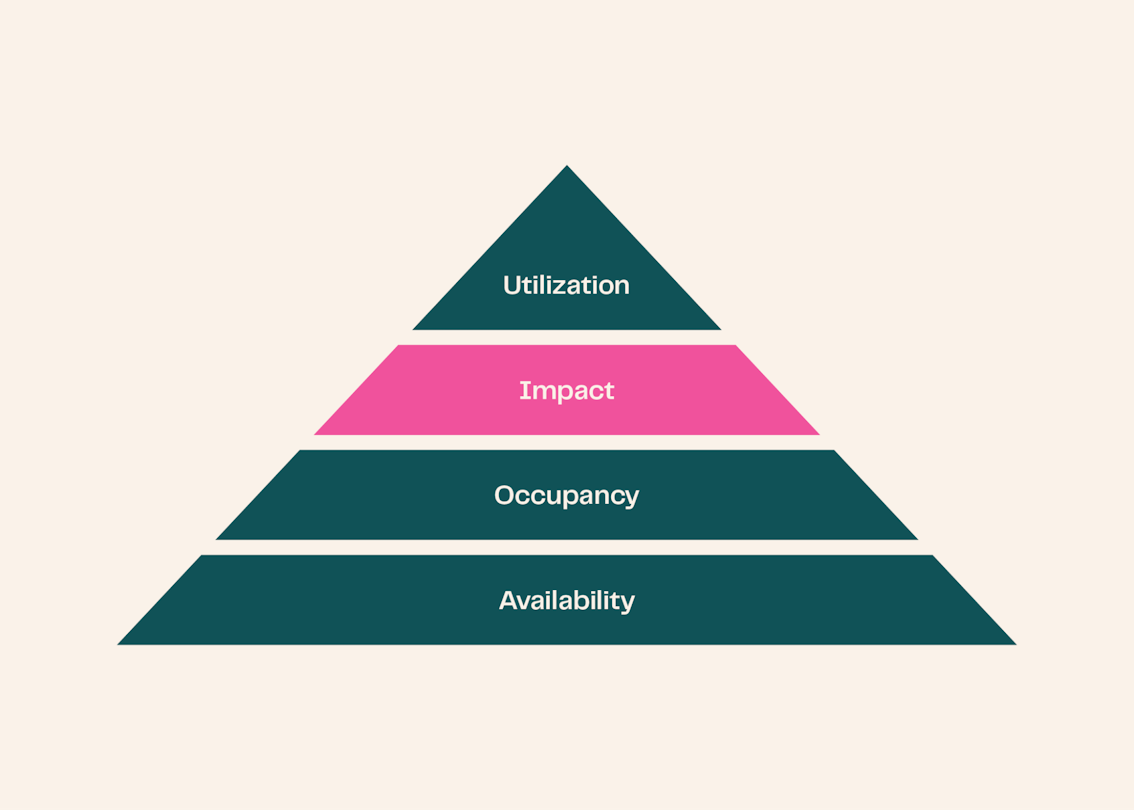
米非営利AI研究機関のAi2(Allen Institute for AI、AI技術のオープンな発展を目指す研究所)は、自組織で運用する数千基規模のGPUクラスタに向け、研究価値の高いジョブを優先しながら高稼働率を維持する新たなスケジューリングシステムを導入し、その実践成果を技術ブログで報告しました。従来の優先度方式で発生していたリソースの奪い合いを解決するため、組織の階層に応じたGPU時間の予算管理とタイムスライシング契約を導入した結果、クラスタ占有率98%を維持したまま、デバッグ用ジョブの待ち時間を大幅に短縮することに成功しました。
共有地の悲劇を解消する「バジェット制」と「契約」の導入
Ai2のAIインフラチームは、88基から1024基規模で構成されるNVIDIAの「H100」「B200」「B300」GPUクラスタを運用し、約150人の内部研究者による大規模分散学習を支えています。GPU需要は供給の2倍から3倍に達しており、常に激しい計算資源の競合が発生していました。
旧来の優先度ベースのスケジューラでは、以下の課題が生じていました。
- GPUの不法占拠(スワッティング): デバッグジョブを即座に開始できない不安から、空ジョブを常駐させてGPUを確保し続ける行為が常態化
- 優先度インフレ: すべてのジョブが最高優先度(HIGH)で投入されるようになり、優先順位による制御が形骸化
- 保守対応の負担: ジョブのプリエンプション(実行中のジョブを一時中断して他ジョブに資源を譲る仕組み)を免除する設定が悪用され、障害ホストの復旧時に手動での調整交渉が頻発
この「共有地の悲劇」を解消するため、Ai2は静的な優先順位付けを撤廃し、経済的なアプローチを取り入れました。
階層型フェアシェアとタイムスライシング契約の設計
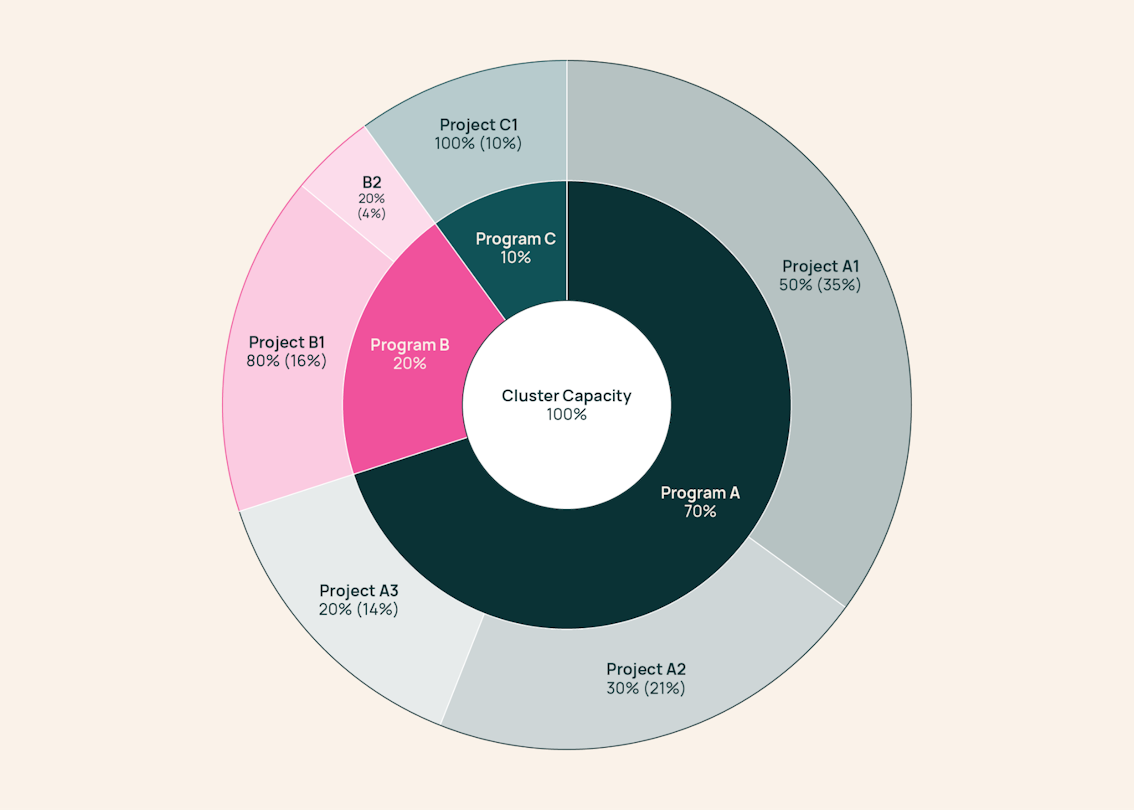
新システムの中核は、研究マネジメントの戦略をそのまま計算資源配分に反映する階層構造です。
- GPUタイムバジェット: プロジェクトや研究プログラムごとに利用可能なGPU時間の比率を予算として割り当て。スワッティングなどの抜け道を使っても自己の予算が消費される仕組みにして不正利用を抑止
- フェアシェア(過去の利用実績に基づき公平な資源配分を行うスケジューリングアルゴリズム)スケジューラ: 7日間のスライディングウィンドウで稼働実績を追跡し、目標配分を下回っているチームのジョブを優先実行
- スケジューリング契約: ジョブ投入時に最低実行時間(最長8時間)を申告。最低実行時間中はプリエンプションから保護され、満了後は必要に応じて自動退避・再キューイングを実施
実運用データと旧方式との比較
30日間の本番運用検証において、クラスタの占有率は改修前後で98%の高水準を維持しました。全提供GPU時間の18%は予算外の空き枠(Unallocated)として割り当てられ、急なバースト需要や未計画枠の回収に役立てられています。
| 評価項目 | 従来の優先度方式 | 新スケジューリング方式 | 改善効果 |
|---|---|---|---|
| デバッグジョブp90待機時間 | 約2時間 | 30秒 | 大幅な短縮 |
| 最大H100クラスタ中央値待機時間 | 5分 | 24秒 | 約12倍の高速化 |
| 最大H100クラスタp90待機時間 | 2.8時間 | 1.8時間 | 約35%削減 |
| 割り当て目標の履行率 | 不均等・形骸化 | **98%**(15チーム中13チームが95%以上) | 配分の公平性を担保 |
| 人手介入を要したホスト障害修復 | 頻繁な手動調整 | 74%削減 | 運用保守の負担を大幅軽減 |
短時間のデバッグジョブが1分未満で起動できるようになったことで、GPUスワッティングを行う動機が根本から解消されました。また、障害が発生したノードでもジョブの最低実行時間満了に伴って自動的にワークロードが退避されるため、保守運用の自動化が進展しました。
課題と未確認事項の整理
新システムの導入によって多くの指標が改善した一方、以下のような新たな運用課題も明らかになっています。
- 対話型セッションの制限: データ分析やコード検証のための対話型セッションに対しても8時間の保護上限が適用されるため、状態を保持したまま長期作業を行う研究者の利便性が低下。Ai2は対策としてデータ準備用のCPU専用クラスタ構築やセッション復元機能を計画中
- 大規摸ジョブの断片化リスク: 最小実行時間の保護が導入されたことで、多数のノードを同時に確保する必要がある超大規模ジョブにおいて、空きノードが揃うまでの待ち時間が増加する可能性があり、シミュレータでの検証を継続中
分析と展望
大規模言語モデル(LLM)やマルチモーダルモデル(VLM)の事前学習・事後学習において、数千基規模のGPUクラスタをいかに無駄なく、かつ研究優先度に沿って稼働させるかは、先端AI開発組織における最重要課題の一つです。
Ai2の取り組みは、単なるキューイング技術の改善にとどまらず、計算資源の配分権限を現場の運用折衝から組織経営的な予算配分へと昇華させた点に大きな意義があります。HadoopやSLURMで培われた古典的なフェアシェア技術を現代のGPU需要に適合させ、タイムスライシング契約によって運用の自動化率を高めた実践知見は、独自の計算基盤を抱えるAI研究開発機関や企業インフラチームにとって極めて実践的なモデルケースとなります。
引用元:Hugging Face

