Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年10月10日(土)のニュース一覧へ引用元:SGLang & Miles Team
LMSYS、NVIDIA Rubin向けの高速化成果を発表
NVIDIA
ハードウェア
半導体
オープンソース
開発者ツール
AI研究組織LMSYSおよびRadixArkの開発チームは2026年10月9日、米NVIDIAの次世代GPUプラットフォーム「NVIDIA Vera Rubin」の初期ハードウェア(2ノード・計8GPU)における、オープンソース推論エンジン「SGLang」と強化学習基盤「Miles」の最適化成果を発表した。共有メモリ容量の拡張やNVLink 6の採用といったハードウェアの進化を活かし、超大規模モデルの推論高速化とエージェント向け強化学習の実効性を実証した。
次世代アーキテクチャを活かした推論カーネルの高速化
NVIDIA Vera Rubinは、Blackwell Ultra世代に続く次世代アーキテクチャである。CTA(スレッドブロック)あたりの共有メモリがHopperやBlackwellの227 KiBから327 KiBへと約44%増加し、ノードあたりのSM(ストリーミングマルチプロセッサ)数も212基に拡大した。
チームは2.8兆パラメータのハイブリッドモデル「Kimi K3 NVFP4」を対象に、SGLangの各種カーネルを最適化した。
MLAアテンションのパイプライン深化
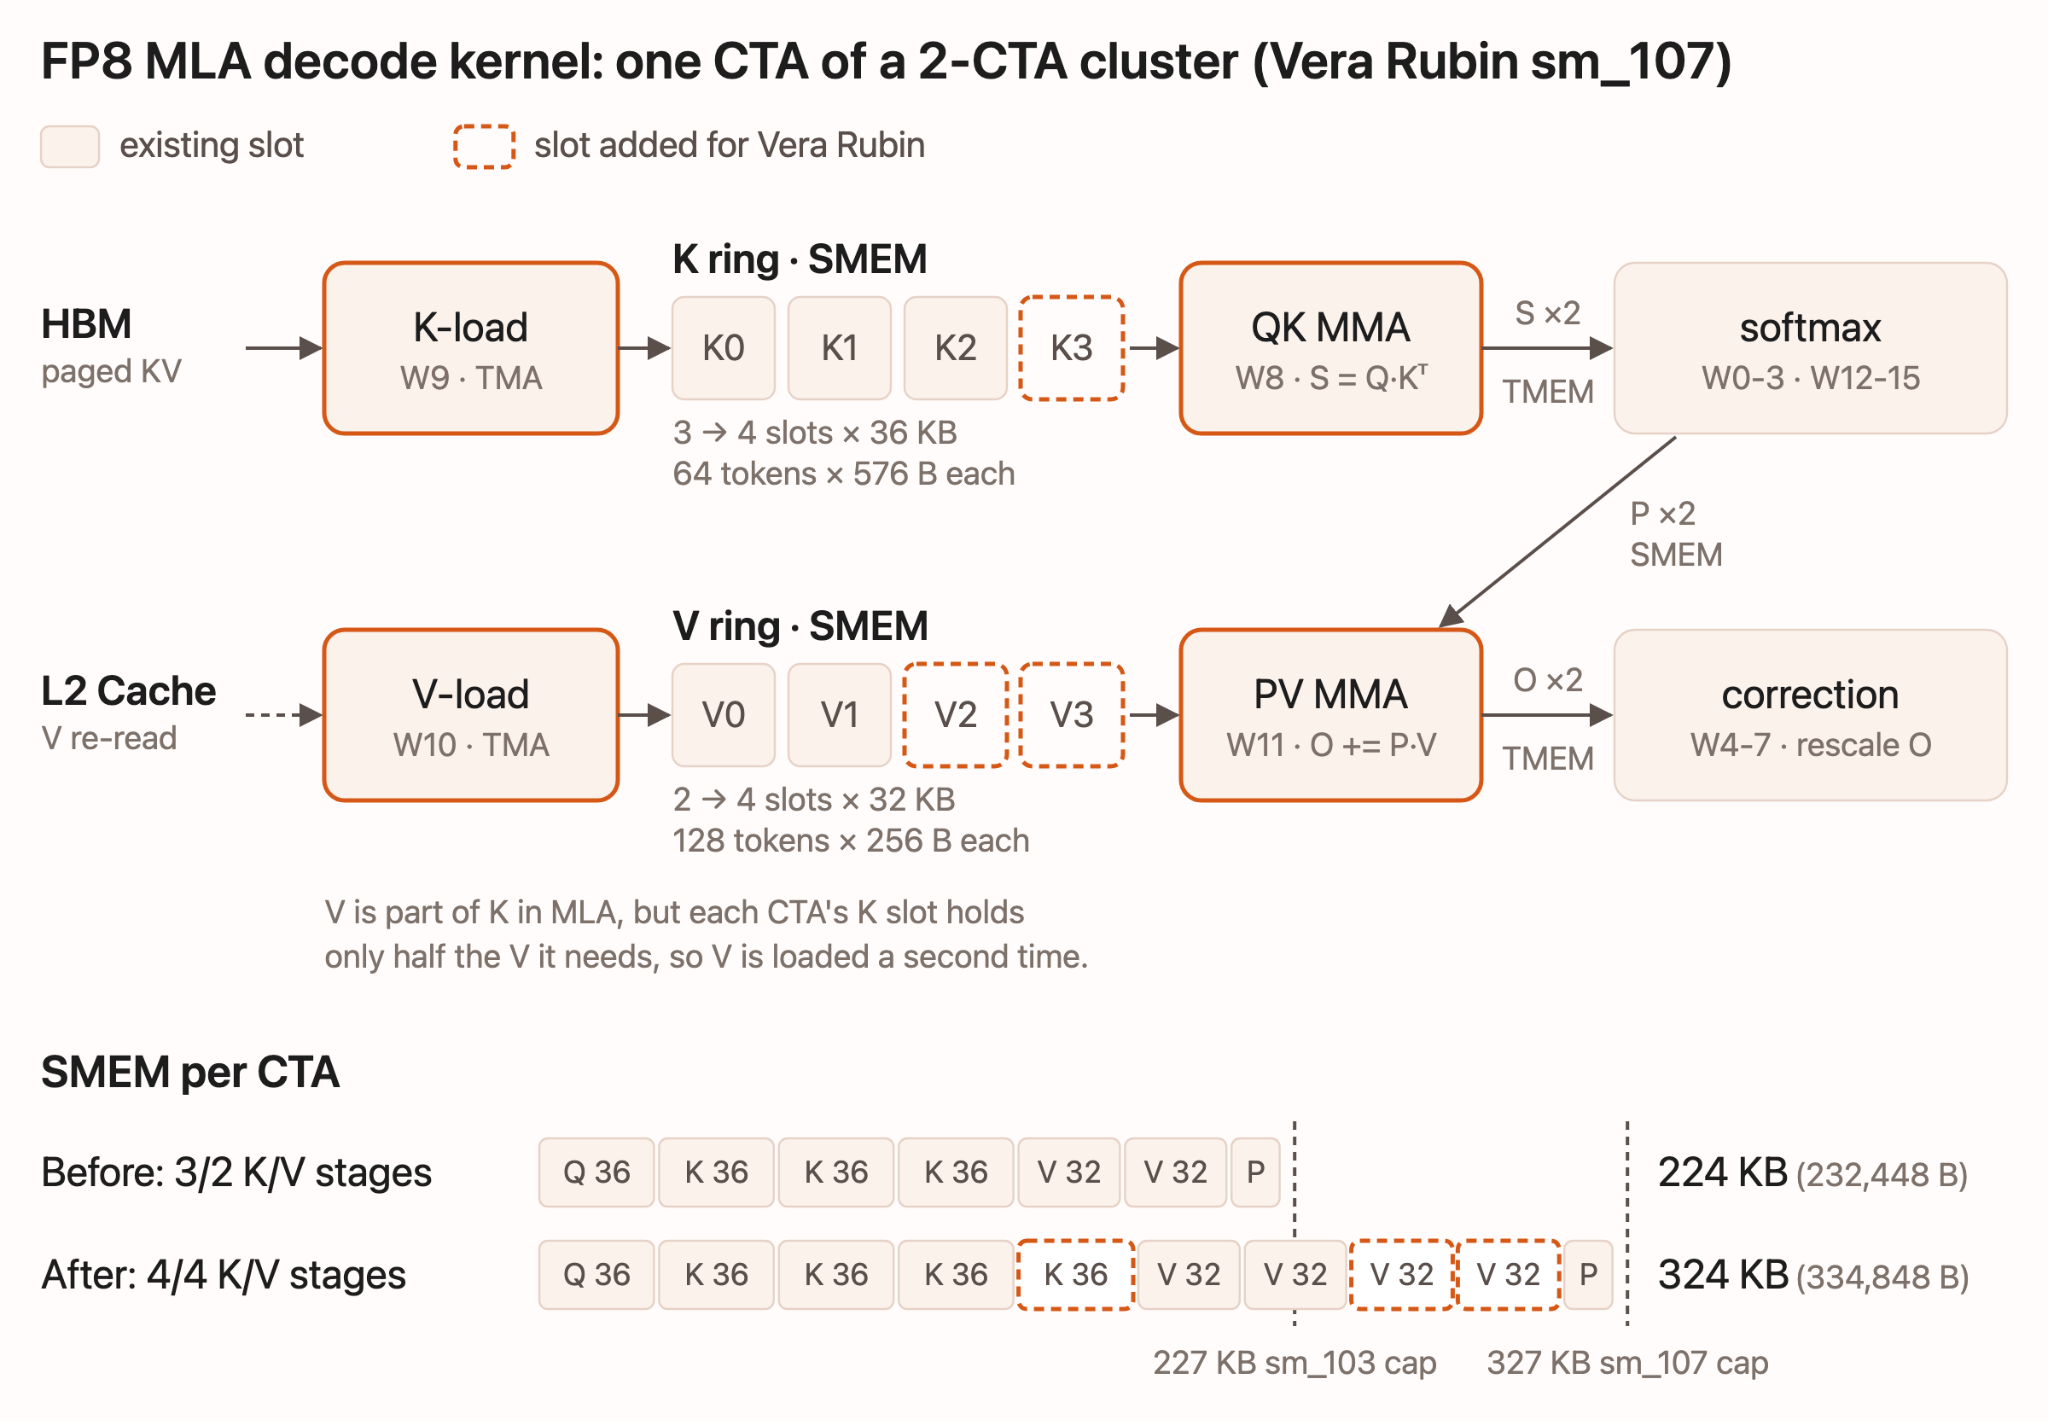
長文コンテキスト処理において、MLA(Multi-Head Latent Attention。メモリ帯域消費を抑えて高速化するアテンション機構)のデコード処理はHBM(高帯域メモリ)からのKV読み込み待ちがボトルネックとなる。Vera Rubinで共有メモリ上限が327 KiBに引き上げられたことで、メモリパイプラインの段数を拡張することが可能になった。
これにより、バッチサイズ16・128kトークンコンテキスト時のMLAデコード速度が16%向上した。さらに、分割されたKVキャッシュの集約処理をレジスタアキュムレート方式へ改善したことで、低並行時のFP8 MLA処理が20%高速化している。
MoE処理の融合とカーネル起動オーバーヘッドの排除
MoE(混合エキスパート)層の末尾で行われるエキスパート出力確定、共有エキスパート加算、8GPU間のAll-Reduce通信、RMSNormの4工程を1つの集合カーネルに統合(Fused MoE tail)した。これにより、1デコードステップあたり276回のカーネル起動オーバーヘッドを削減し、エンドツーエンドで5.9%の高速化を達成した。
世代間スペック比較と最適化による効果
前世代Blackwellと比較したVera Rubinの主要な仕様差分と、今回のチューニングによる具体的な性能向上幅は以下の通りである。
| 項目 | Hopper / Blackwell世代 | Vera Rubin世代 | 最適化による効果・性能向上 |
|---|---|---|---|
| CTAあたり共有メモリ | 227 KiB | 327 KiB(約44%増) | MLAパイプライン段数増加によりデコード速度16%向上 |
| SM(マルチプロセッサ)数 | 各種 | 212基(検証ノード) | 64分割Split-KVの導入でエンドツーエンド1.9%向上 |
| 相互接続規格 | NVLink 5 | NVLink 6 | Push型All-Reduceの適用範囲拡大でデコードスループット3.6%向上 |
| MoE結合処理 | 個別カーネル起動 | Fused MoE tail | 276回の起動オーバーヘッド削減でエンドツーエンド5.9%向上 |
なお、先行してVera Rubin NVL72を本番導入したAIスタートアップのCognitionは、GB200 NVL72と比較して総トークンスループットが最大4.8倍に達したと報告している(注: Cognition独自のSGLangフォークおよびベンチマーク環境での測定値)。
Vera CPUを活用したエージェント強化学習の実証
強化学習フレームワーク「Miles」を用いた検証では、SGLangを推論ロールアウトに、Megatronを学習に用いるエンドツーエンドの強化学習パイプラインがVera Rubin上で追加設定なしに稼働した。Qwen3-30B-A3Bを用いたGSM8Kタスクにおいて、GB300と同等のリワード上昇曲線(約45%から95%への収束)が確認された。
さらに、ArmベースのVera CPU上でNeMo Gymのmini-SWE-agentサンドボックスを64環境並列で実行し、GPUと密連携させたエージェント強化学習(Agentic RL)の動作を実証した。エピソードあたりのトークン長が約30%短縮され、ロールアウトと学習が安定して同期することが確認された。
ハードウェア統合が拓く次世代AI基盤
今回の成果は、GPUの生演算性能の向上にとどまらず、共有メモリの大容量化や同一トレイ内のArm CPUとの緊密な統合が、巨大モデルの推論効率や自律エージェントの強化学習に大きな恩恵をもたらすことを示している。次世代ハードウェアへの最適化がオープンソースコミュニティ主導で迅速に進むことで、次世代インフラの実用化が一段と加速すると期待される。