Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月30日(水)のニュース一覧へ引用元:芝浦工業大学
NVIDIA、芝浦工大の尾崎スキームIIをCUDAに採用
NVIDIA
研究
半導体
ハードウェア
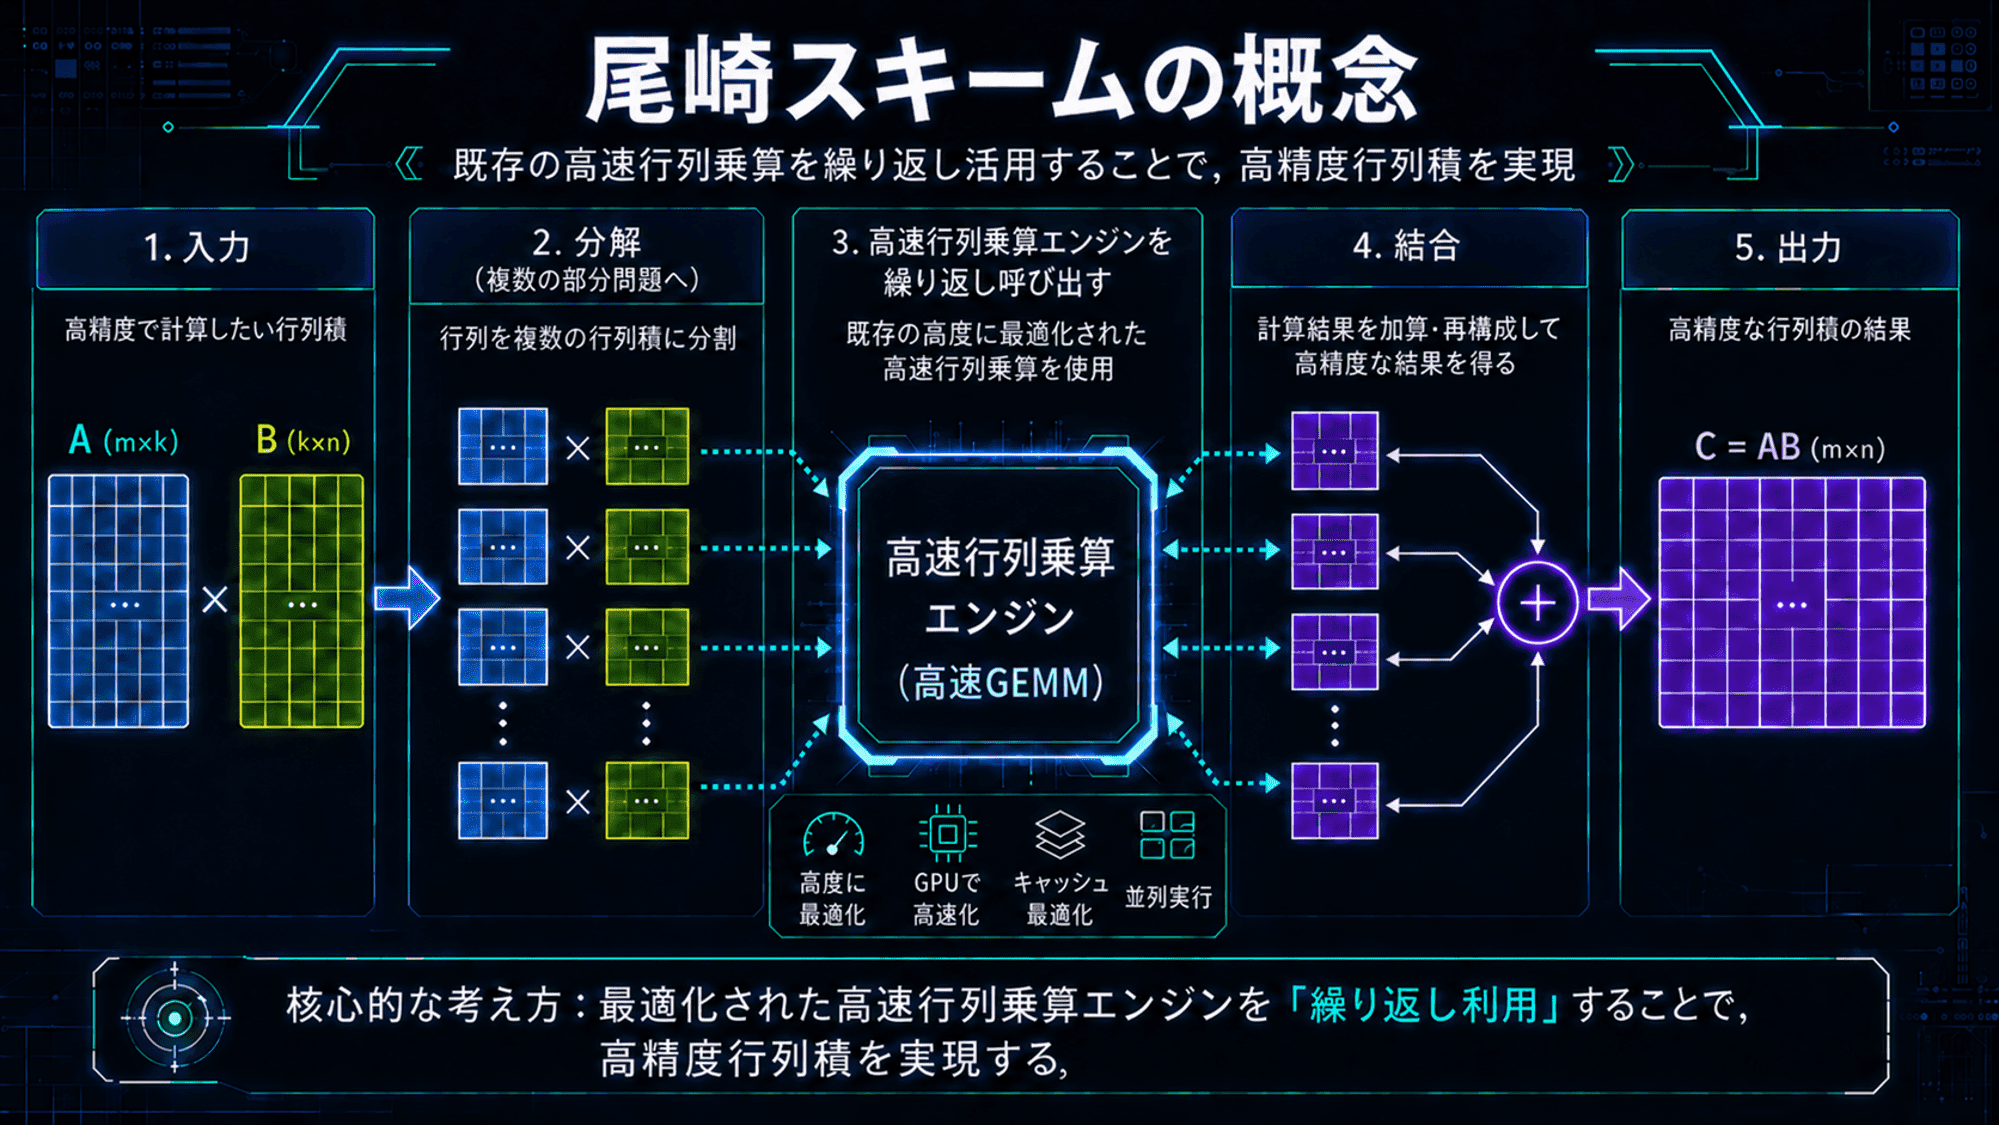
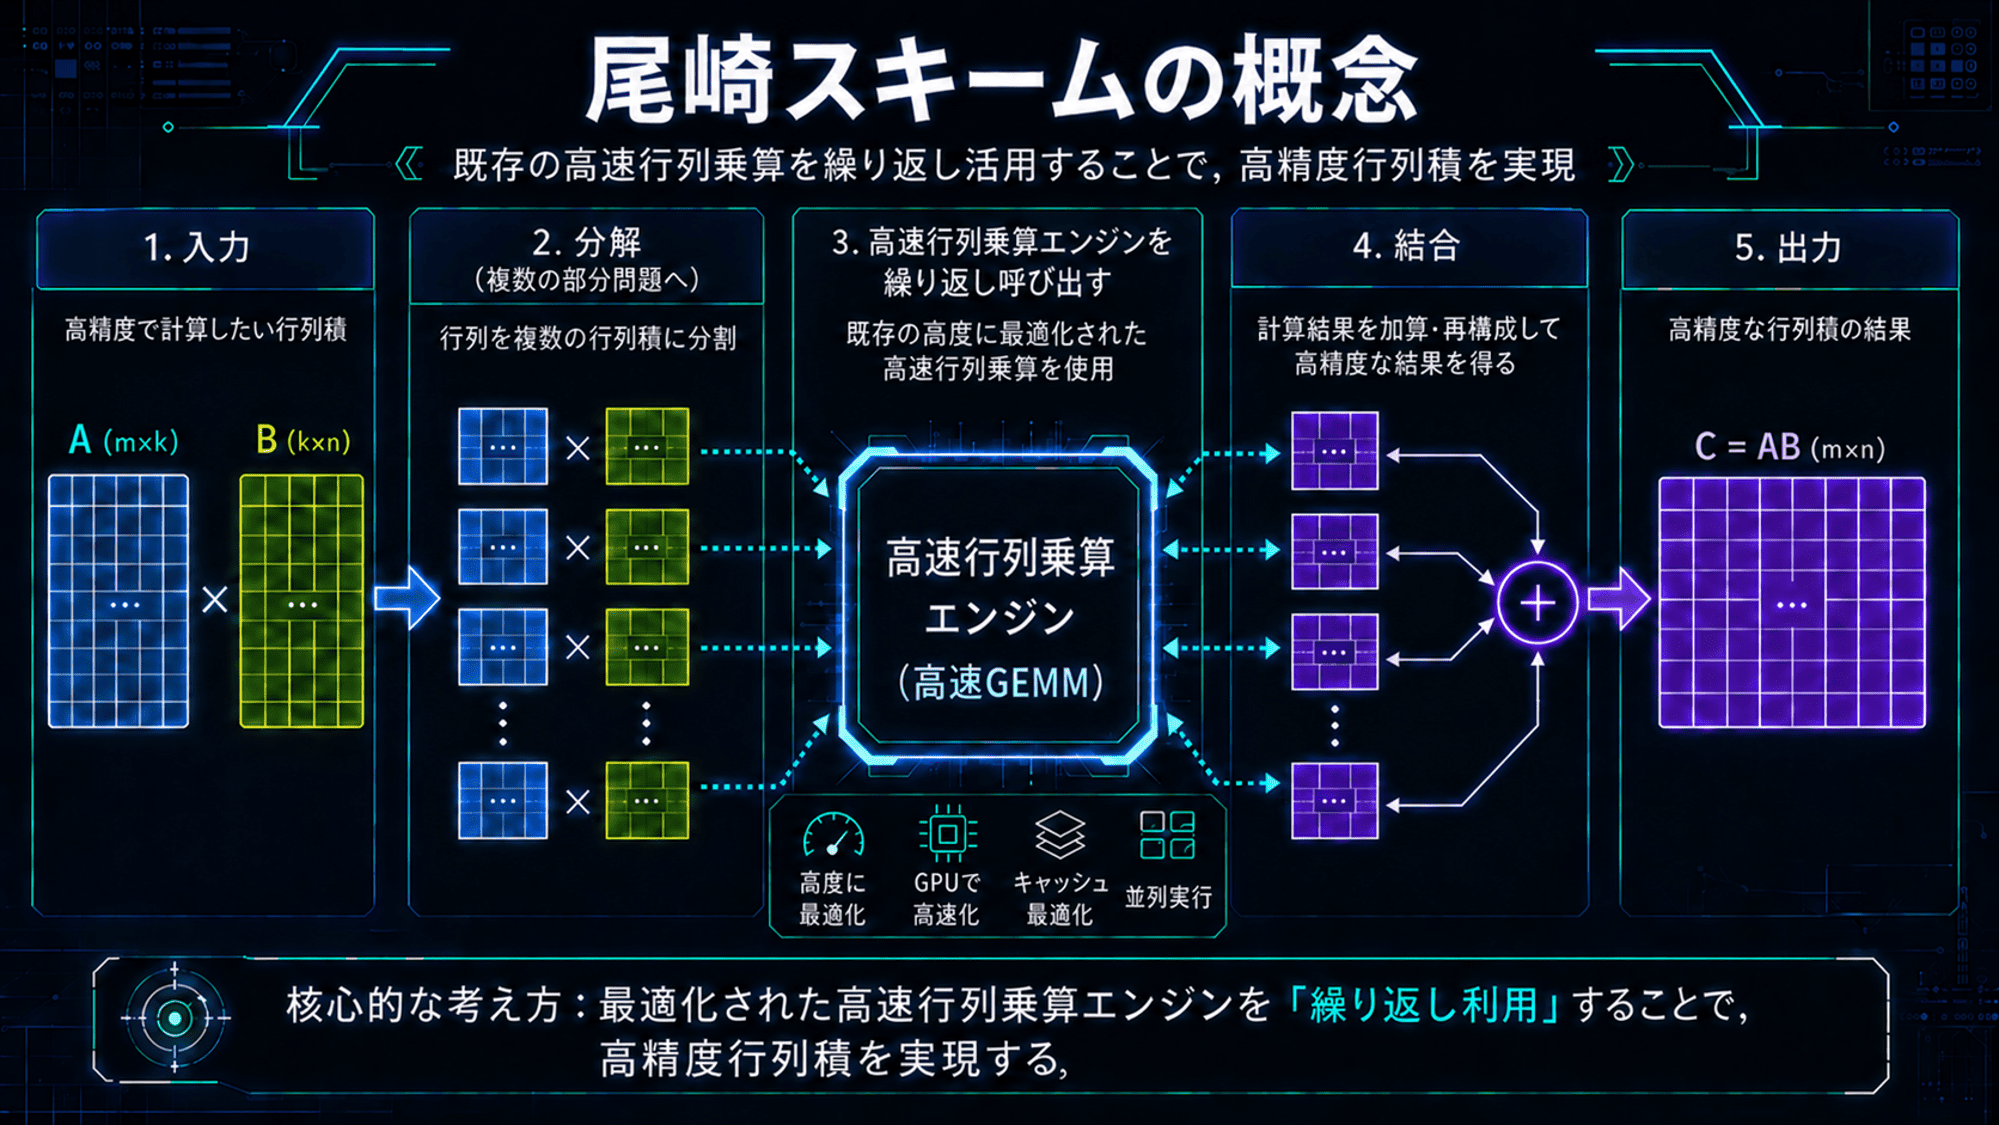
芝浦工業大学システム理工学部の尾崎克久教授らの研究グループが考案した高精度計算手法「Ozaki Scheme II(尾崎スキームII)」が、米NVIDIAのGPU開発基盤「CUDA(NVIDIAのGPU向け統合開発環境・並列計算基盤)」の最新版「CUDA Toolkit 13.4」に正式採用されました。気象予測や耐震設計などの科学シミュレーションに必要な倍精度(FP64(64ビット浮動小数点数による高精度演算))計算を、AI向けに強化された低精度演算器を活用して大幅に高速化します。
AI特化で縮小する倍精度性能を数学的手法で補完
近年のGPUはAIの学習や推論需要に応えるため、FP8やFP4といった低精度演算器の拡充に注力しています。一方で科学技術シミュレーションに欠かせないFP64専用ハードウェア演算性能は後退傾向にあり、Blackwell世代のB200が約40 TFLOPSを備えるのに対し、後継のBlackwell Ultra(B300)では1.2〜1.3 TFLOPSへと30分の1以下に削減されています。
Ozaki Scheme IIは、この課題をソフトウェアと数学的アプローチで解決します。中国剰余定理(整数の剰余を用いたモジュラー計算)により、AI向けの低精度演算器を複数回組み合わせてFP64と同等の精度結果を導き出す仕組みです。追加のハードウェア回路を必要とせず、NVIDIA Ampere世代以降の既存GPU上でそのまま動作します。
B200で最大175 TFLOPS、次世代Rubinにも対応
NVIDIAのcuBLASリリースノートによると、CUDA 13.4ではワークロードに応じてOzaki Scheme IとIIが自動的に最適選択されます。B200 GPUにおける実数倍精度行列積(DGEMM)では最大175 TFLOPS、複素数行列積(ZGEMM)では最大295 TFLOPSを記録しました。さらに次世代アーキテクチャ「Rubin」の開発者向けプレビュー環境では、DGEMMで最大212 TFLOPS、ZGEMMで最大301 TFLOPSを達成しています。
手法比較と次世代スパコンへの波及効果
Ozaki Schemeは2025年に採用された初代「Ozaki Scheme I」から進化を続けています。
| 項目 | Ozaki Scheme I(2025年CUDA採用) | Ozaki Scheme II(2026年CUDA採用) |
|---|---|---|
| 基本原理 | 誤差なし変換に基づくアルゴリズム | 整数の剰余(中国剰余定理)によるモジュラー計算 |
| 対応ハードウェア | NVIDIA Ampere世代以降 | NVIDIA Ampere世代以降(最適時に自動選択) |
| B200倍精度性能 | 従来エミュレーション速度 | DGEMM最大175 TFLOPS / ZGEMM最大295 TFLOPS |
| 電力効率 | 専用回路比で消費電力を抑制 | 性能向上とともに電力効率をさらに改善 |
本技術は日本の計算科学インフラにも直結しています。理化学研究所が富士通・NVIDIAと連携して2030年ごろの稼働を目指す次世代スーパーコンピュータ「富岳NEXT」の開発方針において、低精度演算器を活用したFP64エミュレーション技術の中核として位置づけられています。また米エネルギー省(DOE)の科学研究プログラム「Genesis Mission」でも活用が報じられています。
分析・展望:HPC分野における演算パラダイムの転換
ハードウェアの倍精度専用回路に頼る従来の科学技術計算アプローチから、AI向け低精度ハードウェア+数学的エミュレーションへの構造的転換を決定づけるマイルストーンです。
理化学研究所の松岡聡計算科学研究センター長が論文で論じているように、AIアクセラレータが計算資源の主流となった現代において、本手法は科学技術計算の持続可能性を保つ決定打となりつつあります。大学の研究室や企業が保有する汎用GPU環境でも高精度シミュレーションが可能となるため、計算科学の民主化が進むとみられます。