Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月24日(木)のニュース一覧へ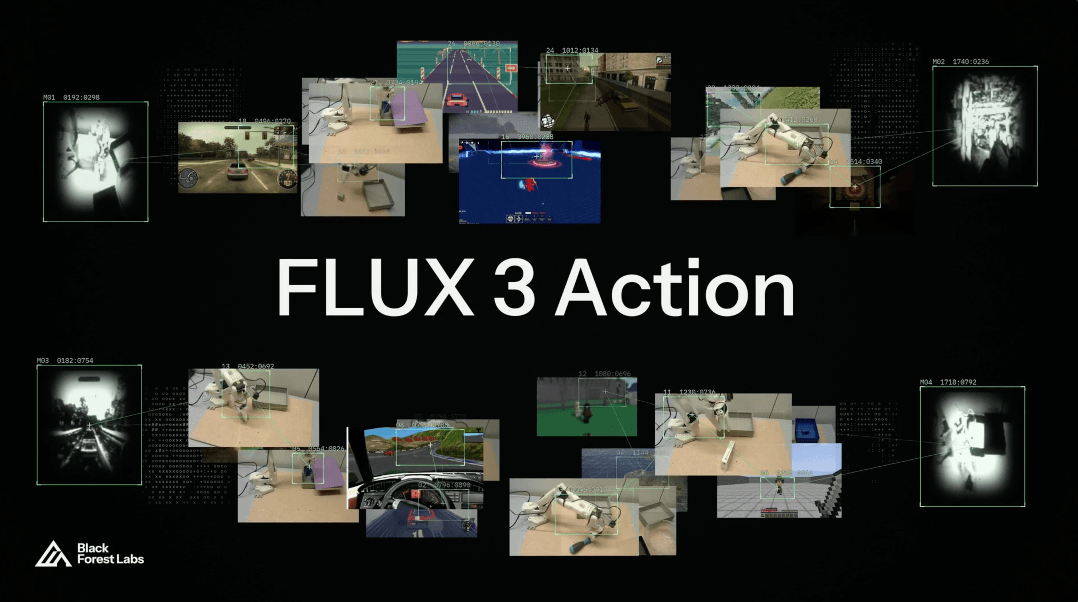
BFL、行動予測モデルFLUX 3 Action公開
オープンソース
ロボティクス
AIエージェント
Black Forest Labsは、カメラ画像とテキストの指示から次の2秒間の「行動(アクション)」を予測する7B(70億)パラメータのオープンウェイト・ワールドアクションモデル「FLUX 3 Action」を発表しました。このモデルは、画像や動画を生成するだけでなく、ロボットアームやドローン、ゲームのキャラクターなどを実際に操作するための基盤モデルとして機能します。 FLUX 3 Actionは、拡散トランスフォーマー(Diffusion Transformer)アーキテクチャを採用しており、凍結された動画VAEでフレームをエンコードし、Qwen3-VL-4Bを用いてテキスト指示を処理します。ロボット制御データセット「DROID」によるファインチューニングの結果、RoboLabベンチマークにおいて42.92%の成功率を記録し、従来モデル(Cosmos 3 Nanoなど)を上回る成績を収めました。モデルの重みはHugging Face上で公開されており、オープンソースのロボティクスライブラリ「LeRobot」にも統合されています。 独自価値の整理(比較と影響) 既存の視覚言語行動モデル(VLA)の多くがクローズドな開発環境にとどまる中、FLUX 3 Actionは開発者が独自のタスクに合わせて簡単にファインチューニングできるオープンな基盤を提供した点で画期的です。例えば、わずか数百回のデモンストレーションデータを学習させるだけで、ロボットアームだけでなく、レーシングゲームの運転やドローンの自律飛行など、全く異なる「行動タスク」に適応できることが実証されています。 分析・展望 生成AIのフロンティアは、テキストやピクセルの出力から、物理世界や仮想空間における「行動(Physical AI / Agentic AI)」の出力へと明確にシフトしています。FLUX 3 Actionのような高性能なオープンウェイトモデルがコミュニティに提供されたことで、企業や研究者は高価な独自開発を行わずに、自律型ロボットや高度なゲームAIのプロトタイピングを加速できるようになります。デジタル空間と物理空間の境界を曖昧にするこの技術は、今後の自動化産業の中核となるでしょう。
引用元:Source
引用元:Hugging Face | GIGAZINE
参考ソース
FLUX 3 Action: a world action model you can fine-tune
A Blog post by Black Forest Labs on Hugging Face
https://huggingface.co/blog/black-forest-labs/flux-3-action
GIGAZINE
ロボットやゲーム向けの世界行動モデル「FLUX 3 Action」をBlack Forest Labsが公開
Black Forest LabsのマルチモーダルAIモデル「FLUX 3」から派生した、ロボット制御向けの世界行動モデル「FLUX 3 Action」が公開されました。
https://gigazine.net/news/20260925-flux-3-action