Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月15日(火)のニュース一覧へ引用元:Google Cloud
Google Cloud、Dataflow一時停止と最新GPUを提供
Google
NVIDIA
クラウドコンピューティング
インフラ
半導体
バッチジョブの中断再開とBlackwell世代GPUによる推論強化
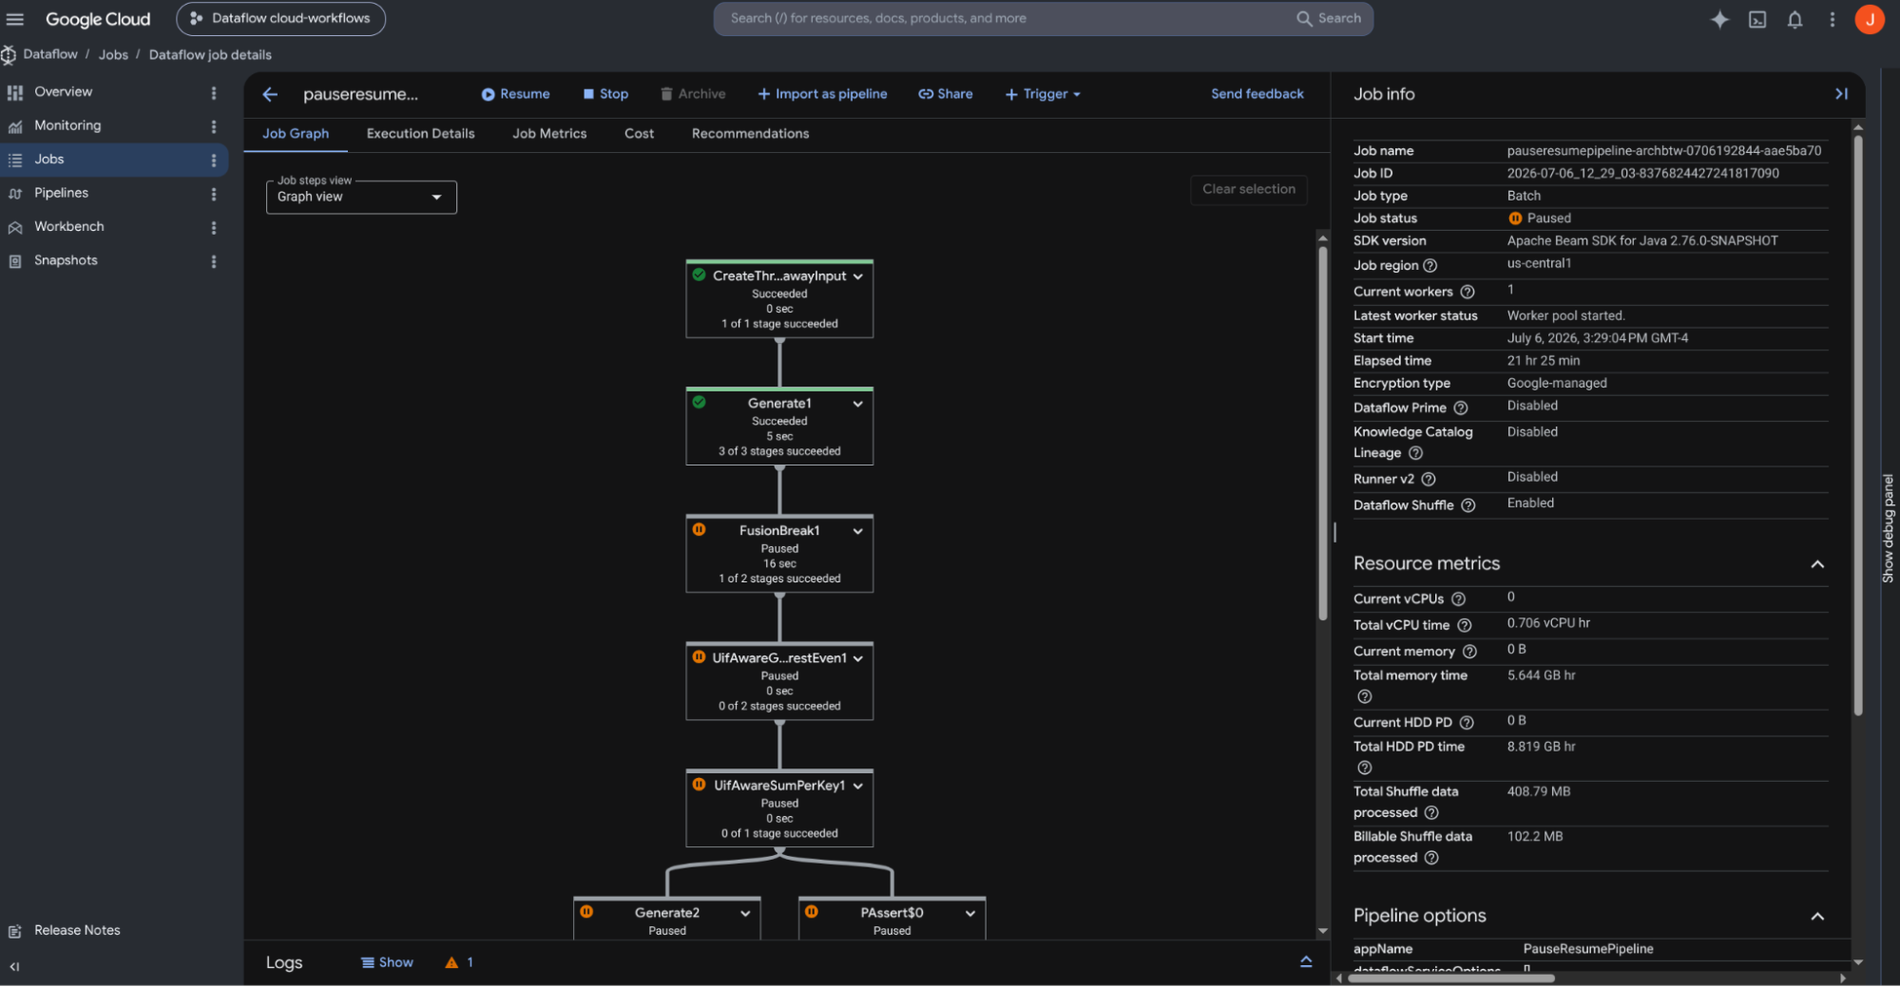
米Google Cloudは2026年9月14日、同社のフルマネージド並列データ処理サービス Dataflow(Google Cloudが提供するサーバーレス分散データ処理基盤) において、バッチジョブ向け「一時停止・再開(Pause/Resume)」機能の一般提供(GA)を開始したと発表しました。
あわせて、最新のBlackwellアーキテクチャを採用したワークステーション・サーバー向けGPU「 NVIDIA RTX PRO 6000(NVIDIAの最新Blackwellアーキテクチャを搭載した超高性能GPU) Blackwell Server Edition」を搭載する「G4 VM」のサポートも発表しました。これにより、数日間に及ぶ長大なバッチ処理での障害耐性が飛躍的に向上するほか、データパイプライン上で最大70B(700億)超のパラメータを持つ大規模言語モデルのAI推論を直接スケール実行できるようになります。
確認済みの事実:失敗ジョブの途中復旧と96GB大容量GPUの直接活用
Google Cloud公式ブログによると、今回提供された2つの新機能の詳細は以下の通りです。
1. バッチジョブのPause/Resume機能(GA)
Dataflowの利用者はこれまで、数日かかるような大規模バッチ処理が途中で失敗した場合、処理済みデータを利用できず、ジョブ全体を最初から再実行せざるを得ませんでした。これにより莫大な計算リソースの浪費と開発生産性の低下が生じていました。
今回GAとなったPause/Resume機能により、失敗した長時間ジョブをゼロからやり直すことなく、中断地点から再開(Resume)できるようになりました。さらに、ユーザーは運用都合に合わせて手動でジョブを一時停止・再開することも可能です。これにより、優先度の低いバッチ処理からGPUやTPUなどの高価なアクセラレータを一時的に解放し、特徴量エンジニアリングや即時性が求められるAI推論などの高優先度ワークロードへ動的に再割り当てすることが可能になりました。
2. NVIDIA RTX PRO 6000 Blackwell GPUのサポート
従来のNVIDIA L4 GPUと比較して大幅な性能向上を達成したRTX PRO 6000 Blackwell GPUが、DataflowのG4 VMで利用可能になりました。本GPUは96GBのvGPUメモリと毎秒1.6TBの広帯域幅を備えており、70Bクラス以上のフロンティア級AIモデルの推論をDataflowパイプライン内で直接実行できます。
また、インフラ管理を意識することなく推論を最適化・スケールできるDataflow固有のML機能(RunInference、right fitting、GPU対応オートスケーリング)とも完全に連携します。
独自価値要素:アクセラレータ仕様比較とリソース運用の柔軟性
Dataflowで新たに利用可能となったNVIDIA RTX PRO 6000 Blackwell GPUと、従来の主流であったNVIDIA L4 GPUの主な違いおよび運用上のメリットを以下のように整理できます。
| 項目 | NVIDIA L4 GPU(従来主流) | NVIDIA RTX PRO 6000 Blackwell(新対応) | 導入による実務的変化 |
|---|---|---|---|
| GPUメモリ容量 | 24GB | 96GB(vGPU) | 70B+の大規模モデルを単一ノードでそのまま推論可能に |
| メモリ帯域幅 | 約300GB/s | 1.6TB/s | メモリ帯域がボトルネックとなるLLMのデコード速度を高速化 |
| 想定モデル規模 | 小型〜中型(7B〜13Bクラス) | 超大型(70B+クラス) | データ前処理・抽出パイプライン内での高精度モデル直接呼び出し |
| リソース再配分 | 静的な割り当てが中心 | Pause/Resumeと連携した動的転用 | 夜間バッチを一時停止し、日中ピーク時の推論クラスタへGPUを即座に供出 |
分析・展望:データパイプラインとAI推論の境界の消失
従来のAIシステム設計では、「ETL・データ前処理パイプライン」と「AIモデルの推論サービングクラスタ」は物理的・論理的に分離され、中間にストレージやメッセージキューを挟むのが通例でした。
しかし、Dataflowが96GBメモリを備えるBlackwell GPUを抱え込み、さらに長時間ジョブの一時停止・再開によるきめ細かなリソース融通を実現したことで、ストリーミングやバッチのパイプラインそのものが「大規模推論エンジン」として機能する環境が整いました。モデルサイズに合わせたインフラの断絶をなくし、データ処理の流れの中で直接巨大モデルを回すアーキテクチャが、今後のエンタープライズAI基盤の標準構成となっていくとみられます。
引用元:Google Cloud
