Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月10日(木)のニュース一覧へ引用元:Databricks
Databricks、適応型検索モデルを発表
AI検索
RAG
エンタープライズ
研究
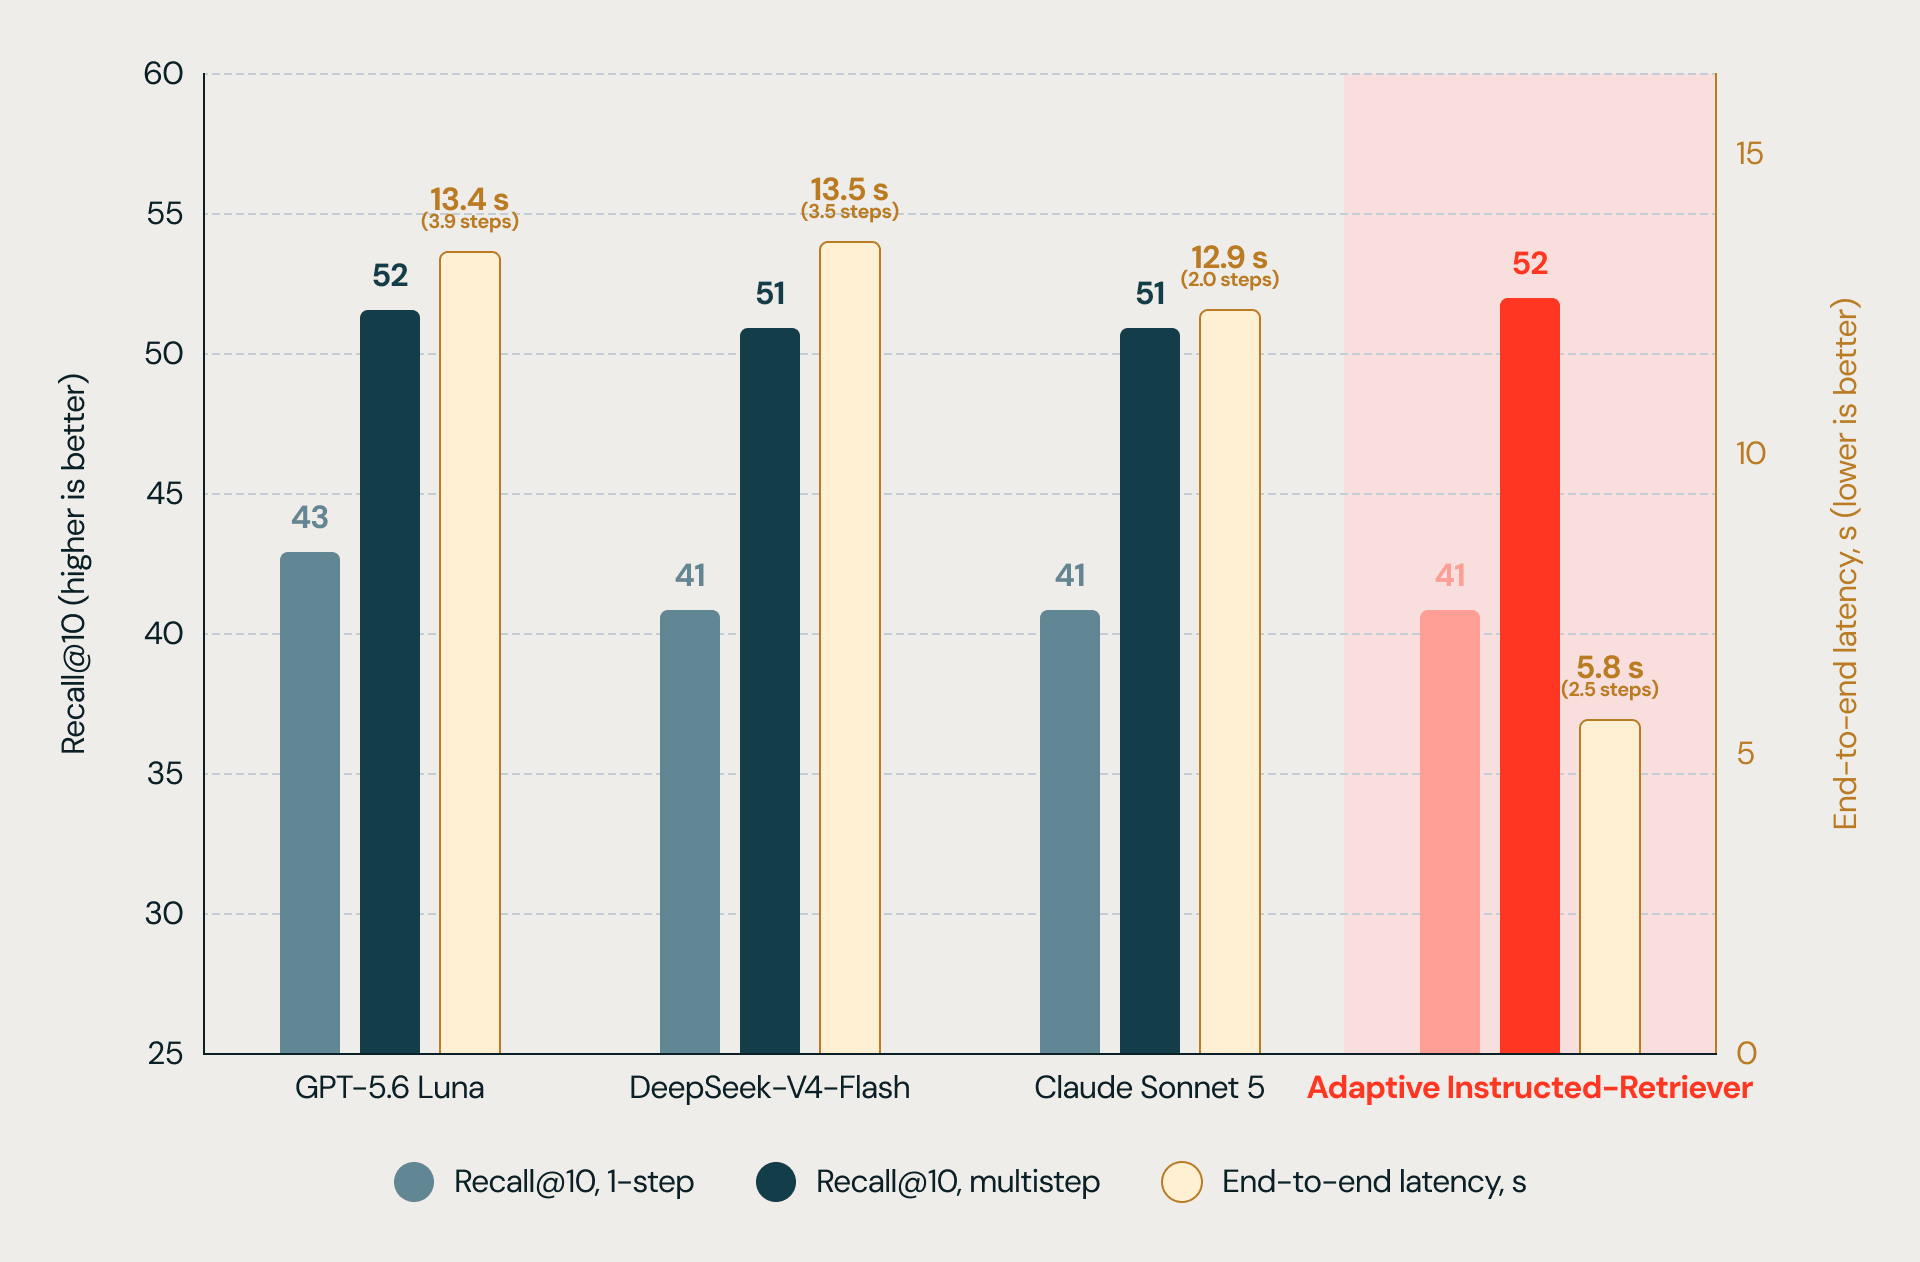
米Databricksは2026年9月9日(現地時間)、エンタープライズ向けデータ検索において高精度と低遅延を両立する新技術「Adaptive Instructed-Retriever(Databricksの適応型多段検索モデル)」を発表した。問い合わせ内容の複雑さに応じて並列1ステップ検索と反復的な順次検索を適応的に使い分け、最先端の商用モデルと同等の検索品質を維持しつつ、応答レイテンシを約半分に削減する。同社のデータ分析エージェント「Genie Code」などの基盤レイヤーとして導入される。
単一ステップの速さと順次検索の深さを適応統合
企業向けのRAG(検索で得た情報を生成に組み込む手法)やデータエージェントでは、膨大なスキーマや非構造化文書から必要な根拠を高速かつ正確に引き出す能力が求められる。従来の並列1ステップ検索は応答が高速な反面、複数の情報源をたどる複雑な問い合わせ(マルチホップ質問)に弱い課題があった。一方、モデルが思考を巡らせながら複数回検索を繰り返す順次検索は精度が高いものの、大幅な遅延増大を招いていた。
Adaptive Instructed-Retrieverは、順次ステップ数に上限を設けたうえで、「十分な証拠が集まった時点で即座に検索を終了し、さらなる探索が必要な難問にのみ追加ステップを消費する」適応型の探索ポリシーを学習させた。社内および公開ベンチマークによる評価では、平均5.8秒で応答を完了し、Claude Sonnet 5、GPT-5.6 Luna、DeepSeek-V4-Flashと比較して2倍以上高速な処理速度を達成した。
オンライン強化学習とステップペナルティによる最適化
本モデルの学習には、オンライン強化学習(ORL)とポリシー最適化手法CISPO(Clipped Importance Sampling Policy Optimization)が用いられている。
- 探索コストの報酬設計: 検索結果の質を高める軌道に報酬を与える一方、成果につながらない無駄な追加検索ステップにはペナルティを課すことで、最小限の手数で正解に達する行動を学習させた。
- パレートフロンティアの調整: ステップペナルティの重みを調整することで、対話型用途向けの「超低遅延型」から非同期分析向けの「超高精度型」まで、運用要件に合わせたチェックポイントを柔軟に選択できる。
- AI Runtime(AIR)の活用: モデルの訓練はDatabricksの分散GPU基盤「AI Runtime」上で実施されており、顧客企業が自社固有のデータドメインに合わせて同様の手法で検索モデルを特化させることも可能である。
主要モデルとの検索効率・行動比較
公式発表で示された具体例において、Adaptive Instructed-Retrieverは汎用フロンティアモデルを上回る効率的な探索行動を示している。
| 質問ケース | モデル | 再現率(Recall@10) | 所要ステップ数 | 検索行動の特性 |
|---|---|---|---|---|
| 否定回答の検証(特定費用の計上有無) | GPT-5.6 LunaClaude Sonnet 5Adaptive IR | 1.001.001.00 | 4ステップ3ステップ2ステップ | 憶測的なキーワードを過剰検索関連注記を順次確認該当科目の不在を確認し即時停止 |
| 戦略転換を伴う調査(製品の利用顧客特定) | GPT-5.6 LunaClaude Sonnet 5Adaptive IR | 0.620.500.75 | 4ステップ2ステップ2ステップ | 同一語句の組み合わせを反復早めに停止するも具体顧客を見落とし2巡目で仮説を切り替え顧客を特定 |
日本のエンタープライズ検索・RAG開発への影響
社内情報検索や業務自動化エージェントを構築する日本の開発者にとって、エージェントが検索ループに陥って回答までに数十秒を要する現象は最大のUX課題であった。適応型リトリーバーのように「引き際を理解している小型特化モデル」を検索レイヤーに配置することで、エンドユーザーの待機時間を数秒台に抑えつつ、LLM呼び出しコストを劇的に削減できる実務的価値は極めて大きい。
分析・展望:巨大モデルの力任せ探索から特化エージェントへ
本発表は、生成AIの性能改善が「基盤モデルのパラメータ巨大化」から「タスク特化型の推論ポリシー最適化」へと移行している潮流を象徴している。検索という特定領域に絞り、強化学習によって無駄な探索を削ぎ落とす手法は、エンタープライズ現場で求められる厳格なレイテンシ・コスト要件を満たす現実解となる。今後、社内DBやAPI連携の現場において、こうした適応型小型モデルの採用が加速するとみられる。
引用元:Databricks
