Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年9月3日(木)のニュース一覧へ引用元:Engineering at Meta
Meta、組織知を蓄積・自己改善するAIエージェントを発表
Meta
AIエージェント
エンタープライズ
研究
Meta(米国のソーシャル・テクノロジー大手企業)のエンジニアリング部門は、社内専門家(SME: Subject Matter Expert)の深い専門知識を体系的に集約し、モデルの再学習を行わずにフィードバックから永続的に自己改善を続けるAIエージェントアーキテクチャ「Organizational Second Brain(組織の第二の脳)」を発表した。単に文書を検索する従来のRAG(検索拡張生成)を超え、組織の「判断基準」そのものを構造化して維持する新たな設計論を提示している。
知識と推論の分離、再学習不要の自己改善ループ
大企業における専門知識の多くは、業務マニュアルではなく専門家の頭の中に「暗黙知」として蓄積されている。Metaのシステムは、コンプライアンス審査などの高リスク領域において、この暗黙知をAIが利用可能な形式へ事前に蒸留する4層構造を採用した。
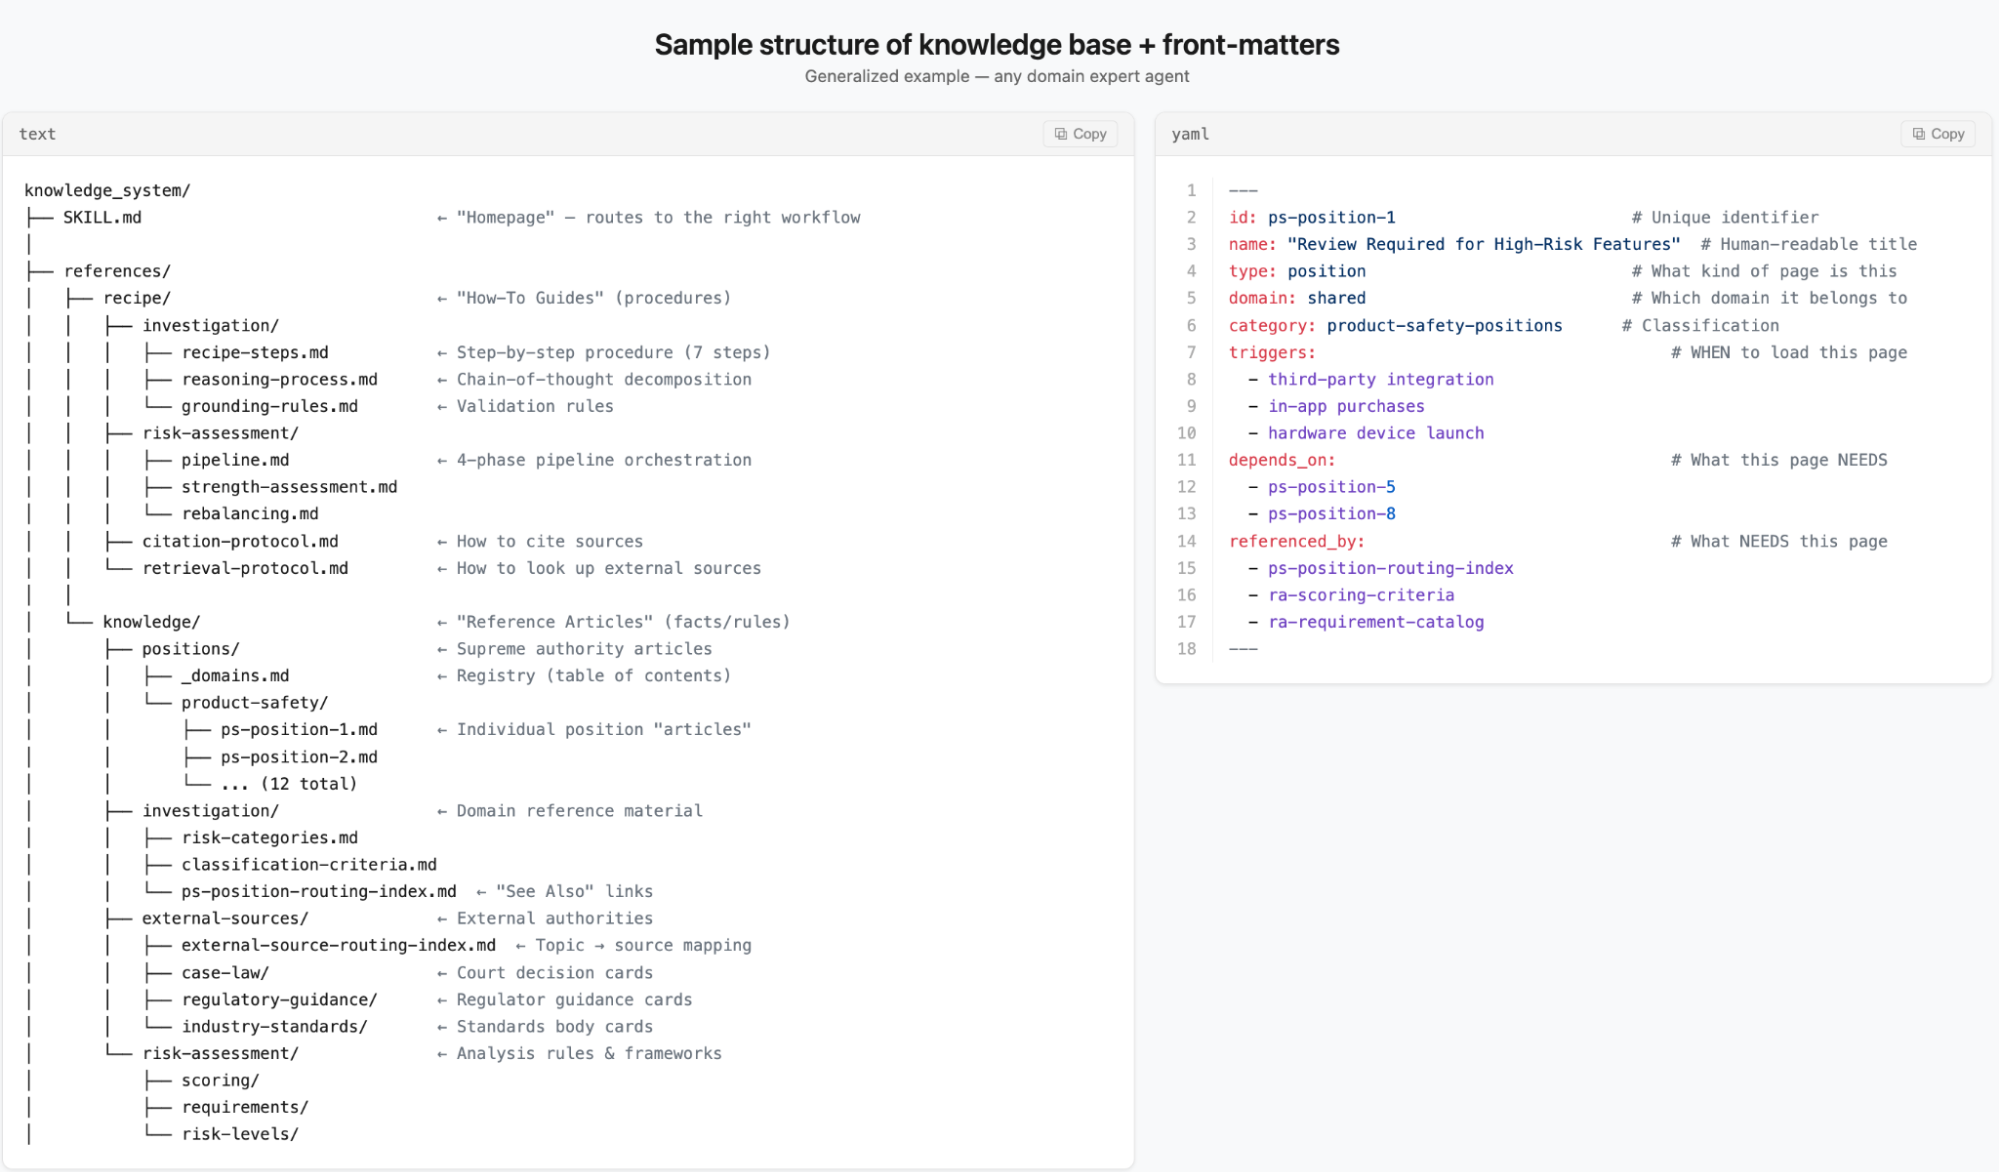
- ナレッジシステム(Knowledge System): 200以上のファイルをディレクトリ構造で管理し、組織の公式見解(Position)、用語定義(Taxonomy)、適用境界(Gateway)をYAMLメタデータ付きで定義。双方向の依存グラフ(depends_on / referenced_by)を構成する。
- 推論レイヤー(Reasoning Layer): ナレッジに定義された規則に基づき、専門家と同様の論理手順で審査や評価を実行する。
- 評価フレームワーク(Evaluation Framework): ルール変更や編集提案が既存の推論精度を損なわないか、回帰テスト(デグレ防止テスト)を自動実行する。
- 自己改善ループ(Improvement Loop): 人間専門家が下した修正やフィードバックをコンパイルし、ナレッジファイルを自動更新する。モデル自体の重み再学習を必要としない。
さらに知識の密度と参照頻度に応じて、コアな判断規範はファイルベースの構造化ナレッジ(Wiki)に常時保持し、個別事例や仕様書などの疎な情報はベクトル検索(RAG)で動的取得するハイブリッド設計を確立した。
従来アプローチとの比較
| 項目 | 従来型RAG | ファインチューニング | Meta「Second Brain」 |
|---|---|---|---|
| 知識の更新方法 | 検索インデックスの再生成 | モデルの追加学習(重み更新) | ファイル構造の自動編集 |
| 推論の一貫性 | 断片取得によるブレが生じやすい | 壊滅的忘却(破滅的忘却)のリスク | 厳密なルールと依存グラフで担保 |
| 専門家フィードバック | プロンプト修正にとどまる | 大規模データセット作成が必要 | 回帰テストを経て即座に反映 |
| 監査可能性 | 低い(根拠の追跡が困難) | 極めて低い(ブラックボックス) | 高い(YAMLとGit風ファイルで追跡) |
分析・展望
生成AIの企業導入において、最大のリスクは「一般論の要約はできても、自社特有の判断規範に従えない」という点にある。Metaのアーキテクチャは、LLMの基礎能力を信頼しつつ、組織固有のコンテキストとガバナンスをファイルシステム上に分離・外出しする実践的な解法を示している。金融・法務・医療など、判断の根拠追跡と正確性が厳格に求められる業界において、組織ナレッジ管理の標準モデルとして波及していく可能性が高い。