Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年8月22日(土)のニュース一覧へ引用元:lmsys.org
LMSYS、SGLangの高速再起動機能を公開
LLM
オープンソース
インフラ
大規模言語モデル(LLM)の研究組織LMSYS(大規模モデルの評価やサービング基盤を開発する研究組織)は2026年8月21日、オープンソース推論エンジン「SGLang(LLM推論の高速化と柔軟な制御を実現するフレームワーク)」において、クラッシュや再起動時のダウンタイムを劇的に削減する「Fast Engine Recovery」フレームワークの第1フェーズ「Weight Cache Daemon」を公開した。
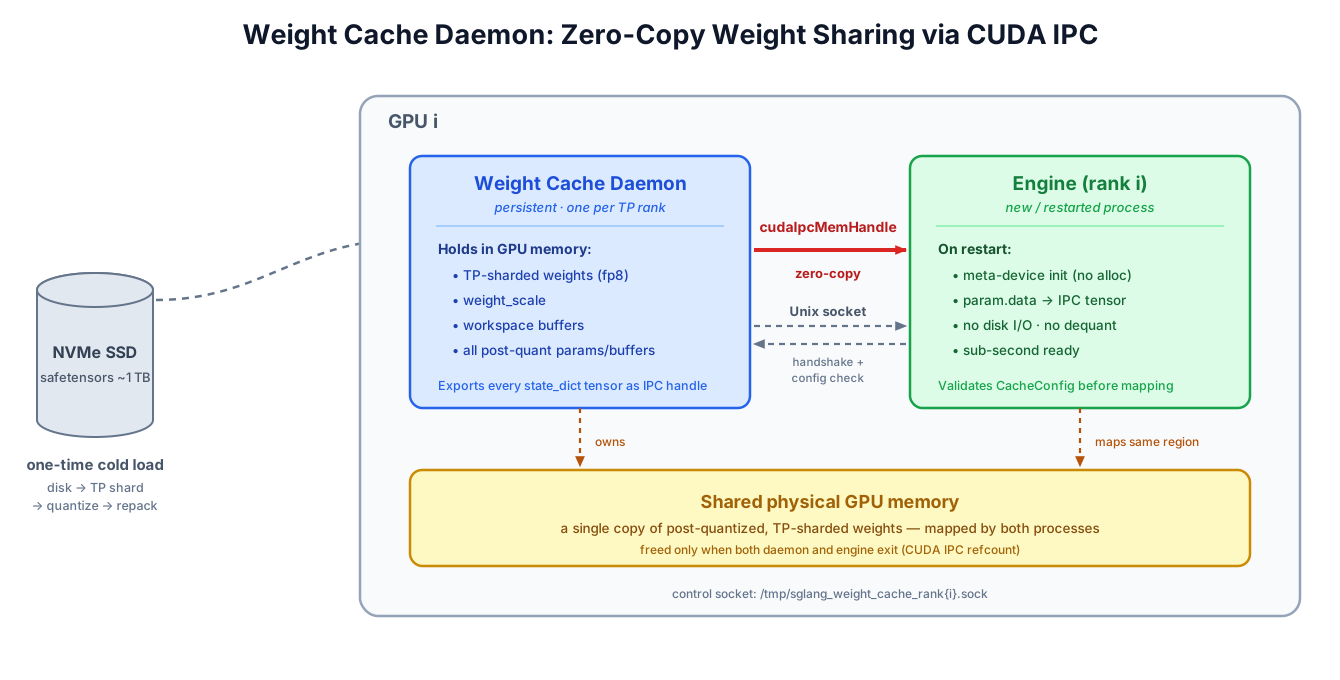
CUDA IPC Zero-Copyで重み読み込み時間を785倍高速化
フロンティアモデルの巨大化に伴い、エンジンのコールドスタート時間の93%以上をディスクからの重み読み込みと量子化処理が占めるようになっていた。
- Weight Cache Daemonの仕組み: 常駐GPUプロセスが事後量子化済みの重みをGPUメモリ上に保持。新規に起動したSGLangエンジンはCUDA IPC(プロセス間通信)のZero-Copyマッピング経由で重みを共有し、ディスクI/Oと再量子化を完全に排除する。
- 実測性能: 1兆パラメータ級の「Ling-2.6-1T FP8」モデルにおいて、重み読み込み時間が従来の約495秒から約0.63秒へと短縮(約785倍の高速化)。エンドツーエンドの起動時間も8.8分から約31.7秒(0.528分)へと93.9%削減された。
- アクティブ/スタンバイの即時フェイルオーバー: アイドル状態の予備インスタンス専用にGPUを占有することなく、同一GPU上のZero-Copy共有により1秒未満での高速切り替えが可能。
- マルチノード対応: 単一ノードだけでなく、大規模モデル向けのマルチノード分散配置(TP+PP)にも対応する。
起動フェーズ別の所要時間と短縮効果
Ling-2.6-1T FP8モデル(8×H20 GPU環境)におけるSGLangエンジン起動プロファイルとWeight Cache Daemon適用後の比較は以下の通りである。
| 起動フェーズ | 従来所要時間 | Daemon適用後 | 短縮・改善内容 |
|---|---|---|---|
| トークナイザー・設定初期化 | 約14秒 | 約14秒 | 今後Lazy初期化等で改善予定 |
| 分散通信(NCCL)初期化 | 約5秒 | 約5秒 | プロセスグループ永続化を計画 |
| 重み読み込み(ディスクI/O・量子化) | 約495秒(93.9%) | 約0.63秒 | CUDA IPC Zero-Copyにより785倍高速化 |
| キャッシュ・CUDAグラフ・準備 | 約13秒 | 約13秒 | グラフシリアライズ等を計画 |
| 合計エンジン起動時間 | 約527秒(約8.8分) | 約32秒(0.53分) | 全体で93.9%の起動時間削減 |
分析と展望:プロダクションLLM運用のSLAと可用性の革新
商用環境におけるLLMサービングでは、エンジン障害時のP99レイテンシ急増やSLA違反が深刻な運用課題となっていた。Weight Cache Daemonにより、GPUリソースを倍増させることなくサブ秒級のフェイルオーバーとローリングアップデートが可能になる。LMSYSは今後、CUDAグラフの永続化やKVキャッシュの引き継ぎ機能を実装し、コールドスタート10秒未満・ウォームスタンバイ1秒未満の完全達成を目指す方針である。
引用元:lmsys.org