Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年8月13日(木)のニュース一覧へ引用元:GIGAZINE
Google、手話をテキストに変換するAIモデル「SL2T」を発表
Google
DeepMind
マルチモーダル
研究
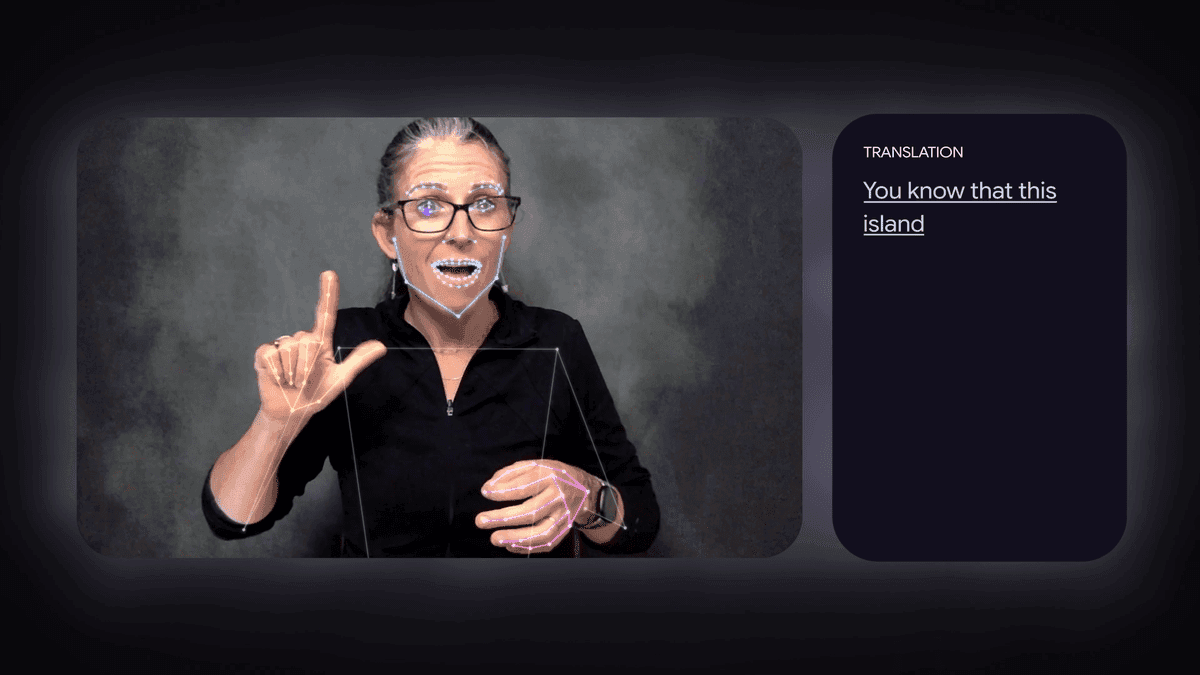
Google DeepMindの手話研究チームは、カメラで捉えた手話の映像をリアルタイムで文字データへ変換する「多言語手話・テキスト変換(SL2T(Sign Language to Text。手話の映像を言語テキストにリアルタイム変換するAI技術))」モデルを発表しました。
50以上の手話言語と10万時間超のデータで学習したリアルタイムモデル
SL2T(Sign Language to Text)は、50種類以上の手話言語に及ぶ10万時間超の映像データセットを用いて訓練されたAIモデルです。手話を行う人物の体や指先の動きを高速かつ正確な座標系へ変換し、言語的な文法・語彙に基づいてテキストへと自動翻訳します。
従来の手話認識AIでは、高いフレームレートでの身体追跡や、手話を行っていない通常の身体動作に対する誤判定(ハルシネーション)、片手のみで手話を行う場合の認識精度の低下が技術的課題とされていました。SL2Tではストリーミング処理時のレイテンシ(遅延)を最小化すると同時に、これらの問題への対策を組み込むことで実用性を向上させています。
本機能は2026年8月20日発売予定の「Pixel 11」に標準搭載され、キーボードアプリ「Gboard」および自動文字起こしアプリ「Live Transcribe」上で追加費用なしで利用可能となります。初期バージョンではアメリカ手話(ASL)から英語への変換に対応します。
日本の読者への影響と未確認事項の整理
世界に推計7000万人存在するとされる聴覚障害者や難聴者にとって、音声認識ベースの入力ツールに頼らず、手話によって直接ウェブ検索、メッセージ作成、Geminiへの指示入力を行える環境が実現します。
一方、現状の発表内容からは以下の未確認事項が挙げられます。
- 日本手話(JSL)および日本語対応: 初期リリースはアメリカ手話(ASL)と英語のペアに限られており、日本手話や日本語への対応時期については明示されていません。
- 旧型Pixelおよび他端末への展開: 初期対応端末はPixel 11に限られており、旧世代のPixel端末や他のAndroidスマートフォンへの順次展開スケジュールは未定です。
モバイル入力インターフェースの発展と展望
これまでスマートフォンの入力支援は音声認識やフリック入力が中心でしたが、カメラによる視覚的認識とマルチモーダルAIの発展により、手話による直接入力が新たな標準インターフェースとして加わることになります。アクセシビリティ向上のみならず、人間とAIとの多様なコミュニケーション手段を開く重要な成果といえます。
引用元:GIGAZINE