Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年8月4日(火)のニュース一覧へ
NVLinkとUALinkの技術比較
NVIDIA
半導体
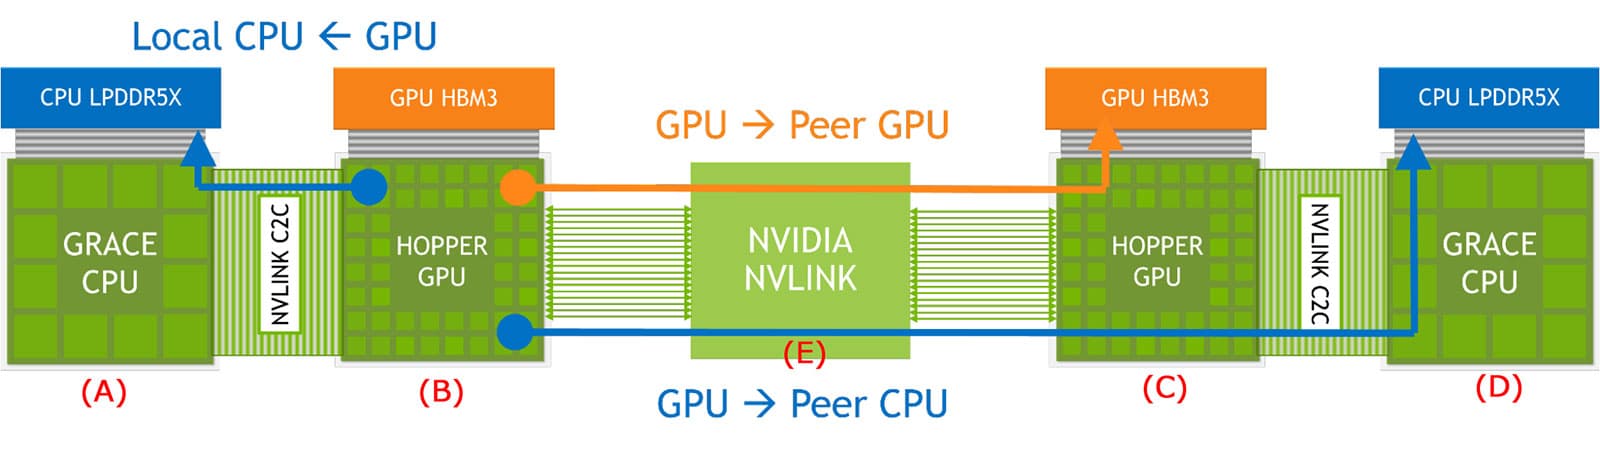
AI超大型クラスター構築における通信規格として、NVIDIAの「NVLink(NVIDIAのGPU間高速相互接続技術)」と、業界連合が推進するオープン規格「UALink(GPU/アクセラレータ間のオープン相互接続規格)(Ultra Accelerator Link)」の設計思想の違いが浮き彫りになっている。
NVLinkは世代を重ねるごとにプロセッサ間のメモリ共有を図り、ccNUMAやEGM(Extended GPU Memory)などのキャッシュコヒーレンシ保持機構を組み込んできた。
しかし、大規模GPU構成において全エントリのキャッシュコヒーレンシを厳密に維持しようとすると、Snoop処理などの制御オーバーヘッドが膨大になる課題を抱える。
これに対し、AMDやIntel、Broadcomらが主導するUALinkでは、複雑なキャッシュコヒーレンシ機構を意図的に排除するアプローチを採用した。
ロードおよびストア命令によるメモリ転送処理に特化させることで、コントローラの回路規模を小さく抑え、広帯域・低遅延なデータ転送効率を最優先している。
データセンターを導入する日本のクラウド事業者や研究機関にとっても、ベンダーロックインを伴うNVIDIAエコシステムと、オープンで低コストなUALink陣営の選択肢の比較が重要課題となっている。
NVLinkはプログラミングの容易性と統合環境で強みを持つ一方、UALinkは複数メーカーのアクセラレータ混在やコストパフォーマンスで優位性を持つ。
大規模言語モデルの学習・推論インフラが巨大化する中、スケールアップ・ネットワークの技術主導権を巡るハードウェア構造の競争が加速している。
引用元:INTERNET Watch