Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年7月29日(水)のニュース一覧へ
Anthropicの紙書籍大量スキャンに懸念の声
Anthropic
 引用元:GIGAZINE
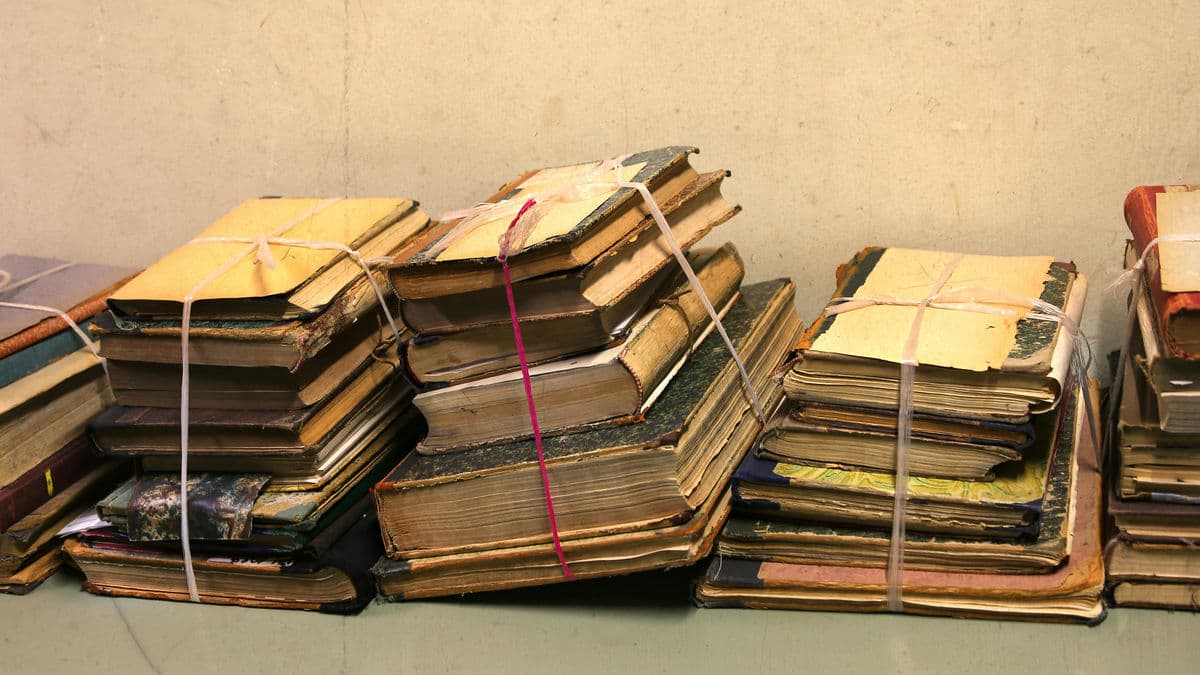
Anthropicと作家グループとの間で争われていた著作権侵害訴訟の和解に伴い開示された裁判資料から、AnthropicがAI「Claude(Anthropicの大型言語モデルシリーズ)」の学習データ収集目的で、数百万冊規模の紙の印刷書籍を購入・解体(裁断)してデジタルスキャンし、その原本を廃棄していた事実が明らかとなり波紋を呼んでいる。
裁判資料から判明した大量電子化の手法
開示された内部資料によると、Anthropicは海賊版電子書籍データの使用を避けるための「クリーンな学習データ取得策」として、物理的な書籍の大量購入と電子化を行っていた。
- 裁断と自動スキャン: 古書店や流通ルートから書籍を大量調達し、製本を解体して高精度スキャナでデジタル化。
- データ使用後の物理廃棄: スキャン完了後、スキャンデータのみを保持し、裁断された紙の原本は廃棄処分された。
- 希少本消失への懸念: 入手困難な古書や初版本まで裁断処理に含まれていた可能性があり、文化財・古書保護の観点から批判が噴出。
データ収集アプローチの比較
| データ収集手法 | 利点 | 課題・リスク |
|---|---|---|
| ウェブクローリング / 海賊版データ | 取得コストが極めて低い | 著作権侵害の直接的リスク |
| 物理書籍の購入・裁断スキャン | 正規購入データとして主張可能 | 物理的書籍の破壊・文化財失われへの批判 |
| 出版社との直接ライセンス契約 | 法的リスクが最も低い | 高額な契約費用と交渉コスト |
日本の読者への影響と未確認事項
日本国内でも国立国会図書館などによる電子化が進む一方、民間のAI開発企業が紙の書籍を大量裁断して学習させる行為についての法正当性や倫理性が議論される契機となる。日本の著作権法第30条の4(情報解析のための複製)との整合性も関心を集めている。
なお、イーロン・マスク氏をはじめとする他社関係者は「自社では物理的書籍の破壊を伴う収集は行っていない」と主張を展開している。
分析・展望として、AIの学習データ集めがWeb上のテキストから現実世界の物理媒体へと拡大する中で、著作権だけでなく文化資産の保全という新たな倫理的課題が浮き彫りになった。
引用元:GIGAZINE
引用元:GIGAZINE