Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年7月16日(木)のニュース一覧へ引用元:Cohere Labs
非英語コードでAI多言語モデルが向上
Cohere
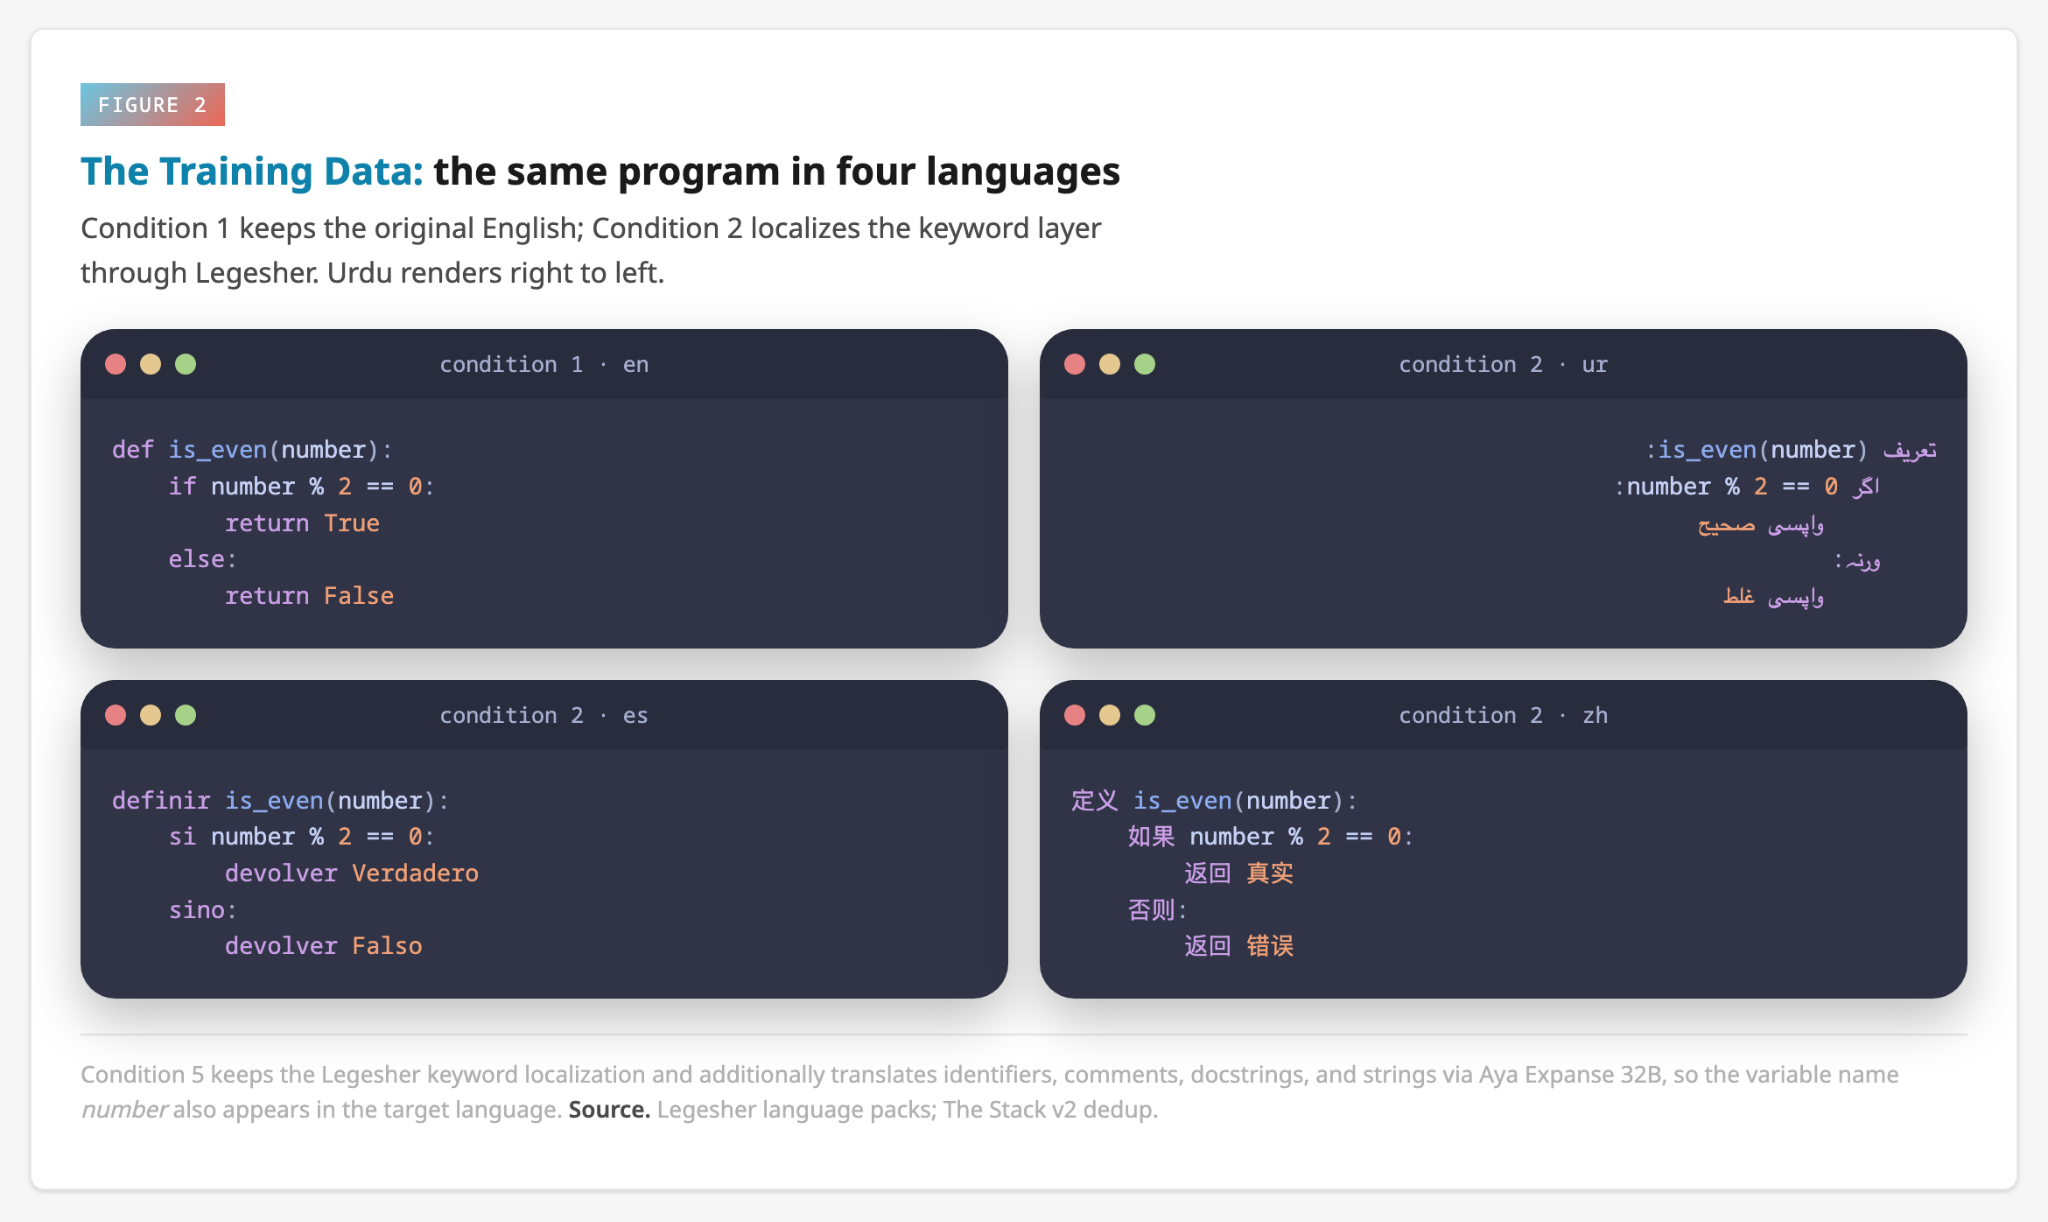
Cohere Labs Communityは、英語以外の言語で記述されたソースコードが、AIの多言語モデルの学習に与える影響についての研究結果を発表しました。予約語のローカライズや、非英語圏固有のプログラミング言語を用いた学習が、多言語モデルの推論性能やクロスリンガル能力の向上に有効であることが示されました。
予約語のローカライズで推論能力が向上
AIの学習データとして、コード(ソースコード)は論理的思考や指示追従能力を強化する「の」を補完する学習材料として機能することが知られていますが、これまでの研究はほぼ英語のコードに限定されていました。
本研究では、オープンソースのローカライズツール「Legesher」を使用し、Pythonの予約語(if、for、printなど)を中国語、スペイン語、ウルドゥー語に置換したデータで多言語モデル「Tiny Aya」を微調整(ファインチューニング)しました。
この結果、特に低リソース言語であるウルドゥー語において、読解力ベンチマークで+5.9ポイント、自然言語推論で+3.5ポイントなど、最も顕著な性能向上が確認されました。
ネイティブコードによるクロスリンガル転送
さらに、古典中国語風の文法を持つプログラミング言語「文言(Wenyan)」や「Qi」、スペイン語圏向けの「Latino」といった、英語を介さないネイティブなプログラミング言語で記述されたコードでも実験が行われました。
このネイティブコードによる学習は、対象言語だけでなく、英語や他の言語の推論タスクに対してもクロスリンガルな能力向上をもたらすことが確認されました。
日本の読者への影響と展望
日本の開発者や事業者にとっても、日本語の予約語やコメントを含むコードデータが、日本語対応のAIモデルの推論性能を底上げする強力な学習材料になり得ることを示唆しています。今後は、多言語コードのデータセット構築とローカライズ技術の進化が、非英語圏のAIモデル強化において重要な役割を果たすとみられます。