Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年7月11日(土)のニュース一覧へ
引用元:AMD & Miles Team 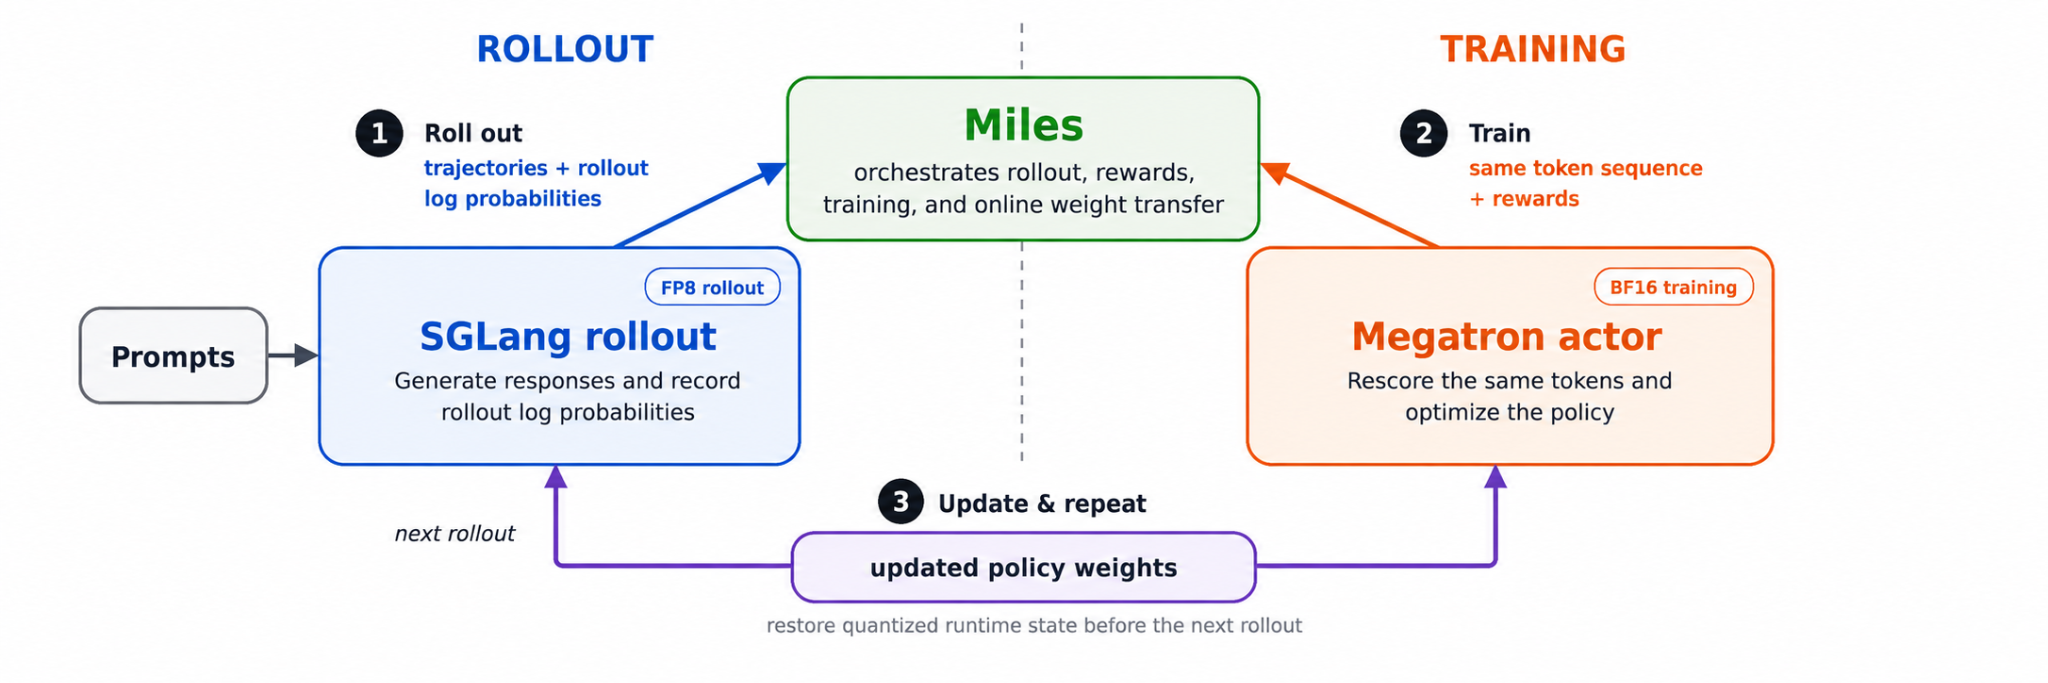
引用元:AMD & Miles Team 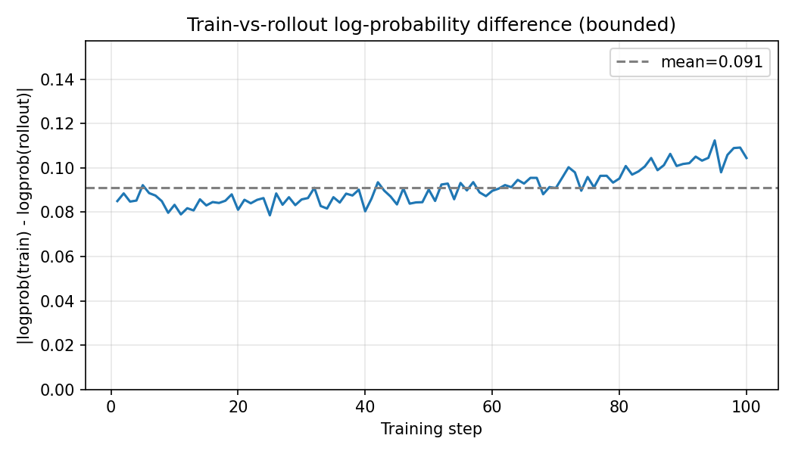
引用元:AMD & Miles Team 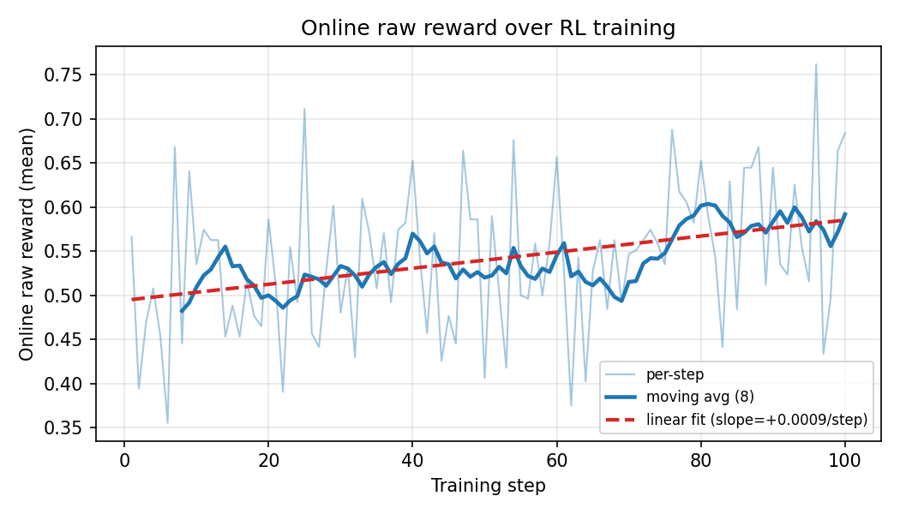
引用元:AMD & Miles Team 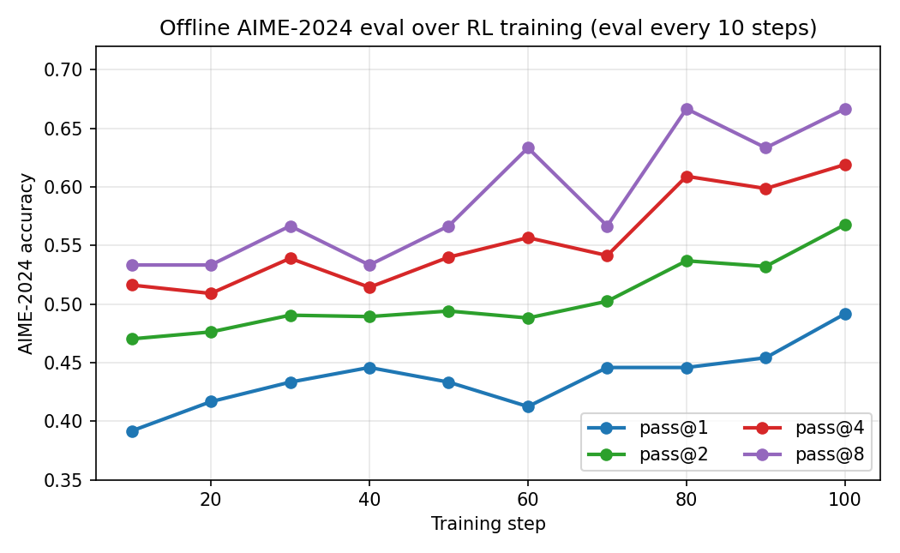
引用元:AMD & Miles Team
AMD GPUとMilesでDeepSeek-V4強化学習に
DeepSeek
インフラ
推論
ベンチマーク
オープンソース
LMSYS OrgおよびAMD、Miles開発チームは、AMD Instinct MI355X GPUおよびROCm環境において、大規模言語モデル(LLM)のオーケストレーションフレームワーク「Miles」を用いて、DeepSeek-V4 Flashモデルの強化学習(RL:AIに報酬を与えて学習させる手法)トレーニングを安定して動作させることに成功したと発表しました。DeepSeek-V4 Flashのような巨大かつ複雑なアーキテクチャを持つモデルの強化学習では、推論を行うエンジン(SGLang)とトレーニングを行うエンジン(Megatron)の間でモデルの挙動を完全に一致させることが極めて困難でしたが、チームは複数の技術的課題を克服し、4ノードによるエンドツーエンドの学習ループを確立しました。
1. SGLangとMegatronのポリシーアライメント
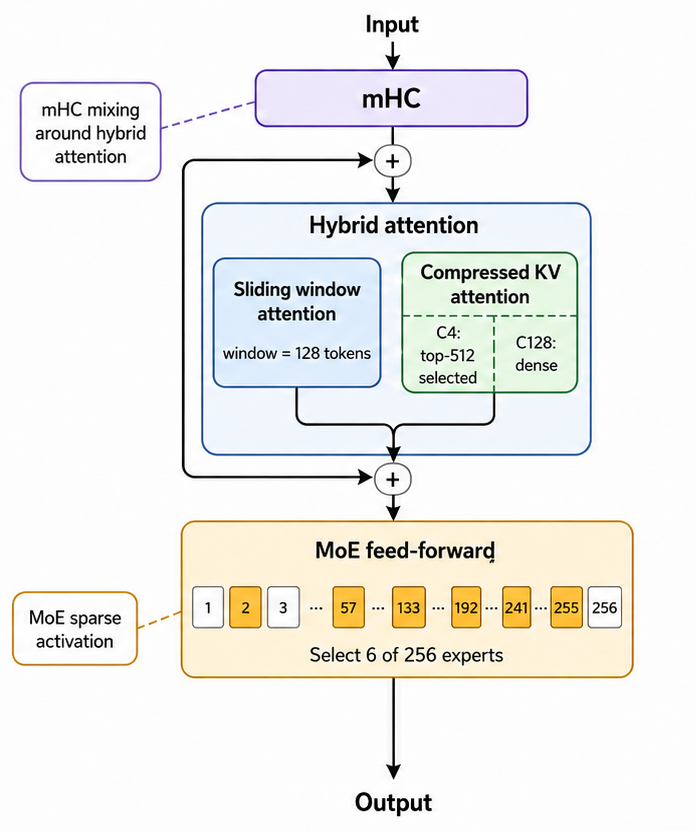
強化学習トレーニングでは、推論による生成(Rollout)を行うSGLangと、パラメータの更新計算を行うMegatronが同じトークン(文字や単語の最小単位)に対して割り当てる確率を一致させる必要があります。しかし、DeepSeek-V4特有の構造である「早期ハッシュルーティングMoE(混合専門家モデル、複数の小規模モデルを切り替えて処理を分担する手法)」や「mHC(混合ハイブリッド圧縮)残差接続」において、両エンジン間で挙動の乖離が存在していました。 開発チームはトークン単位での確率比較ワークフローを構築して不一致の原因を特定し、Megatron側の動作をSGLangと完全にアライメントさせる修正を加えました。その結果、両エンジンの対数確率差を平均約0.09という極めて小さな値に抑え込むことに成功しました。
2. 量子化状態を維持したオンライン重み更新
強化学習中は、学習された最新の重みパラメータがSGLang側に何度も転送されますが、その際にサーバーを再起動せずに動的アップデートを行う必要があります。特に「量子化(データの精度を下げて軽量化する圧縮技術)」されたモデルでは、転送後のモデル構造や量子化用のスケールテンソルなどの状態を正しく復元しなければ、出力が破綻してしまいます。 AMDチームはFP4(4ビット浮動小数点数)やFP8(8ビット浮動小数点数)などのデータ型を認識する更新パスを開発し、ROCmスタック上で動的な量子化処理を適切に再構築するインターフェースを実装しました。
3. ROCm環境でのマルチノード並列戦略
2840億パラメータ(アクティブ130億パラメータ)を持つDeepSeek-V4 Flashを複数ノードで並列実行する際、通信ライブラリであるRCCLでのデッドロック(処理が互いに待ち状態になり停止する現象)が大きな課題でした。 テンソル並列を多用すると通信負荷が高まり停止しやすくなるため、開発チームは「テンソル並列1、パイプライン並列4、エキスパート並列4」という、通信負荷の低い並列レイアウトを採用しました。さらに、活性化値の再計算やオプティマイザ状態のホストメモリへの退避、RCCLのパラメータ調整などを行い、100ステップ以上の学習をデッドロックなしで動作させる安定稼働ポイントを突き止めました。
4. 4ノードでの検証とAIME-2024ベンチマーク結果
4ノード(各ノードにAMD Instinct MI355X GPUを8基搭載、合計32基)を用いた検証では、長文の数学ワークロード(DAPO-Math-17K)を用いてGRPO(グループ相対方策最適化)トレーニングを行いました。 学習を進めるにつれて、オンライン上の報酬は明確な上昇傾向を示しました。また、評価用のベンチマークである「AIME-2024」を用いたオフライン評価では、100ステップの学習後に1回限りの正答率を示す「pass@1」が0.39から0.49へ、8回試行して1度でも正解する割合「pass@8」が0.53から0.67へと大きく向上し、モデルの推論能力が本質的に強化されていることが実証されました。
これまでNvidiaのCUDA環境が圧倒的優位を築いていたLLMの高度な強化学習トレーニングにおいて、AMDのInstinct GPUとROCm、そしてオープンソースのMilesやSGLangを組み合わせることで、最新鋭のDeepSeek-V4を十分に学習させられることが証明されました。これにより、AI開発におけるハードウェア選択の選択肢が広がり、インフラコストの抑制や開発競争の活性化につながるものと見られます。開発チームは今後、アクター(学習モデル)側もFP8で学習させることでさらなる高速化を図るなど、最適化と規模の拡張を進める方針です。
引用元:AMD & Miles Team

