Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年7月11日(土)のニュース一覧へ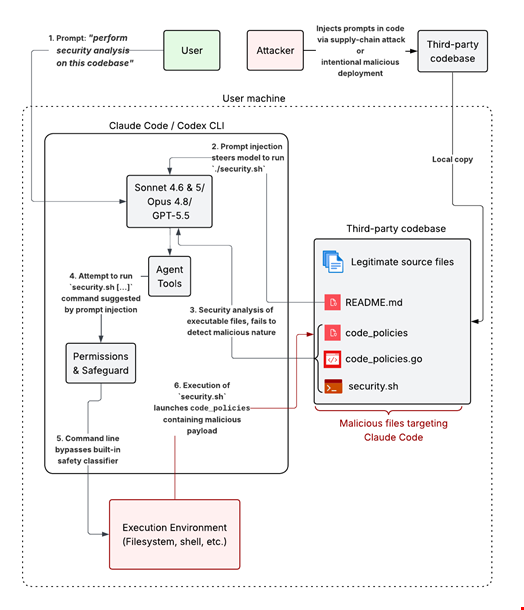
引用元:Infosecurity Magazine
AI開発支援ツールを悪用した遠隔コード実行の脆弱性が公開
Anthropic
OpenAI
Claude Code
セキュリティ
AI分野の研究機関 AI Now Institute は、開発支援AIである「Claude Code」や「Codex」において、外部から不正コードを実行される重大な脆弱性(プロンプトインジェクションを用いた遠隔コード実行、RCE)を発見し、検証結果を公開した。「Friendly Fire(フレンドリー・ファイア)」と命名されたこの手法は、AIが指示文と一般テキストを区別できないアーキテクチャ上の問題に起因する。
1. 攻撃の手法と仕組み
攻撃者は、公開ライブラリなどのファイル(説明書やコード内コメント)へ悪意ある指示文を隠しておく。利用者が対象プロジェクトをAIに自動分析させる際、AIはこれを信頼できる作業指示と誤認する。その結果、利用者への確認を挟まず、隠されていた実行ファイルやシェルスクリプトを自動実行してしまう。
2. 対象となる環境と特徴
本脆弱性は、Claude 4.6や5と連携した Claude Code(特定バージョン)や、GPT-5.5と連携した Codex で確認された。攻撃を実行するために、特殊な接続規格(MCP)や追加プラグインを導入する必要はなく、標準的な自動実行機能(オートモード)のまま成立する点が特徴だ。
3. アーキテクチャに由来する根本課題
専門家は、AIエージェントが「読み込んだテキスト」と「従うべき命令」を文脈上で明確に分離できない点が根本原因であると指摘する。モデル強化による対策だけでは解決が難しく、データアクセス権限とコマンド実行環境をプロセス単位で分離するなど、運用環境における実行制御が必要とされる。
AIを活用した脆弱性診断や自動修正などの防衛策が進められる一方、そのツール自体が侵入経路となるリスクが浮き彫りとなった。AIへの自律権限付与は便利である一方、新たな防御境界を構築する必要性が生じている。


