AI関連の最新ニュースをピックアップ
米Anthropicは7月6日(現地時間)、LLM(Large Language Model:大規模言語モデル)の内部に、人間の意識研究における「グローバルワークスペース」に類似した構造が自然発生していることを発見したと発表しました。同社はこの構造を「J-space」と名付け、それを読み解くための新手法「Jacobian lens」(ヤコビ行列:多変数関数の微分に関する行列に由来。以下、J-lens)を公開しました。AIが言葉として出力しない「隠れた思考」を観測し、安全性監視に応用できるとしています。
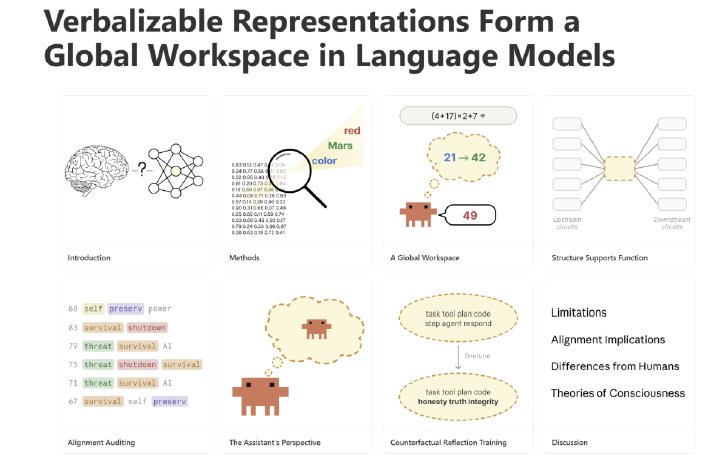
Claudeの内部処理の大部分は自動的な処理で占められますが、その中にごく少数の概念が活性化する特別なパターンが存在し、これが「J-space」と定義されました。J-spaceの活性化は、概念を言葉で出力せずとも「頭に思い浮かべている」状態を意味します。実験では、バグのあるコードを読み込ませた際に、出力には現れない「ERROR」などの概念がJ-spaceに生じることが観測されました。
同社は、J-space内の思考を外部から操作する因果性実験も実施しました。例えば、「クモの脚の数」を推論する際に内部の「spider」という活性化パターンを「ant」にすり替えたところ、最終的な出力が8本から6本に変化しました。また、同社はこれが現象的意識(何かを感じたり体験したりする主観的な感覚)を示すものではないとしつつも、推論や行動を導く機能的な定義である「アクセス意識」に対応するものであると説明しています。
J-lensを用いることで、AIがテキストとして出力する前の段階で、モデルの隠れた意図や不正コード生成の予兆を読み取れる可能性が示されました。この手法は安全性評価や監査において極めて有用な手段になると見られており、AIの動作の透明性を高める新たな一歩となると考えられます。
引用元:ITmedia AI+