Daily AI Newsbites
AI関連の最新ニュースをピックアップ
← 2026年7月1日(水)のニュース一覧へ
OpenAI、計算生物学向け高難度ベンチマーク「GeneBench-Pro」発表
OpenAI
研究
ベンチマーク
OpenAIは、AIエージェントが計算生物学(computational biology)分野において、データの不確実性や曖昧さに対処し、高度な科学的判断を下せるかを測定する新たなベンチマーク「GeneBench-Pro」を発表しました。本ベンチマークは、ゲノミクスやトランスレーショナル医学などの領域を横断する129個の複雑な課題で構成されており、単なる知識の暗記や定型的な処理ではなく、研究プロセスにおけるシステムレベルの判断能力(Research Taste)を厳格に評価します。
1. 「Research Taste(研究センス)」を評価するデータ設計
従来のベンチマークでは、分析プロセスの良し悪しを客観的に評価することが困難でした。GeneBench-Proは、データの生成プロセス自体を合成シミュレーションして完全な因果構造を定義することにより、モデルごとの解答の正確性を決定論的に採点できるよう設計されています。外部専門家(大学院生、ポスドク、産業界の科学者など)82名によるレビューが行われ、「経験豊かな指導教官のフィードバックなしには、大学院生であっても自力で完了するのは困難な難易度」と評されています。
2. GPT-5.6 Solなどのフロンティアモデルの評価結果
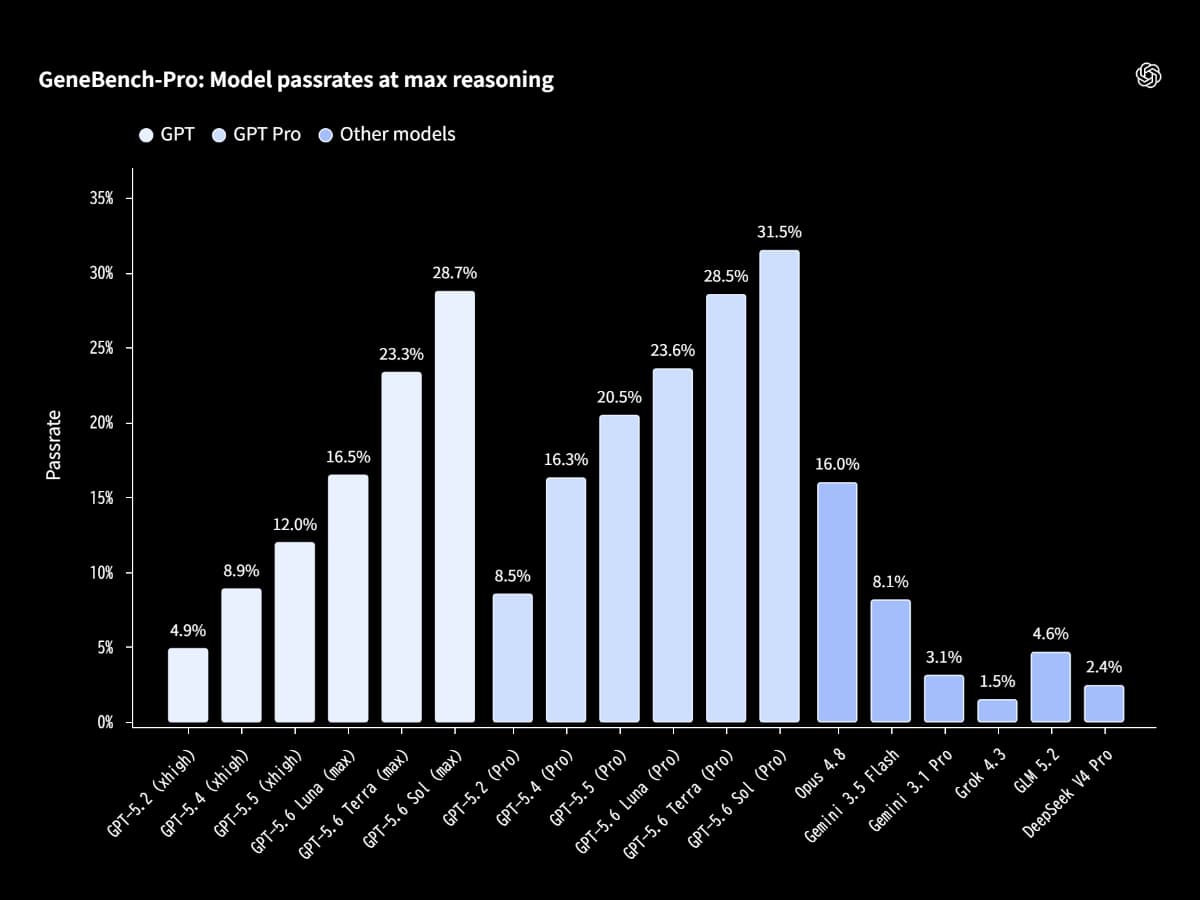
OpenAIの最新かつ最強の推論モデルである「GPT-5.6 Sol」は、最高推論レベルにおいて28.7%(Proモード有効で31.5%)の合格率を達成しました。これは、開発初期のGPT-5が記録した5%未満というスコアから大幅な向上を示しています。また、GPT-5.6 SolはGPT-5.2と比較して、トークン消費量を約3分の2に削減しながらも、約6倍多くの課題を解決しました。GLM 5.2などの主要なオープンソースモデルと比較しても、科学的推論力において大きな性能差を示しています。
ゲノム解析などのデータ生成コストが低下する一方で、現在は「大量のデータからいかに有用な科学的洞察を導き出すか」という分析フェーズが研究のボトルネックになっています。GeneBench-Proのような高度な判断を要する分析タスクをAIエージェントが自律的にこなせるようになれば、創薬研究の優先順位付けや検証のサイクルは劇的に加速します。現在でも人間の専門家が20〜40時間(数千ドル相当)要するタスクを、AIはわずか数ドルの推論コストで部分的に代替可能になりつつあり、今後科学研究プロセス全体の自動化と効率化をもたらすことが期待されます。
引用元:OpenAI | gigazine.net | PC Watch
参考ソース
GIGAZINE
OpenAIがAIの科学能力を測定するベンチマークテスト「GeneBench-Pro」を発表
データを確認したAIが、そのデータがノイズなのか有意なものなのかを判断した上で解析を行えるかどうかを測る計算生物学のベンチマーク「GeneBench-Pro」がOpenAIから発表されました。このベンチマークで測定した上でAIを改善していけば、科学的発見を大幅に加速できる可能性があると期待されています。
https://gigazine.net/news/20260701-genebench-pro
PC Watch
OpenAI、科学研究でのAIの判断力を評価する新ベンチ
OpenAIは6月30日、計算生物学の分野におけるAIの推論能力や判断力を評価する新たなベンチマーク「GeneBench-Pro」を発表した。
https://pc.watch.impress.co.jp/docs/news/2122022.html


